张
155. 和科沃斯钱程聊,父与子、企二代接班的样本与肌理、机器人,和我内心的追寻
10 月 21 日 · 2 小时
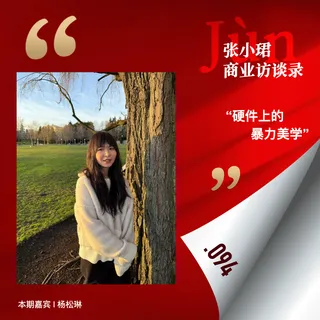
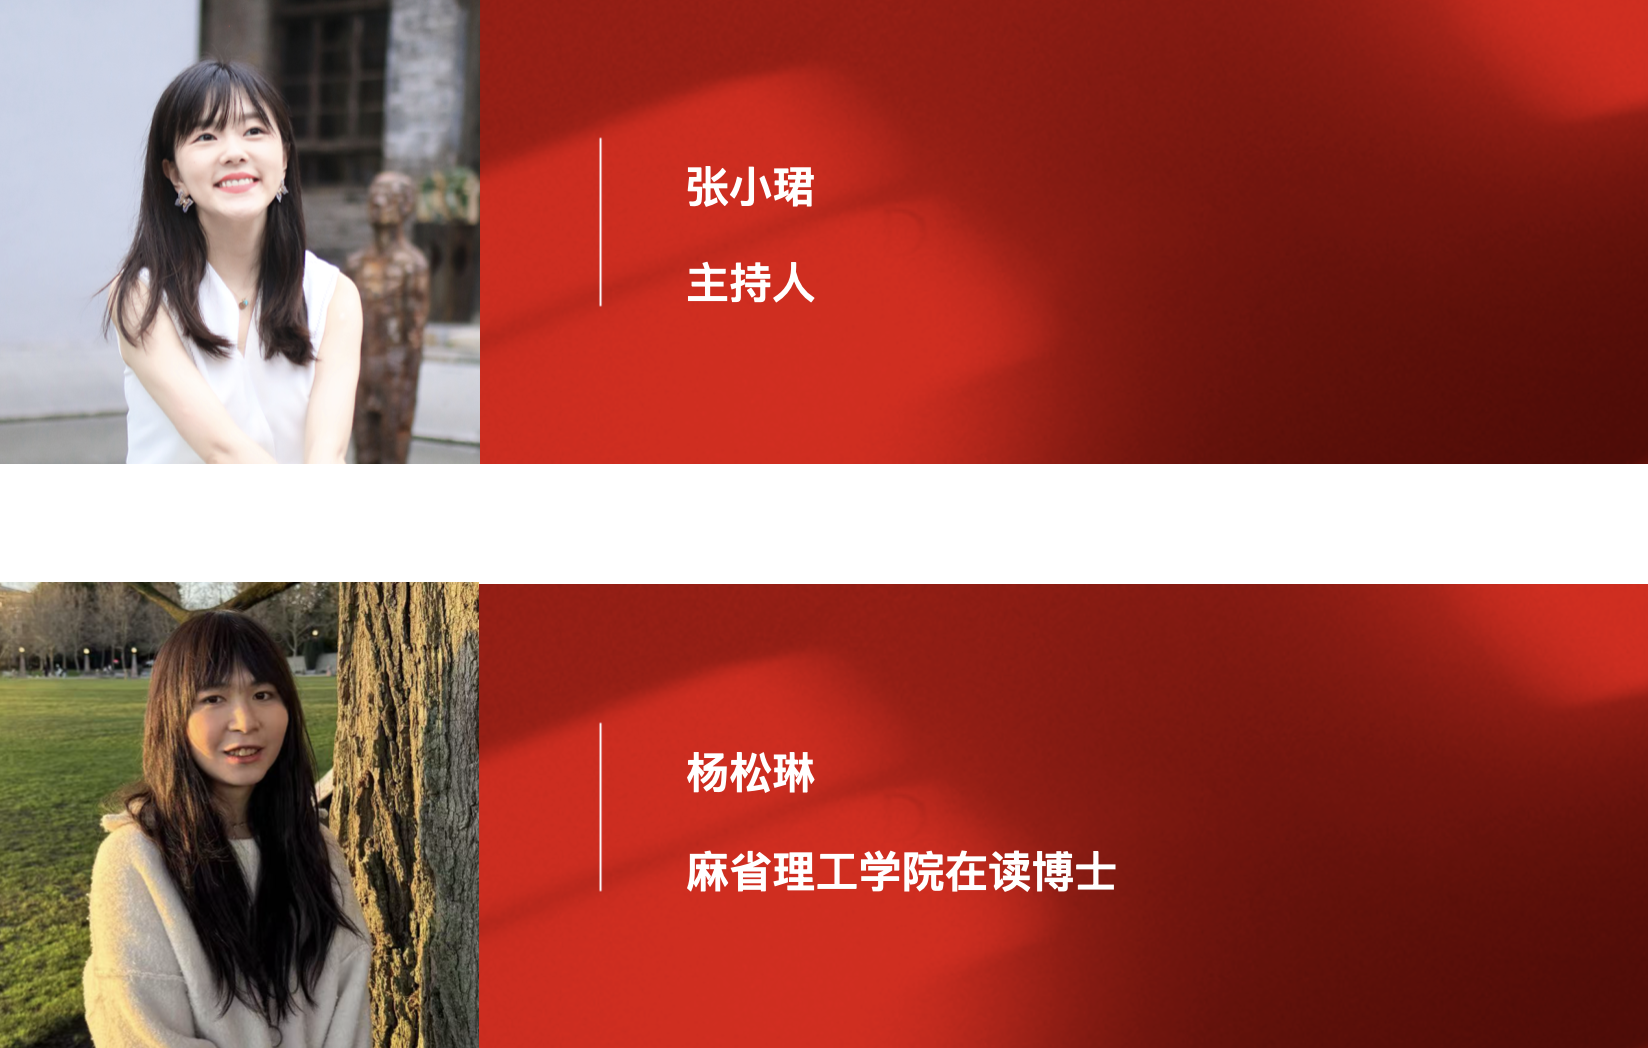
今天这集节目延续我们的论文系列。我邀请MIT计算机科学与人工智能实验室的在读博士松琳,来给大家解读上个星期DeepSeek和Kimi发布的全新技术报告。
DeepSeek和Kimi又一次技术对垒。在同一天发布论文,两篇集中在改进注意力机制以处理长文本任务上。而春节前,MiniMax也发布了一篇注意力机制相关的论文。
松琳将带领大家阅读这3篇注意力机制有关的文章,解析不同模型公司的技术哲学和路线选择。
我们希望能让更多人领略AI科技平权,体验技术之美。
2025,我们和AI共同进步!
(如果如果,你觉得光听还不够刺激,觉得一定要坐在电脑前看着投屏、拿起纸笔学习更有沉浸感…如果你实在是真心想要找虐的话…请前往:含投屏的视频版本。预祝你学习顺利啦!)
我们的播客节目在腾讯新闻首发,大家可以前往关注哦,这样可以第一时间获取节目信息和更多新闻资讯:)
讲解开始前,先提问几个小问题
DeepSeek最新论文《Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention》讲解
论文中文名:《原生稀疏注意力:硬件对齐且原生可训练的稀疏注意力》
路线:稀疏注意力机制
本篇工作最大亮点:Native Sparse Attention 全线压制 Full Attention
Kimi最新论文《MoBA: Mixture of Block Attention for Long-Context LLMs》讲解
论文中文名:《MoBA:面向长文本上下文的块注意力混合架构》
路线:稀疏注意力机制
MiniMax春节前的论文《MiniMax-01: Scaling Foundation Models with Lightning Attention》讲解
论文中文名:《MiniMax-01:利用闪电注意力扩展基础模型》
路线:线性注意力机制
最后强化学习一下
【技术之美】系列:
逐句讲解DeepSeek-R1、Kimi K1.5、OpenAI o1技术报告——“最优美的算法最干净”
逐篇讲解DeepSeek关键9篇论文及创新点——“勇敢者的游戏”
【更多信息】
联络我们:微博@张小珺-Benita,小红书@张小珺
更多信息欢迎关注公众号:张小珺
说明里标出的时间点,点一下跳过去
155. 和科沃斯钱程聊,父与子、企二代接班的样本与肌理、机器人,和我内心的追寻
10 月 21 日 · 2 小时
154. 对Dyna创始人Lindon的3小时访谈:机器人世界的迷雾、分歧与抉择,修心、《沉思录》与王阳明
10 月 15 日 · 2 小时 51 分
153. 和曾鸣聊产业史观:残酷的真相、会消亡的公司、优秀≠卓越、“OAI、Anth大概率不是原生时代大赢家”
9 月 3 日 · 2 小时 34 分
152. 领读Kimi K3技术报告:从架构创新聊起,注意力美学、多教师蒸馏和开源MoE
8 月 26 日 · 2 小时 04 分
张小珺Jùn|商业访谈录 · 2025 年 2 月 24 日 · 2 小时 36 分
今天这集节目延续我们的论文系列。我邀请MIT计算机科学与人工智能实验室的在读博士松琳,来给大家解读上个星期DeepSeek和Kimi发布的全新技术报告。
DeepSeek和Kimi又一次技术对垒。在同一天发布论文,两篇集中在改进注意力机制以处理长文本任务上。而春节前,MiniMax也发布了一篇注意力机制相关的论文。
松琳将带领大家阅读这3篇注意力机制有关的文章,解析不同模型公司的技术哲学和路线选择。
我们希望能让更多人领略AI科技平权,体验技术之美。
2025,我们和AI共同进步!
(如果如果,你觉得光听还不够刺激,觉得一定要坐在电脑前看着投屏、拿起纸笔学习更有沉浸感…如果你实在是真心想要找虐的话…请前往:含投屏的视频版本。预祝你学习顺利啦!)
我们的播客节目在腾讯新闻首发,大家可以前往关注哦,这样可以第一时间获取节目信息和更多新闻资讯:)
讲解开始前,先提问几个小问题
DeepSeek最新论文《Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention》讲解
论文中文名:《原生稀疏注意力:硬件对齐且原生可训练的稀疏注意力》
路线:稀疏注意力机制
本篇工作最大亮点:Native Sparse Attention 全线压制 Full Attention
Kimi最新论文《MoBA: Mixture of Block Attention for Long-Context LLMs》讲解
论文中文名:《MoBA:面向长文本上下文的块注意力混合架构》
路线:稀疏注意力机制
MiniMax春节前的论文《MiniMax-01: Scaling Foundation Models with Lightning Attention》讲解
论文中文名:《MiniMax-01:利用闪电注意力扩展基础模型》
路线:线性注意力机制
最后强化学习一下
【技术之美】系列:
逐句讲解DeepSeek-R1、Kimi K1.5、OpenAI o1技术报告——“最优美的算法最干净”
逐篇讲解DeepSeek关键9篇论文及创新点——“勇敢者的游戏”
【更多信息】
联络我们:微博@张小珺-Benita,小红书@张小珺
更多信息欢迎关注公众号:张小珺
说明里标出的时间点,点一下跳过去
https://feed.xyzfm.space/dk4yh3pkpjp3复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
155. 和科沃斯钱程聊,父与子、企二代接班的样本与肌理、机器人,和我内心的追寻
10 月 21 日 · 2 小时
154. 对Dyna创始人Lindon的3小时访谈:机器人世界的迷雾、分歧与抉择,修心、《沉思录》与王阳明
10 月 15 日 · 2 小时 51 分
153. 和曾鸣聊产业史观:残酷的真相、会消亡的公司、优秀≠卓越、“OAI、Anth大概率不是原生时代大赢家”
9 月 3 日 · 2 小时 34 分