卫
92.【番外】财富是诅咒,围猎顶级富人的 100 种方式|黄仁勋事件有感
11 月 10 日 · 1 小时 26 分
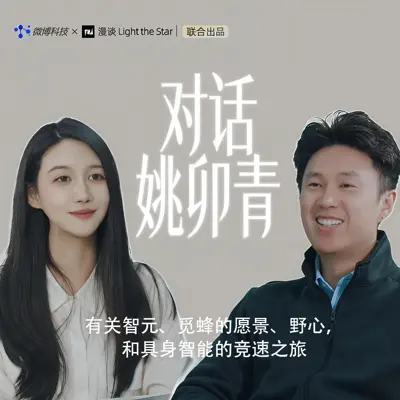
2026 年,具身智能成为了聪明人扎堆、资本热潮近乎疯狂的行业。这条热门赛道中,智元机器人是最早的百亿俱乐部成员之一。
在人形机器人出货量狂奔的路上,智元的野心并不止于“具身本体”的军备竞赛。今年,他们做出了一个让全行业瞩目的反哺举措:将旗下的核心数据资产彻底剥离,独立孵化了全球领先的一站式物理 AI 数据服务平台——“觅蜂”。
本期嘉宾姚卯青,不仅是智元合伙人、具身业务部总裁,也兼任觅蜂的董事长兼CEO。这期播客在五月觅蜂发布会后录制,或许是有关智元战略的,最深入完整的一次访谈。

(本期视频的微博开屏页,欢迎前往微博等平台观看视频版~;也欢迎前往公众号,查看「漫谈Light the Star」访谈的文字版~)
从Waymo到蔚来再到智元,姚院亲历过自动驾驶从概念到量产的全过程,他说“今天的具身智能连GPT1都没到”,而机器人离真正涌现智能,还差一亿小时的数据。
本期嘉宾: 姚卯青(智元合伙人、通用业务部总裁, 觅蜂董事长兼 CEO)
「人间清醒」与「顺势而为」
清华电子系的系统训练:电路、通信、信号处理、计算机视觉、编程和算法,都是自动驾驶和具身智能的底层能力
Google Display Ads 团队:计算机视觉、NLP 与 Transformer
内部转岗 Waymo:可能是当时全球最难的面试
Waymo 的三年: Robotaxi, 从技术 demo 走向商业化运营
为什么选择蔚来? 「单平台、全标配」的产品策略,激光雷达、4K 相机和高算力硬件一体的统一底座
蔚来李斌:「被人骂也是被记住的一种方式」——做关键决策需要勇气
多模态融合感知、激光雷达感知、BEV、Occupancy Network、AEB …关于自动驾驶的种种
选择回国:相比 Waymo 的几百辆 Robotaxi,国内乘用车百万级保有量所带来的数据分布和 corner case 密度,是完全不同的飞轮
量产经验到底是什么?「不是把样机多复制几台,而是项目、研发、测试、供应链、质量、版本和数据闭环的组织能力。」
能迁移到机器人的是什么?异常数据回流、模型迭代和现场版本下发
自动驾驶派进入具身智能,最大的价值是理解强电系统、供应链、质量、量产和底层软件稳定性
机器人和车,在电子电气架构、操作系统、中间件、传感器输入到电机控制等底层工程上高度相通。
车就是最简单的机器人?「有点牵强」
在很多低速场景中,机器人反而更有机会部署 VLA、世界模型等前沿模型
真正稀缺的人才,不只是刷榜或发 paper 的人,而是上手修过 bug、和硬件软件都打过仗、能把复杂系统跑稳定的人
具身创业的三大派,都有不可替代性
机器人终局架构不会只是「快慢系统」两层,可能包含: 1000Hz 底层控制、10 到 20Hz 动作规划、1 到 2Hz 阶段目标规划,以及更高层的 Agent 长程推理。
「2026 年了,具身智能到底到 GPT 几了?其实 1 都没到呢」
「现阶段的真机数据量,和真正支撑基座模型涌现的数据规模,还差四五个数量级」
很多公司强调自己做「具身基模」,是借用了大语言模型时代的资本叙事
今天的具身更像 Transformer 和 BERT 早期,而不是 GPT-3 之后
数据的关键不仅是「量」,还包括信息维度、场景种类、失败样本和真实部署中的边界样本
多模态融合是必然趋势,视觉远远不够
真正的瓶颈不是算法是否足够聪明,而是真实世界数据的量、模态、场景和失败样本远远不够
神秘的邓泰华其人
智元Day 1 定位成 AI 公司,而非单纯的人形机器人公司
人形机器人是把 AI 带入物理世界的必要载体,但不是终点
「智元确实是这个行业里最有野心的公司之一」
智元的组织架构、融资节奏与股权激励
具身公司的长期价值不只在本体硬件,而在能否把「本体、数据、模型、场景」做成闭环。
精灵 G2 所经历的完整 IPD 流程:接近 9 个月
机器人行业的需求峰谷比汽车更剧烈
工业不相信眼泪,最终都是 ROI:「」工业客户不关心你是人形、猴形还是狗形」
智元的「358 战略」:从量产、商用到部署
具身智能最终不是单点技术竞赛,而是系统工程。
当技术路线逐步收敛、场景开始渗透时,先把 90% 的体系能力构建好,才可能真正承接行业机会。
智元的 AI 研发体系:模仿学习、VLA 预训练、世界模型、强化学习后训练和数据闭环
Google PaLM-E :VLA 来自语言模型和多模态语言模型向物理世界的迁移
世界模型更像对物理规律和状态转移的数字化、神经网络化描述
「VLA 和世界模型都不是最终形态,未来更可能是分层架构」:前者受限于语言和动作之间的表征鸿沟,后者仍更多来自二维视频和第三人称视角
:语言推理、物理预测、低层控制、长程规划和数据飞轮共同工作
世界模型的价值在于学习液体流动、玻璃破碎、软体形变等真实物理规律
「后训练和失败数据非常关键」
投资人的主意:对标上一轮 AI 时代的 Scale AI ?
具身数据生意比传统数字世界标注难得多
2026 :具身数据军备竞赛年
模型的差异化暂时不大,数据会是分水岭
打造一个公共性质的数据服务平台,一个「阳谋」:客户花钱带来数据需求,平台用数据训练模型,模型再反哺采集、预标注和质量管理效率
数据问题都没解决,讲基模预训练、后训练,都是空中楼阁
高质量数据的第一点是真实:场景和任务必须足够丰富,能够覆盖生活和生产中真正会遇到的问题
规范:相机曝光、画质、设备同步、轨迹重建精度、操作流程都要高标准
「脏数据」不是质量差的数据,而是包含失败、偏移、纠错、重新规划和最终成功的多样化数据
仿真数据并不天然低价值
关键不是流派,而是任务、场景、成功率要求和模型使用方式
数据的价格、产能和全球化
Deepmind 和 Genralist:「如果数据是具身智能竞争的唯一决定变量,中国公司现在就可以宣布他们是赢家」
As many as possible, as soon as possible(越多越好,越快越好).
好的数据标准会逐步收敛
即使不同机器人硬件不统一,很多数据仍可以被抽象为通用表达,如末端执行器轨迹、二维帧序列、物理状态变化等
机器人行业的安全和质量准入标准,会在两到三年内伴随大规模商用逐步出现。
从 G1 到 G5 ,当前行业大约处在 G3 到 G4 的中间态
预计 2027 到 2028 年行业有希望达到 1 亿小时级数据规模
真正类似语言模型那种涌现能力,还需到 1 亿小时级高质量数据出现
机器人出现真正的 aha moment:不再只是从画面到动作的肌肉映射,而是能在复杂环境里自主规划、理解指令、做出响应
涌现时刻大概率发生在实验室,而不是工厂
数据会成为这一轮智能化转型关键基础设施,但它比算力更难获取
加入听友群⬇️

说明里标出的时间点,点一下跳过去
92.【番外】财富是诅咒,围猎顶级富人的 100 种方式|黄仁勋事件有感
11 月 10 日 · 1 小时 26 分
10 月 14 日 · 40 分钟
9 月 29 日 · 1 小时 26 分
89.当 AI 进入组织,那些「从没人说过的真相」|与网易阮良聊 AI Native 与企业 Agent 实战
9 月 23 日 · 1 小时 15 分
卫诗婕|漫谈Light the Star · 6 月 16 日 · 2 小时 59 分
2026 年,具身智能成为了聪明人扎堆、资本热潮近乎疯狂的行业。这条热门赛道中,智元机器人是最早的百亿俱乐部成员之一。
在人形机器人出货量狂奔的路上,智元的野心并不止于“具身本体”的军备竞赛。今年,他们做出了一个让全行业瞩目的反哺举措:将旗下的核心数据资产彻底剥离,独立孵化了全球领先的一站式物理 AI 数据服务平台——“觅蜂”。
本期嘉宾姚卯青,不仅是智元合伙人、具身业务部总裁,也兼任觅蜂的董事长兼CEO。这期播客在五月觅蜂发布会后录制,或许是有关智元战略的,最深入完整的一次访谈。
(本期视频的微博开屏页,欢迎前往微博等平台观看视频版~;也欢迎前往公众号,查看「漫谈Light the Star」访谈的文字版~)
从Waymo到蔚来再到智元,姚院亲历过自动驾驶从概念到量产的全过程,他说“今天的具身智能连GPT1都没到”,而机器人离真正涌现智能,还差一亿小时的数据。
本期嘉宾: 姚卯青(智元合伙人、通用业务部总裁, 觅蜂董事长兼 CEO)
「人间清醒」与「顺势而为」
清华电子系的系统训练:电路、通信、信号处理、计算机视觉、编程和算法,都是自动驾驶和具身智能的底层能力
Google Display Ads 团队:计算机视觉、NLP 与 Transformer
内部转岗 Waymo:可能是当时全球最难的面试
Waymo 的三年: Robotaxi, 从技术 demo 走向商业化运营
为什么选择蔚来? 「单平台、全标配」的产品策略,激光雷达、4K 相机和高算力硬件一体的统一底座
蔚来李斌:「被人骂也是被记住的一种方式」——做关键决策需要勇气
多模态融合感知、激光雷达感知、BEV、Occupancy Network、AEB …关于自动驾驶的种种
选择回国:相比 Waymo 的几百辆 Robotaxi,国内乘用车百万级保有量所带来的数据分布和 corner case 密度,是完全不同的飞轮
量产经验到底是什么?「不是把样机多复制几台,而是项目、研发、测试、供应链、质量、版本和数据闭环的组织能力。」
能迁移到机器人的是什么?异常数据回流、模型迭代和现场版本下发
自动驾驶派进入具身智能,最大的价值是理解强电系统、供应链、质量、量产和底层软件稳定性
机器人和车,在电子电气架构、操作系统、中间件、传感器输入到电机控制等底层工程上高度相通。
车就是最简单的机器人?「有点牵强」
在很多低速场景中,机器人反而更有机会部署 VLA、世界模型等前沿模型
真正稀缺的人才,不只是刷榜或发 paper 的人,而是上手修过 bug、和硬件软件都打过仗、能把复杂系统跑稳定的人
具身创业的三大派,都有不可替代性
机器人终局架构不会只是「快慢系统」两层,可能包含: 1000Hz 底层控制、10 到 20Hz 动作规划、1 到 2Hz 阶段目标规划,以及更高层的 Agent 长程推理。
「2026 年了,具身智能到底到 GPT 几了?其实 1 都没到呢」
「现阶段的真机数据量,和真正支撑基座模型涌现的数据规模,还差四五个数量级」
很多公司强调自己做「具身基模」,是借用了大语言模型时代的资本叙事
今天的具身更像 Transformer 和 BERT 早期,而不是 GPT-3 之后
数据的关键不仅是「量」,还包括信息维度、场景种类、失败样本和真实部署中的边界样本
多模态融合是必然趋势,视觉远远不够
真正的瓶颈不是算法是否足够聪明,而是真实世界数据的量、模态、场景和失败样本远远不够
神秘的邓泰华其人
智元Day 1 定位成 AI 公司,而非单纯的人形机器人公司
人形机器人是把 AI 带入物理世界的必要载体,但不是终点
「智元确实是这个行业里最有野心的公司之一」
智元的组织架构、融资节奏与股权激励
具身公司的长期价值不只在本体硬件,而在能否把「本体、数据、模型、场景」做成闭环。
精灵 G2 所经历的完整 IPD 流程:接近 9 个月
机器人行业的需求峰谷比汽车更剧烈
工业不相信眼泪,最终都是 ROI:「」工业客户不关心你是人形、猴形还是狗形」
智元的「358 战略」:从量产、商用到部署
具身智能最终不是单点技术竞赛,而是系统工程。
当技术路线逐步收敛、场景开始渗透时,先把 90% 的体系能力构建好,才可能真正承接行业机会。
智元的 AI 研发体系:模仿学习、VLA 预训练、世界模型、强化学习后训练和数据闭环
Google PaLM-E :VLA 来自语言模型和多模态语言模型向物理世界的迁移
世界模型更像对物理规律和状态转移的数字化、神经网络化描述
「VLA 和世界模型都不是最终形态,未来更可能是分层架构」:前者受限于语言和动作之间的表征鸿沟,后者仍更多来自二维视频和第三人称视角
:语言推理、物理预测、低层控制、长程规划和数据飞轮共同工作
世界模型的价值在于学习液体流动、玻璃破碎、软体形变等真实物理规律
「后训练和失败数据非常关键」
投资人的主意:对标上一轮 AI 时代的 Scale AI ?
具身数据生意比传统数字世界标注难得多
2026 :具身数据军备竞赛年
模型的差异化暂时不大,数据会是分水岭
打造一个公共性质的数据服务平台,一个「阳谋」:客户花钱带来数据需求,平台用数据训练模型,模型再反哺采集、预标注和质量管理效率
数据问题都没解决,讲基模预训练、后训练,都是空中楼阁
高质量数据的第一点是真实:场景和任务必须足够丰富,能够覆盖生活和生产中真正会遇到的问题
规范:相机曝光、画质、设备同步、轨迹重建精度、操作流程都要高标准
「脏数据」不是质量差的数据,而是包含失败、偏移、纠错、重新规划和最终成功的多样化数据
仿真数据并不天然低价值
关键不是流派,而是任务、场景、成功率要求和模型使用方式
数据的价格、产能和全球化
Deepmind 和 Genralist:「如果数据是具身智能竞争的唯一决定变量,中国公司现在就可以宣布他们是赢家」
As many as possible, as soon as possible(越多越好,越快越好).
好的数据标准会逐步收敛
即使不同机器人硬件不统一,很多数据仍可以被抽象为通用表达,如末端执行器轨迹、二维帧序列、物理状态变化等
机器人行业的安全和质量准入标准,会在两到三年内伴随大规模商用逐步出现。
从 G1 到 G5 ,当前行业大约处在 G3 到 G4 的中间态
预计 2027 到 2028 年行业有希望达到 1 亿小时级数据规模
真正类似语言模型那种涌现能力,还需到 1 亿小时级高质量数据出现
机器人出现真正的 aha moment:不再只是从画面到动作的肌肉映射,而是能在复杂环境里自主规划、理解指令、做出响应
涌现时刻大概率发生在实验室,而不是工厂
数据会成为这一轮智能化转型关键基础设施,但它比算力更难获取
加入听友群⬇️
说明里标出的时间点,点一下跳过去
https://feed.xyzfm.space/4jjdlpq3khc9复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →