十
【年终复盘②】RSI可能是NeoLab的机会、PA真的有用、创业要造灭火器还是砖头?|对话谷雨
11 月 9 日 · 41 分钟
➤ 本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 in-context learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
本期节目还有一个及时的注脚:就在我们录完节目后的第二周,Generalist 发布 GEN-1.5 ——只给机器人看一段 3-12 秒的动作示范作为 "physical prompt",不做微调、不更新参数,它就能当场尝试完成新任务(10 项任务平均成功率约 59%)。ICL 随即成为全球具身智能领域最受关注的话题之一,而这正是梦迪持续押注的方向。
除了 ICL,我们还聊到:
预训练的天花板
真正的泛化
Scaling Law 的信号与陷阱
跑通稳定的数据闭环
叠衣服 demo 的误导
行业的泡沫与进步
年轻 PI 的真实生活与研究选择
穿越所有的技术话题之后,这还是一期关于人生选择、环境与长期主义的对话,希望可以是给所有站在中美之间、学术与产业之间、跟随热点与坚持长线之间的年轻人的一份参考。
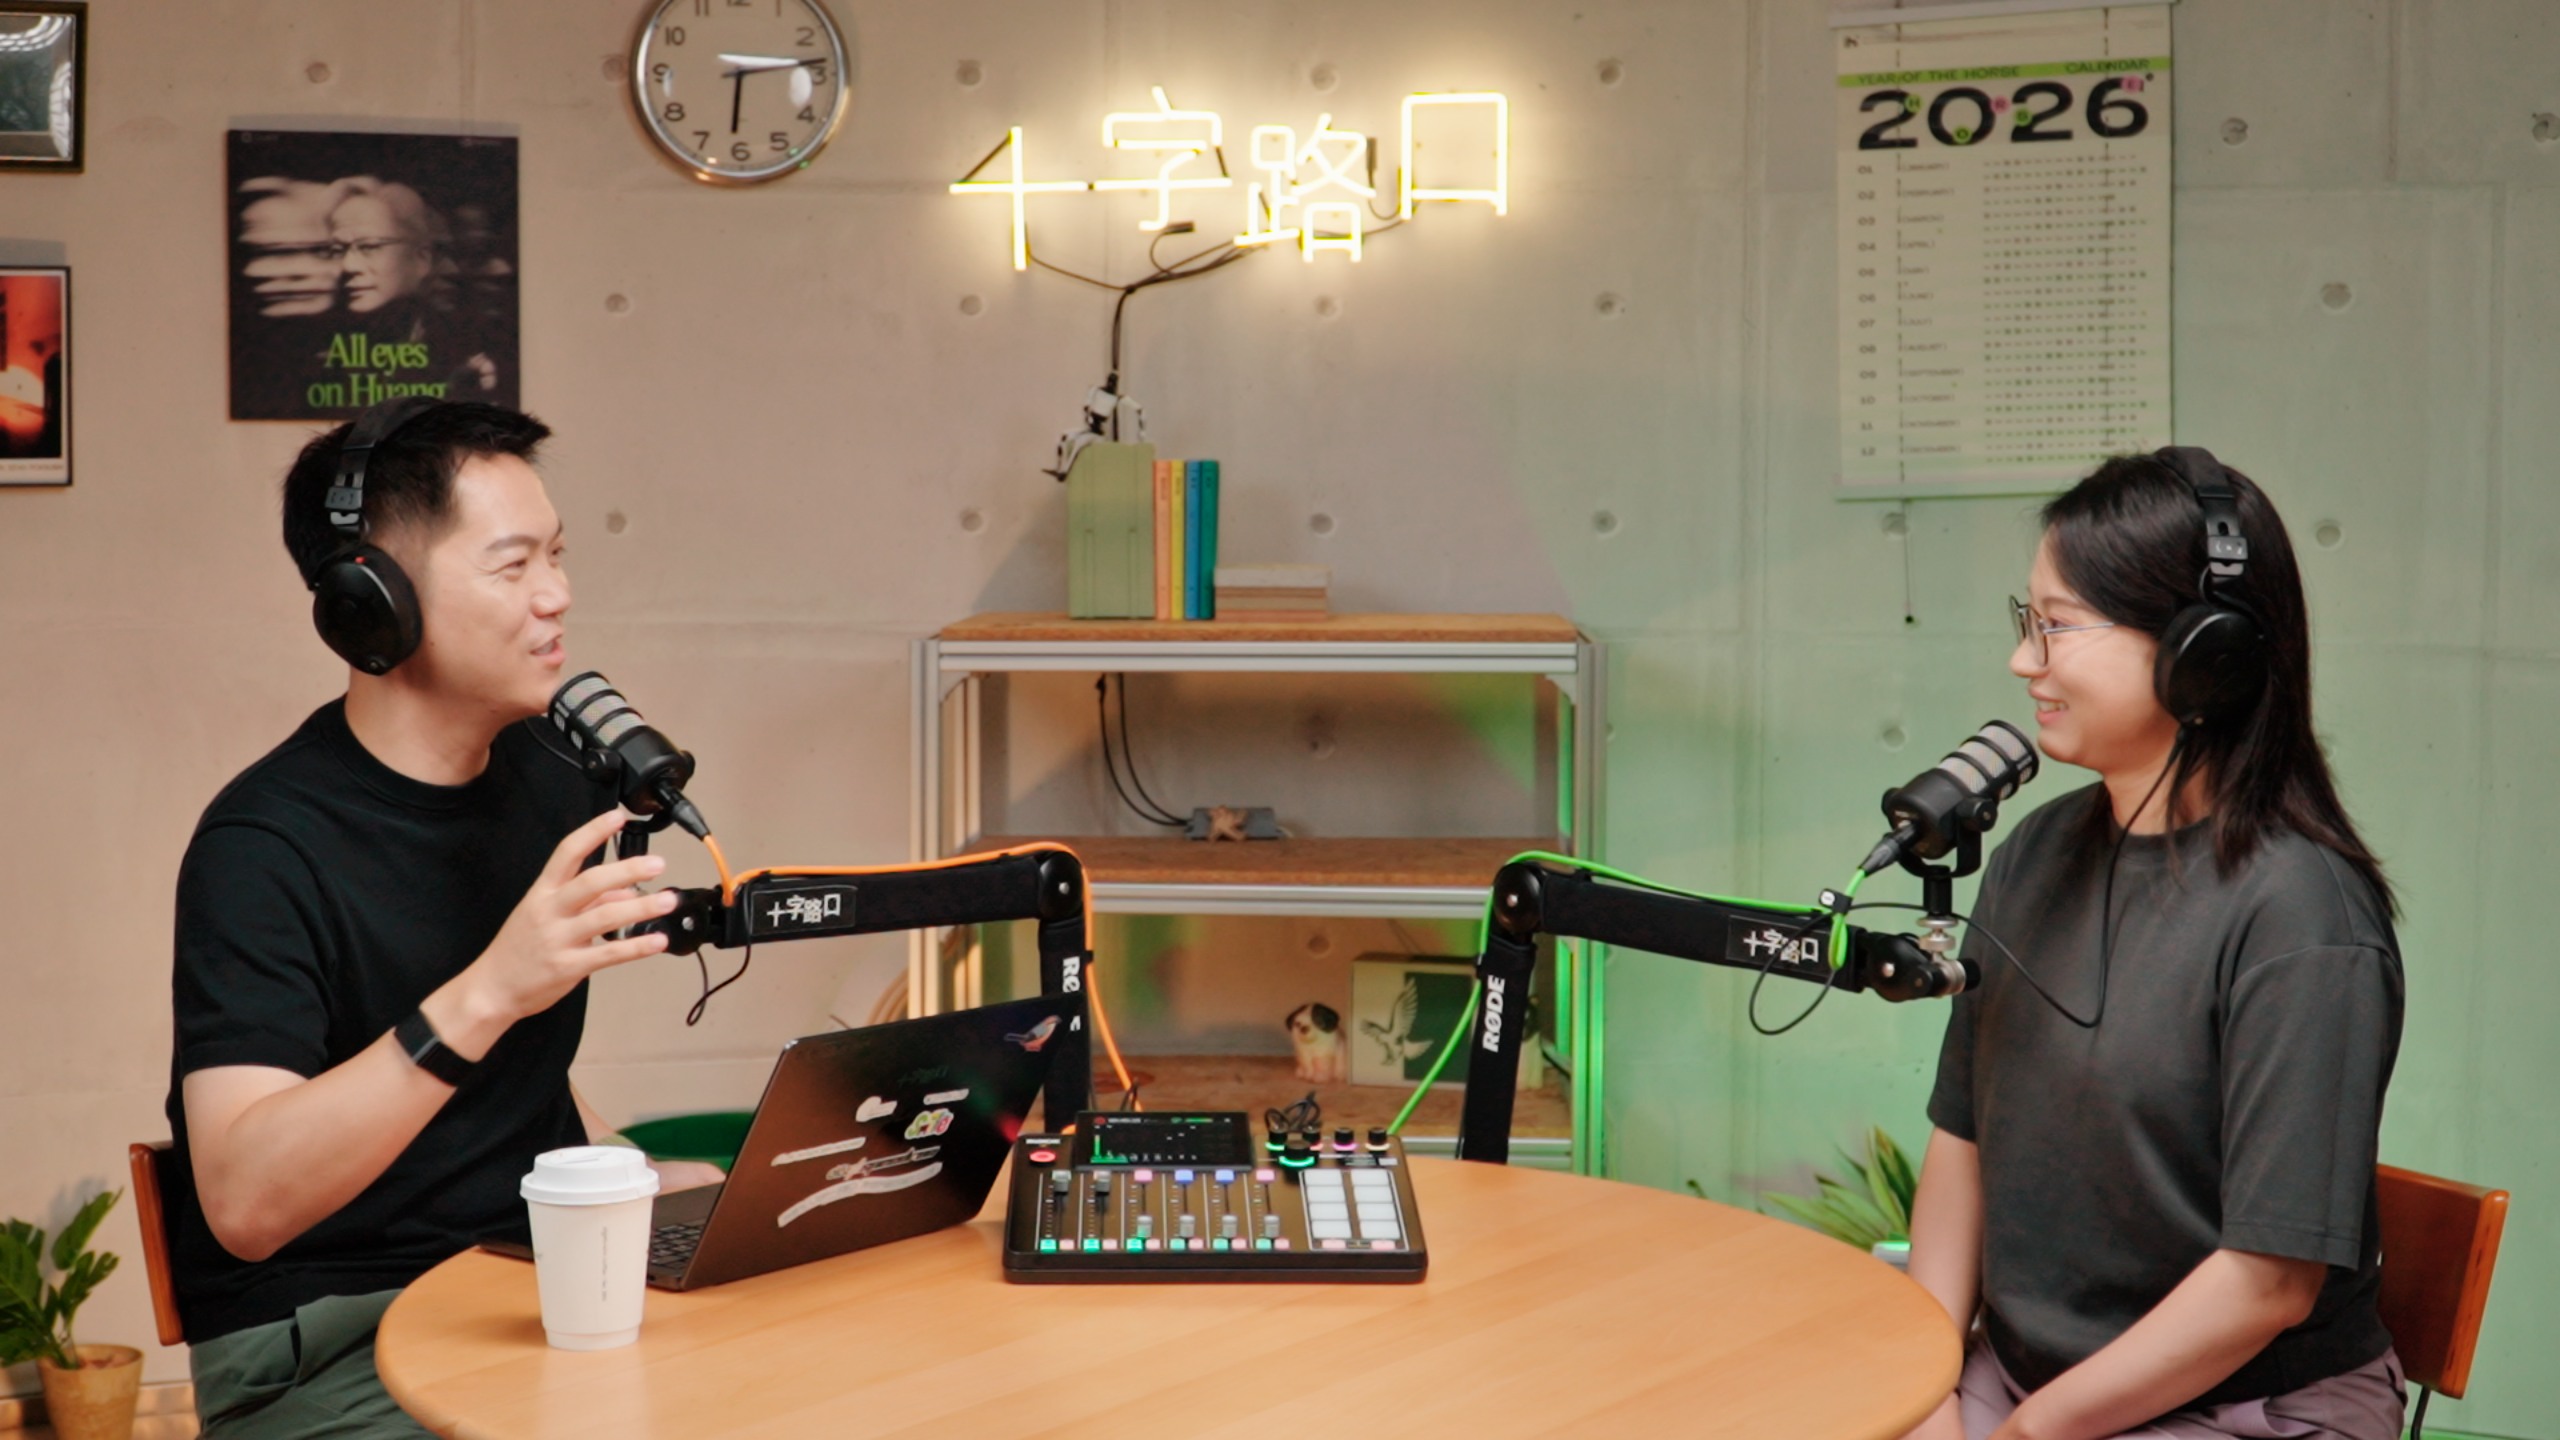
🎬 我们的视频播客将同步上线于 @Koji杨远骋 的视频号、抖音、小红书、哔哩哔哩、Youtube 等平台。
📒 文字版将发布于 @十字路口Crossing 公众号。

🟢 从四驱车到机器人
快问快答:年龄、毕业院校、MBTI、星座、一句话介绍
清华车辆工程,通向机器人的起点
为四驱车捡废铁的女孩
衡水中学,竞赛班里的另一面
CMU 最佳博士论文:预训练之外
Adaptation 为何越来越受重视?
🟢 从解题人到出题人
创造性工具使用:没有刀怎么切蛋糕?
斯坦福:李飞飞与吴佳俊,两种导师
从斯坦福回到清华
5 年后,凭什么成为顶尖研究者?
选最好的,还是最适合的?
她会回复怎样的套磁邮件?
🟢 具身 Scaling Law 的信号
具身创业:进步与泡沫共存
数据与世界模型,风向为何反复?
低 Loss,不等于高成功率
机器人还在 GPT-1 阶段?
In-Context Learning:机器人能懂你家吗?
数据闭环的“鸡生蛋”难题
具身数据,难在定义需求
遥操作、仿真、UMI 与人类数据
🟢 只有乐观才可能成功
博士面试里的 Research Taste
跟年轻 AP 读博,是一场创业?
AI 论文泛滥,还能怎么看?
具身马拉松,跑到第几公里?

🚦 我们关注新一代 AI 技术浪潮带来的行业新变化和创业新机会。
🚦 十字路口是乔布斯对苹果公司的一个比喻,形容它站在科技与人文的十字路口,伟大的产品往往诞生在这里。AI 正在给各行各业带来改变,我们寻找、访谈和凝聚新一代 AI 创业者和 AI 时代的积极行动者,和他们一起,探索和拥抱新变化,新的可能性。
👦🏻 主播 Koji:我创办了十字路口,发起了 AI Hacker House 这个新一代 AI 创业者的社群空间,在真格基金担任 Venture Partner 投资合伙人。我相信科技尤其是 AI 是我们这一代人最大的价值创造机遇。Koji 的即刻,Koji 的网站


说明里标出的时间点,点一下跳过去
AI 读完整集转写后给出的推荐理由
一位清华叉院助理教授把自己从车辆工程到具身智能的路径讲得很实在:为什么机器人不能只靠预训练、为什么 loss 低不等于成功率高、为什么数据闭环是最 risky 的一环。他给出一个具体判断——当前机器人模型更像 GPT-1,真正的 GPT-3 时刻要靠 in-context learning;还提到李飞飞当年只留一个 success rate 指标的细节。对想搞清具身智能到底走到哪一步的人,这期把技术路线和行业泡沫都摊开讲了。
由 AI 从整集转写生成,是创作者说明之外的补充
清华叉院助理教授徐梦迪在十字路口这期访谈中,讲述了自己从清华车辆工程到 CMU 机器人学习、再到斯坦福李飞飞与吴佳俊组做博士后的完整路径,并系统解释了他对具身智能核心问题的判断:机器人不能只靠预训练,必须具备 in-context learning 式的快速适应能力。他回顾了 Prompt Decision Transformer、Hyper Decision Transformer 等早期工作,分析了国内具身创业「有实际进步也有泡沫」的现状,指出机器人领域 loss 与成功率不直接挂钩、真正的 scaling law 应体现在未见任务成功率上升。他把当前机器人模型类比为 GPT-1 阶段,期待 GPT-3 式的 in-context learning 时刻,并认为数据闭环是最 risky 的一环。最后他判断具身智能这场马拉松才跑到十公里,未来三到五年是关键窗口。
点一章从那里开始播 · 与上面创作者标的时间点各自独立
快问快答:30.5 岁的 INTJ 与他的研究方向
主持人介绍徐梦迪的学术背景,嘉宾用快问快答形式交代年龄、MBTI、星座,并说明当前最重要的研究方向是让机器人从现实场景中持续提升自己。
从 MAML 到机器人学习:泛化方向的起点
徐梦迪讲述在 CMU 接触 robot learning 的契机,MAML 让他看到机器人学到未见任务的可能性,并由此确立泛化作为长期方向。
衡水、竞赛班与四驱车:成长经历
嘉宾回忆河北衡水的小学与衡水中学竞赛班经历,以及拼四驱车、捡钢铁零件赚钱的童年爱好,解释这些如何埋下车辆工程的种子。
竞赛生的路径与同伴关系
徐梦迪描述衡中竞赛班的管理方式与学习节奏,强调竞赛生有很强的自主想法,班级氛围更像战友抱团而非竞争。
博士论文:让机器人适应开放世界
他解释博士论文 Building Adaptable Generalist Robots 的核心思路,介绍 in-context learning 与 test-time training 两条路径,以及 Prompt Decision Transformer 和 Hyper Decision Transformer 两个工作。
适应能力为何直到现在才成为共识
徐梦迪分析此前主流做法是 scale 数据和模型,adaptation 被忽视;随着实际应用场景的考量,大家逐渐意识到机器人模型需要强适应能力,同时对 base 模型提出更高要求。
斯坦福博士后:Behavior benchmark 与两位导师
他讲述在斯坦福参与 Behavior benchmark、可 steerable 机器人和创造性工具使用 benchmark 三个工作,并对比李飞飞 vision-driven 与吴佳俊 hands-on 两种指导风格。
Research brand 与回国决定
徐梦迪解释 research brand 来自长期研究一个重要问题,并讲述 2023 年面试清华叉院、在工业界与学术界之间权衡、最终因自由度选择教职的过程。
面试问题与「幸运」的成长观
他回忆被问「为什么五年后能成为顶尖 researcher」时回答不够好,以及姚先生建议他 focus;他把自己的一路发展总结为幸运,强调环境和支撑网络的作用。
如何选择环境与最 tough 的十字路口
徐梦迪谈选择环境的标准是能否最大化自己的兴趣与能力,并坦言最 tough 的选择是回国,用「no free lunch」说明每个决定都要承担代价。
国内具身创业:有进步,也有泡沫
他判断国内具身领域从材料、sensor 到本体、数据、模型各层面都有实际进步,但事情尚未收敛导致焦点不断转移,泡沫必然存在,并用控制里的超调作比。
Scaling Law 的信号与 loss 的陷阱
徐梦迪说看到其他公司数据从十万小时 scale 到一百万小时后在 held-out 集上有效果,但指出机器人 loss 与成功率不直接挂钩,真正想见到的是未见任务成功率随规模上升。
机器人的 GPT 时刻与 benchmark 的必要性
他把当前机器人模型类比为 GPT-1 阶段,期待 GPT-3 式的 in-context learning 时刻,并认为具身领域比语言模型更需要 benchmark 来界定能力边界,推荐 Behavior。
in-context learning 的落地与数据闭环难题
徐梦迪用叠衣服和做菜的例子解释 in-context learning 要让模型被终端用户定义,并指出最 risky 的是能否跑通稳定数据闭环,目前从桌面任务和真机双臂场景做起。
离线模仿与融合派的数据观
他对比离线模仿与 in-context learning 的区别,说明不同数据来源适合不同训练阶段,并解释数据定义应由模型能力反推,而模型能力本身尚未收敛。
遥操作、仿真、UMI 与 human data 的取舍
徐梦迪逐一分析四类数据的适用阶段,强调自己是融合派,认为 human data 成本低、可大量铺场景,人本身就是一种 morphology,关键是构建数据与模型能力的正确链接。
给年轻研究者的建议与组会形式
他建议学生多看、多交流、实际上手干活,并介绍自己面试 PhD 的必问问题——最感兴趣的一篇文章是什么,以及组会以 tutorial 形式组织、本科生可以参与。
INTJ 的共情与实验室氛围
徐梦迪说自己共情能力强,会在集体中照顾别人情绪,并讲述如何从零搭建实验室、与学生建立信任、组织团建,希望伙伴不只是工作关系。
日常 AI 工具与论文大爆发的应对
他分享自己轮番使用多个聊天机器人、最近开始与 AI 做非工作对话,并谈到机器人论文翻倍、AI 写论文质量参差,自己更依赖关注 researcher 的筛选式阅读。
马拉松跑到十公里:未来三到五年是关键
徐梦迪判断具身智能这场马拉松才跑到四分之一,通用智能机器人真正落地尚未出现,但未来三到五年可能通过 scaling 看到明确范式转变,整体保持乐观。
【年终复盘②】RSI可能是NeoLab的机会、PA真的有用、创业要造灭火器还是砖头?|对话谷雨
11 月 9 日 · 41 分钟
【年终复盘①】AI带给我的10个Aha Moments|庄明浩:RSI 来了、AI 的奇观与粗糙、巨头夹缝中的创业机会
11 月 2 日 · 53 分钟
AI 时代,PhD 路上的 10 个关键问题|对谈李磊:港大 PhD、小米 MiMo 研究员
10 月 26 日 · 52 分钟
新的创业机会,正在 Claude Code 和 Codex 周围长出来|对谈 Treg
10 月 19 日 · 51 分钟
十字路口Crossing · 9 月 21 日 · 1 小时 21 分
➤ 本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 in-context learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
本期节目还有一个及时的注脚:就在我们录完节目后的第二周,Generalist 发布 GEN-1.5 ——只给机器人看一段 3-12 秒的动作示范作为 "physical prompt",不做微调、不更新参数,它就能当场尝试完成新任务(10 项任务平均成功率约 59%)。ICL 随即成为全球具身智能领域最受关注的话题之一,而这正是梦迪持续押注的方向。
除了 ICL,我们还聊到:
预训练的天花板
真正的泛化
Scaling Law 的信号与陷阱
跑通稳定的数据闭环
叠衣服 demo 的误导
行业的泡沫与进步
年轻 PI 的真实生活与研究选择
穿越所有的技术话题之后,这还是一期关于人生选择、环境与长期主义的对话,希望可以是给所有站在中美之间、学术与产业之间、跟随热点与坚持长线之间的年轻人的一份参考。
🎬 我们的视频播客将同步上线于 @Koji杨远骋 的视频号、抖音、小红书、哔哩哔哩、Youtube 等平台。
📒 文字版将发布于 @十字路口Crossing 公众号。
🟢 从四驱车到机器人
快问快答:年龄、毕业院校、MBTI、星座、一句话介绍
清华车辆工程,通向机器人的起点
为四驱车捡废铁的女孩
衡水中学,竞赛班里的另一面
CMU 最佳博士论文:预训练之外
Adaptation 为何越来越受重视?
🟢 从解题人到出题人
创造性工具使用:没有刀怎么切蛋糕?
斯坦福:李飞飞与吴佳俊,两种导师
从斯坦福回到清华
5 年后,凭什么成为顶尖研究者?
选最好的,还是最适合的?
她会回复怎样的套磁邮件?
🟢 具身 Scaling Law 的信号
具身创业:进步与泡沫共存
数据与世界模型,风向为何反复?
低 Loss,不等于高成功率
机器人还在 GPT-1 阶段?
In-Context Learning:机器人能懂你家吗?
数据闭环的“鸡生蛋”难题
具身数据,难在定义需求
遥操作、仿真、UMI 与人类数据
🟢 只有乐观才可能成功
博士面试里的 Research Taste
跟年轻 AP 读博,是一场创业?
AI 论文泛滥,还能怎么看?
具身马拉松,跑到第几公里?
🚦 我们关注新一代 AI 技术浪潮带来的行业新变化和创业新机会。
🚦 十字路口是乔布斯对苹果公司的一个比喻,形容它站在科技与人文的十字路口,伟大的产品往往诞生在这里。AI 正在给各行各业带来改变,我们寻找、访谈和凝聚新一代 AI 创业者和 AI 时代的积极行动者,和他们一起,探索和拥抱新变化,新的可能性。
👦🏻 主播 Koji:我创办了十字路口,发起了 AI Hacker House 这个新一代 AI 创业者的社群空间,在真格基金担任 Venture Partner 投资合伙人。我相信科技尤其是 AI 是我们这一代人最大的价值创造机遇。Koji 的即刻,Koji 的网站
说明里标出的时间点,点一下跳过去
AI 读完整集转写后给出的推荐理由
一位清华叉院助理教授把自己从车辆工程到具身智能的路径讲得很实在:为什么机器人不能只靠预训练、为什么 loss 低不等于成功率高、为什么数据闭环是最 risky 的一环。他给出一个具体判断——当前机器人模型更像 GPT-1,真正的 GPT-3 时刻要靠 in-context learning;还提到李飞飞当年只留一个 success rate 指标的细节。对想搞清具身智能到底走到哪一步的人,这期把技术路线和行业泡沫都摊开讲了。
由 AI 从整集转写生成,是创作者说明之外的补充
清华叉院助理教授徐梦迪在十字路口这期访谈中,讲述了自己从清华车辆工程到 CMU 机器人学习、再到斯坦福李飞飞与吴佳俊组做博士后的完整路径,并系统解释了他对具身智能核心问题的判断:机器人不能只靠预训练,必须具备 in-context learning 式的快速适应能力。他回顾了 Prompt Decision Transformer、Hyper Decision Transformer 等早期工作,分析了国内具身创业「有实际进步也有泡沫」的现状,指出机器人领域 loss 与成功率不直接挂钩、真正的 scaling law 应体现在未见任务成功率上升。他把当前机器人模型类比为 GPT-1 阶段,期待 GPT-3 式的 in-context learning 时刻,并认为数据闭环是最 risky 的一环。最后他判断具身智能这场马拉松才跑到十公里,未来三到五年是关键窗口。
点一章从那里开始播 · 与创作者标的时间点各自独立
快问快答:30.5 岁的 INTJ 与他的研究方向
从 MAML 到机器人学习:泛化方向的起点
衡水、竞赛班与四驱车:成长经历
竞赛生的路径与同伴关系
博士论文:让机器人适应开放世界
适应能力为何直到现在才成为共识
斯坦福博士后:Behavior benchmark 与两位导师
Research brand 与回国决定
面试问题与「幸运」的成长观
如何选择环境与最 tough 的十字路口
国内具身创业:有进步,也有泡沫
Scaling Law 的信号与 loss 的陷阱
机器人的 GPT 时刻与 benchmark 的必要性
in-context learning 的落地与数据闭环难题
离线模仿与融合派的数据观
遥操作、仿真、UMI 与 human data 的取舍
给年轻研究者的建议与组会形式
INTJ 的共情与实验室氛围
日常 AI 工具与论文大爆发的应对
马拉松跑到十公里:未来三到五年是关键
节目里自然聊到的,不是广告
AI 对内容的推测
☕🧄 这个比喻出自 2009 年周立波的一句「喝咖啡的怎么能和吃大蒜的呆在一起呢」;郭德纲后来在《你要高雅》里回了一句「雅和俗分不开,喝着咖啡就着大蒜,秋水共长天一色」。我们借它标注风格取向 —— 两端没有高下,编辑部式与熟人局式都能做出极好的节目。
https://feed.xyzfm.space/68fyjknth9hj复制概要、章节、提及与推广标注由 AI 生成,可能有误;内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
【年终复盘②】RSI可能是NeoLab的机会、PA真的有用、创业要造灭火器还是砖头?|对话谷雨
11 月 9 日 · 41 分钟
【年终复盘①】AI带给我的10个Aha Moments|庄明浩:RSI 来了、AI 的奇观与粗糙、巨头夹缝中的创业机会
11 月 2 日 · 53 分钟
AI 时代,PhD 路上的 10 个关键问题|对谈李磊:港大 PhD、小米 MiMo 研究员
10 月 26 日 · 52 分钟