十
【年终复盘②】RSI可能是NeoLab的机会、PA真的有用、创业要造灭火器还是砖头?|对话谷雨
11 月 9 日 · 41 分钟
🚥 没人喜欢等待。
模型越强,推理加速就越重要。
这一期,我们聊「推理加速」。
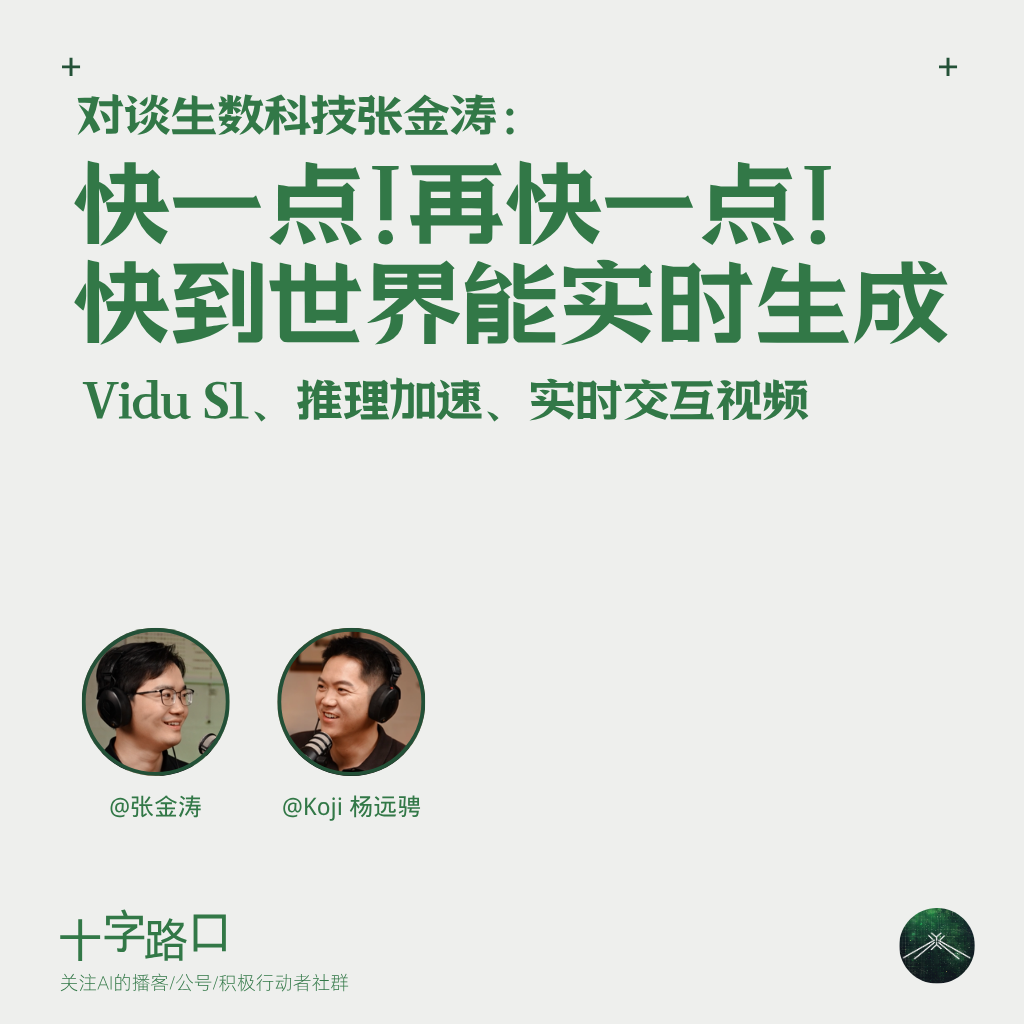
本周「十字路口」的嘉宾是生数科技的张金涛。月初,他带队发布了 Vidu S1——一个实时交互视频模型:上传一张照片,无论是人物、动漫角色,还是一只宠物,都能变成一个可以和你实时视频通话的 AI 角色。
Vidu S1 很快,快到生成速度超过播放速度,并且支持无限时长。这是怎么做到的?
金涛在播客中分享了自己这几年一条清晰的技术主线:从 SageAttention(GitHub 3.5K 星标)、TurboDiffusion(GitHub 3.6K 星标),到 TurboServe——一整套系统级方案,为 S1 实时交互提供底层支撑。
此外,金涛也分享了他对整个 AI「推理加速」领域的观察和判断。
其实这期有意思的,不只是技术。
金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」
所以这期节目,你也可以把它当成一份「年轻研究者样本」来听:在变化极快的 AI 领域,怎么找到自己的方向、怎么判断什么才是「最正确的事」,又怎么把它一路做到最前沿。

🎬 我们的视频播客将同步上线于 @Koji杨远骋 的视频号、抖音、小红书、哔哩哔哩、Youtube 等平台。
📒 文字版将发布于 @十字路口Crossing 公众号。

🟢 快问快答:年龄、毕业院校、MBTI 与星座、Vidu S1,以及在生数科技负责的工作
🟢 硬件上明明有更快的计算单元
“为什么没有人做?这是很明显的一个收益。”
当大家认为 FlashAttention 已接近极致,张金涛发现 GPU 上仍有更快的计算单元没有用于 Attention。
语言模型早期的 Attention 更受显存传输限制,视频生成模型却严重受计算速度限制。
SageAttention 要同时解决底层 GPU Kernel 编程和低比特计算的精度损失,最终成为即插即用的加速方案。
🟢 从 SageAttention 到 Vidu S1:三层加速
算子层:让 Attention、线性层等计算尽可能逼近硬件上限。
模型层:通过步数蒸馏和稀疏 Attention,把 Diffusion 去噪从约 50 步降到 4 步。
部署层:解决多卡并行、通信与计算重叠、用户请求调度。
SageAttention 后来成为事实上的行业标准;TurboDiffusion 推进模型加速,TurboServe 负责流式视频的集群部署。
🟢 Vidu S1 不只是快
“生成速度需要大于播放速度,它才能做到实时生成。”
普通视频模型等待很久生成一段成片,流式模型则要根据用户输入逐帧生成。
Vidu S1 实现 540P、25–42 FPS,并能在消费级显卡上运行。
比速度更难的是无限时长:生成一两个小时后,画面仍不能漂移或崩坏,还要持续正确回应用户。
实时交互是第一目标,当前阶段可以适度牺牲画质,但不能牺牲速度。
🟢 “未来我们的视觉娱乐信号,会被 AI 生成的内容充斥掉。”
电影和短视频是预先生成的离线内容,聊天、恋爱、游戏和日常生活则充满实时视觉互动。
离线视频可以共享播放,实时视频需要为每个人生成不同内容。
张金涛判断,实时交互视觉娱乐的需求会比离线内容更大,而且这条路径已经势不可挡。
🟢 一只狗和一个游戏搭子
用户已经开始上传宠物图片与它聊天,也有人让二次元角色实时观看游戏画面、陪自己玩游戏。
Vidu S1 能理解输入的视频流;把电脑屏幕传给它,它也可以成为看懂 Coding、微信和 Notion 的“程序员鼓励师”。
🟢 推理加速不只是算子
算子加速之外,还要用稀疏 Attention、MoE 和蒸馏减少模型本身的计算量。
流式 Diffusion 会引入 KV Cache,还要处理用户随时进入、退出,以及多机多卡的集群调度。
TurboServe 对应的正是 Serving 层:把计算图、通信与请求调度组合成真正可部署的系统。
🟢 推理加速的未来,属于更底层和更上层
“推理加速的未来,还是属于更底层和更上层。”
中间的算子层会随着编程工具进步逐渐收敛;更底层是面向通用或特定模型设计芯片,更上层是用算法直接减少计算。
像 Taalas 这样针对特定模型做硬件设计,本质是在通用性与极致效率之间取舍。
真正有壁垒的加速需要软硬件 Co-Design:只懂算法,很难判断方案在真实硬件上是否有效。
🟢 中国视频模型的领先原因
Transformer 之后,模型结构逐渐收敛,差距更多来自数据量、数据质量、偏好对齐和数据是否容易学习。
低质量数据不只是没用,还会污染模型;高质量解释能让模型更快学会关键概念。
中国的短视频、直播与电商生态既产生真实需求,也沉淀了更丰富的视频数据;张金涛认为中国视频模型公司目前领先美国。
🟢 世界领先,是把每个环节都做对
“知道世界上最正确、最领先的方法是什么,然后把它正确实现出来。”
朱军让他理解,GPT-3 的成功不是靠某个神秘技巧,而是把每个环节都推到极致。
两行有问题的代码就足以让实验失败;负责人必须能判断方案是否正确、实现是否到位。
带团队还要看见每个人真正想要的是工资、Credit 还是成就感,再从第一性原理协调不同部门。
🟢 一行代码,速度快一倍
“视频生成得跟之前像素级一模一样,但端到端推理速度快了一倍多。”
在清华安静的楼里,他一个线程一个线程地排查底层问题,终于让 SageAttention 跑通。
把 Vidu 里的 FlashAttention 换成 SageAttention 只需改一行代码,输出保持像素级一致,端到端速度却提升一倍多。
他立刻把结果发给陈建飞和朱军;后来又带队负责 Vidu 推理与 S1,把这段经历形容得“像在创业”。
这段最快乐的科研时光,也来自朱军给出的方向、资源和自由氛围。

🚦 我们关注新一代 AI 技术浪潮带来的行业新变化和创业新机会。
🚦 十字路口是乔布斯对苹果公司的一个比喻,形容它站在科技与人文的十字路口,伟大的产品往往诞生在这里。AI 正在给各行各业带来改变,我们寻找、访谈和凝聚新一代 AI 创业者和 AI 时代的积极行动者,和他们一起,探索和拥抱新变化,新的可能性。
👦🏻 主播 Koji:我创办了十字路口,发起了 AI Hacker House 这个新一代 AI 创业者的社群空间,在真格基金担任 Venture Partner 投资合伙人。我相信科技尤其是 AI 是我们这一代人最大的价值创造机遇。Koji 的即刻,Koji 的网站


说明里标出的时间点,点一下跳过去
AI 读完整集转写后给出的推荐理由
生数科技张金涛带来Vidu S1背后的推理加速全链路解析:从SageAttention到TurboDiffusion,再到实时视频生成的部署挑战。他解释了为什么中国视频模型能领先——数据优势是关键。还分享了一个反常识的观点:未来推理加速的突破不在算子优化,而在芯片设计和算法层。如果你对AI视频生成或推理优化感兴趣,这期能让你看到技术前沿的真实样貌。
由 AI 从整集转写生成,是创作者说明之外的补充
本期节目邀请生数科技张金涛,聊Vidu S1流式视频生成模型背后的推理加速技术。张金涛从SageAttention讲起,梳理了推理加速的算子层、模型层、部署层三层体系,解释了Vidu S1如何实现540P、25-42FPS、无限长实时交互生成。他还分享了对中国视频模型领先原因的分析(数据优势)、推理加速的未来方向(底层芯片与上层算法),以及自己的创业与管理思考。节目还涉及AI创业热潮、个人成长经历等话题。
点一章从那里开始播 · 与上面创作者标的时间点各自独立
开场与嘉宾介绍
主播介绍节目主题,引出张金涛及其在生数科技的工作,进行快问快答,嘉宾介绍Vidu S1的基本情况。
SageAttention的诞生
张金涛讲述从硕士到博士的科研经历,解释SageAttention的动机与挑战,包括低比特加速Attention的难点。
推理加速的三个层面
张金涛将推理加速分为算子层、模型层、部署层,并分别举例说明,为后续讨论奠定框架。
TurboDiffusion与行业采纳
介绍TurboDiffusion的工作,强调其模型层面的优化,并提到SageAttention已成为行业标准,被多家硬件厂商和公司采用。
Vidu S1的技术挑战
讨论Vidu S1的实时生成特性,强调其与普通视频生成的区别,以及长时间生成不漂移的挑战。
Vidu S1的性能与权衡
介绍Vidu S1的分辨率、帧率、消费级显卡运行等性能指标,并讨论在效率、画质、一致性之间的权衡,明确快是第一目标。
实时交互视频的未来
张金涛阐述实时交互视频的重要性,认为其需求大于离线视频,并坚信未来视觉娱乐将被AI生成内容取代。
用户案例与生态
分享Vidu S1发布后的用户案例,如与宠物聊天、游戏陪玩等,展示其应用潜力。
推理加速领域的重要工作
张金涛介绍推理加速领域的其他重要工作,如vLLM、TurboServe、SLA等,并讨论其优缺点。
推理加速的未来方向
张金涛认为未来属于更底层(芯片)和更上层(算法),并讨论定制芯片与通用芯片的权衡。
创业与行业观察
讨论推理加速领域的创业机会,以及中国视频模型领先的原因,强调数据优势。
AI创业热潮与管理实践
张金涛分享对AI创业热潮的看法,认为不是泡沫,并讲述自己的管理实践,包括如何激励团队、协调部门。
个人成长与总结
张金涛回顾自己的成长经历,强调数学与语文的重要性,分享科研与带团队的快乐,最后感谢朱军老师。
【年终复盘②】RSI可能是NeoLab的机会、PA真的有用、创业要造灭火器还是砖头?|对话谷雨
11 月 9 日 · 41 分钟
【年终复盘①】AI带给我的10个Aha Moments|庄明浩:RSI 来了、AI 的奇观与粗糙、巨头夹缝中的创业机会
11 月 2 日 · 53 分钟
AI 时代,PhD 路上的 10 个关键问题|对谈李磊:港大 PhD、小米 MiMo 研究员
10 月 26 日 · 52 分钟
新的创业机会,正在 Claude Code 和 Codex 周围长出来|对谈 Treg
10 月 19 日 · 51 分钟
十字路口Crossing · 7 月 20 日 · 41 分钟
🚥 没人喜欢等待。
模型越强,推理加速就越重要。
这一期,我们聊「推理加速」。
本周「十字路口」的嘉宾是生数科技的张金涛。月初,他带队发布了 Vidu S1——一个实时交互视频模型:上传一张照片,无论是人物、动漫角色,还是一只宠物,都能变成一个可以和你实时视频通话的 AI 角色。
Vidu S1 很快,快到生成速度超过播放速度,并且支持无限时长。这是怎么做到的?
金涛在播客中分享了自己这几年一条清晰的技术主线:从 SageAttention(GitHub 3.5K 星标)、TurboDiffusion(GitHub 3.6K 星标),到 TurboServe——一整套系统级方案,为 S1 实时交互提供底层支撑。
此外,金涛也分享了他对整个 AI「推理加速」领域的观察和判断。
其实这期有意思的,不只是技术。
金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」
所以这期节目,你也可以把它当成一份「年轻研究者样本」来听:在变化极快的 AI 领域,怎么找到自己的方向、怎么判断什么才是「最正确的事」,又怎么把它一路做到最前沿。
🎬 我们的视频播客将同步上线于 @Koji杨远骋 的视频号、抖音、小红书、哔哩哔哩、Youtube 等平台。
📒 文字版将发布于 @十字路口Crossing 公众号。
🟢 快问快答:年龄、毕业院校、MBTI 与星座、Vidu S1,以及在生数科技负责的工作
🟢 硬件上明明有更快的计算单元
“为什么没有人做?这是很明显的一个收益。”
当大家认为 FlashAttention 已接近极致,张金涛发现 GPU 上仍有更快的计算单元没有用于 Attention。
语言模型早期的 Attention 更受显存传输限制,视频生成模型却严重受计算速度限制。
SageAttention 要同时解决底层 GPU Kernel 编程和低比特计算的精度损失,最终成为即插即用的加速方案。
🟢 从 SageAttention 到 Vidu S1:三层加速
算子层:让 Attention、线性层等计算尽可能逼近硬件上限。
模型层:通过步数蒸馏和稀疏 Attention,把 Diffusion 去噪从约 50 步降到 4 步。
部署层:解决多卡并行、通信与计算重叠、用户请求调度。
SageAttention 后来成为事实上的行业标准;TurboDiffusion 推进模型加速,TurboServe 负责流式视频的集群部署。
🟢 Vidu S1 不只是快
“生成速度需要大于播放速度,它才能做到实时生成。”
普通视频模型等待很久生成一段成片,流式模型则要根据用户输入逐帧生成。
Vidu S1 实现 540P、25–42 FPS,并能在消费级显卡上运行。
比速度更难的是无限时长:生成一两个小时后,画面仍不能漂移或崩坏,还要持续正确回应用户。
实时交互是第一目标,当前阶段可以适度牺牲画质,但不能牺牲速度。
🟢 “未来我们的视觉娱乐信号,会被 AI 生成的内容充斥掉。”
电影和短视频是预先生成的离线内容,聊天、恋爱、游戏和日常生活则充满实时视觉互动。
离线视频可以共享播放,实时视频需要为每个人生成不同内容。
张金涛判断,实时交互视觉娱乐的需求会比离线内容更大,而且这条路径已经势不可挡。
🟢 一只狗和一个游戏搭子
用户已经开始上传宠物图片与它聊天,也有人让二次元角色实时观看游戏画面、陪自己玩游戏。
Vidu S1 能理解输入的视频流;把电脑屏幕传给它,它也可以成为看懂 Coding、微信和 Notion 的“程序员鼓励师”。
🟢 推理加速不只是算子
算子加速之外,还要用稀疏 Attention、MoE 和蒸馏减少模型本身的计算量。
流式 Diffusion 会引入 KV Cache,还要处理用户随时进入、退出,以及多机多卡的集群调度。
TurboServe 对应的正是 Serving 层:把计算图、通信与请求调度组合成真正可部署的系统。
🟢 推理加速的未来,属于更底层和更上层
“推理加速的未来,还是属于更底层和更上层。”
中间的算子层会随着编程工具进步逐渐收敛;更底层是面向通用或特定模型设计芯片,更上层是用算法直接减少计算。
像 Taalas 这样针对特定模型做硬件设计,本质是在通用性与极致效率之间取舍。
真正有壁垒的加速需要软硬件 Co-Design:只懂算法,很难判断方案在真实硬件上是否有效。
🟢 中国视频模型的领先原因
Transformer 之后,模型结构逐渐收敛,差距更多来自数据量、数据质量、偏好对齐和数据是否容易学习。
低质量数据不只是没用,还会污染模型;高质量解释能让模型更快学会关键概念。
中国的短视频、直播与电商生态既产生真实需求,也沉淀了更丰富的视频数据;张金涛认为中国视频模型公司目前领先美国。
🟢 世界领先,是把每个环节都做对
“知道世界上最正确、最领先的方法是什么,然后把它正确实现出来。”
朱军让他理解,GPT-3 的成功不是靠某个神秘技巧,而是把每个环节都推到极致。
两行有问题的代码就足以让实验失败;负责人必须能判断方案是否正确、实现是否到位。
带团队还要看见每个人真正想要的是工资、Credit 还是成就感,再从第一性原理协调不同部门。
🟢 一行代码,速度快一倍
“视频生成得跟之前像素级一模一样,但端到端推理速度快了一倍多。”
在清华安静的楼里,他一个线程一个线程地排查底层问题,终于让 SageAttention 跑通。
把 Vidu 里的 FlashAttention 换成 SageAttention 只需改一行代码,输出保持像素级一致,端到端速度却提升一倍多。
他立刻把结果发给陈建飞和朱军;后来又带队负责 Vidu 推理与 S1,把这段经历形容得“像在创业”。
这段最快乐的科研时光,也来自朱军给出的方向、资源和自由氛围。
🚦 我们关注新一代 AI 技术浪潮带来的行业新变化和创业新机会。
🚦 十字路口是乔布斯对苹果公司的一个比喻,形容它站在科技与人文的十字路口,伟大的产品往往诞生在这里。AI 正在给各行各业带来改变,我们寻找、访谈和凝聚新一代 AI 创业者和 AI 时代的积极行动者,和他们一起,探索和拥抱新变化,新的可能性。
👦🏻 主播 Koji:我创办了十字路口,发起了 AI Hacker House 这个新一代 AI 创业者的社群空间,在真格基金担任 Venture Partner 投资合伙人。我相信科技尤其是 AI 是我们这一代人最大的价值创造机遇。Koji 的即刻,Koji 的网站
说明里标出的时间点,点一下跳过去
AI 读完整集转写后给出的推荐理由
生数科技张金涛带来Vidu S1背后的推理加速全链路解析:从SageAttention到TurboDiffusion,再到实时视频生成的部署挑战。他解释了为什么中国视频模型能领先——数据优势是关键。还分享了一个反常识的观点:未来推理加速的突破不在算子优化,而在芯片设计和算法层。如果你对AI视频生成或推理优化感兴趣,这期能让你看到技术前沿的真实样貌。
由 AI 从整集转写生成,是创作者说明之外的补充
本期节目邀请生数科技张金涛,聊Vidu S1流式视频生成模型背后的推理加速技术。张金涛从SageAttention讲起,梳理了推理加速的算子层、模型层、部署层三层体系,解释了Vidu S1如何实现540P、25-42FPS、无限长实时交互生成。他还分享了对中国视频模型领先原因的分析(数据优势)、推理加速的未来方向(底层芯片与上层算法),以及自己的创业与管理思考。节目还涉及AI创业热潮、个人成长经历等话题。
点一章从那里开始播 · 与创作者标的时间点各自独立
开场与嘉宾介绍
SageAttention的诞生
推理加速的三个层面
TurboDiffusion与行业采纳
Vidu S1的技术挑战
Vidu S1的性能与权衡
实时交互视频的未来
用户案例与生态
推理加速领域的重要工作
推理加速的未来方向
创业与行业观察
AI创业热潮与管理实践
个人成长与总结
节目里自然聊到的,不是广告
AI 对内容的推测
☕🧄 这个比喻出自 2009 年周立波的一句「喝咖啡的怎么能和吃大蒜的呆在一起呢」;郭德纲后来在《你要高雅》里回了一句「雅和俗分不开,喝着咖啡就着大蒜,秋水共长天一色」。我们借它标注风格取向 —— 两端没有高下,编辑部式与熟人局式都能做出极好的节目。
https://feed.xyzfm.space/68fyjknth9hj复制概要、章节、提及与推广标注由 AI 生成,可能有误;内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
【年终复盘②】RSI可能是NeoLab的机会、PA真的有用、创业要造灭火器还是砖头?|对话谷雨
11 月 9 日 · 41 分钟
【年终复盘①】AI带给我的10个Aha Moments|庄明浩:RSI 来了、AI 的奇观与粗糙、巨头夹缝中的创业机会
11 月 2 日 · 53 分钟
AI 时代,PhD 路上的 10 个关键问题|对谈李磊:港大 PhD、小米 MiMo 研究员
10 月 26 日 · 52 分钟