H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

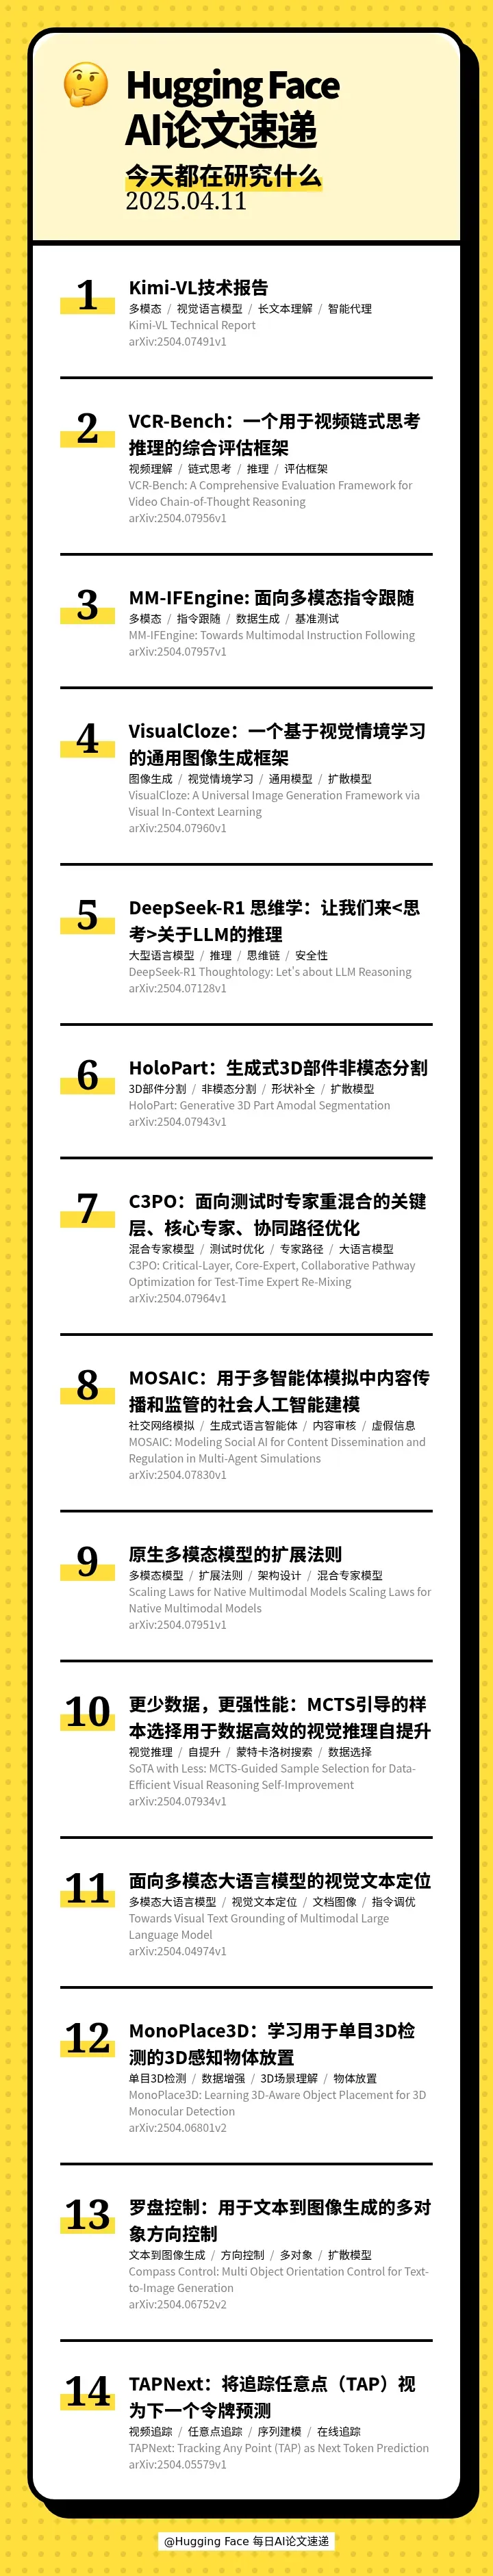
本期的 14 篇论文如下:
[] 🧠 Kimi-VL Technical Report(Kimi-VL技术报告)
[] 🎬 VCR-Bench: A Comprehensive Evaluation Framework for Video Chain-of-Thought Reasoning(VCR-Bench:一个用于视频链式思考推理的综合评估框架)
[] 🖼 MM-IFEngine: Towards Multimodal Instruction Following(MM-IFEngine: 面向多模态指令跟随)
[] 🖼 VisualCloze: A Universal Image Generation Framework via Visual In-Context Learning(VisualCloze:一个基于视觉情境学习的通用图像生成框架)
[] 🤔 DeepSeek-R1 Thoughtology: Let's <think> about LLM Reasoning(DeepSeek-R1 思维学:让我们来<思考>关于LLM的推理)
[] 🧩 HoloPart: Generative 3D Part Amodal Segmentation(HoloPart:生成式3D部件非模态分割)
[] 🤖 C3PO: Critical-Layer, Core-Expert, Collaborative Pathway Optimization for Test-Time Expert Re-Mixing(C3PO:面向测试时专家重混合的关键层、核心专家、协同路径优化)
[] 🤖 MOSAIC: Modeling Social AI for Content Dissemination and Regulation in Multi-Agent Simulations(MOSAIC:用于多智能体模拟中内容传播和监管的社会人工智能建模)
[] 🖼 Scaling Laws for Native Multimodal Models Scaling Laws for Native Multimodal Models(原生多模态模型的扩展法则)
[] 🧠 SoTA with Less: MCTS-Guided Sample Selection for Data-Efficient Visual Reasoning Self-Improvement(更少数据,更强性能:MCTS引导的样本选择用于数据高效的视觉推理自提升)
[] 🖼 Towards Visual Text Grounding of Multimodal Large Language Model(面向多模态大语言模型的视觉文本定位)
[] 🤖 MonoPlace3D: Learning 3D-Aware Object Placement for 3D Monocular Detection(MonoPlace3D:学习用于单目3D检测的3D感知物体放置)
[] 🧭 Compass Control: Multi Object Orientation Control for Text-to-Image Generation(罗盘控制:用于文本到图像生成的多对象方向控制)
[] 📍 TAPNext: Tracking Any Point (TAP) as Next Token Prediction(TAPNext:将追踪任意点(TAP)视为下一个令牌预测)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 4 月 12 日 · 11 分钟
本期的 14 篇论文如下:
[] 🧠 Kimi-VL Technical Report(Kimi-VL技术报告)
[] 🎬 VCR-Bench: A Comprehensive Evaluation Framework for Video Chain-of-Thought Reasoning(VCR-Bench:一个用于视频链式思考推理的综合评估框架)
[] 🖼 MM-IFEngine: Towards Multimodal Instruction Following(MM-IFEngine: 面向多模态指令跟随)
[] 🖼 VisualCloze: A Universal Image Generation Framework via Visual In-Context Learning(VisualCloze:一个基于视觉情境学习的通用图像生成框架)
[] 🤔 DeepSeek-R1 Thoughtology: Let's <think> about LLM Reasoning(DeepSeek-R1 思维学:让我们来<思考>关于LLM的推理)
[] 🧩 HoloPart: Generative 3D Part Amodal Segmentation(HoloPart:生成式3D部件非模态分割)
[] 🤖 C3PO: Critical-Layer, Core-Expert, Collaborative Pathway Optimization for Test-Time Expert Re-Mixing(C3PO:面向测试时专家重混合的关键层、核心专家、协同路径优化)
[] 🤖 MOSAIC: Modeling Social AI for Content Dissemination and Regulation in Multi-Agent Simulations(MOSAIC:用于多智能体模拟中内容传播和监管的社会人工智能建模)
[] 🖼 Scaling Laws for Native Multimodal Models Scaling Laws for Native Multimodal Models(原生多模态模型的扩展法则)
[] 🧠 SoTA with Less: MCTS-Guided Sample Selection for Data-Efficient Visual Reasoning Self-Improvement(更少数据,更强性能:MCTS引导的样本选择用于数据高效的视觉推理自提升)
[] 🖼 Towards Visual Text Grounding of Multimodal Large Language Model(面向多模态大语言模型的视觉文本定位)
[] 🤖 MonoPlace3D: Learning 3D-Aware Object Placement for 3D Monocular Detection(MonoPlace3D:学习用于单目3D检测的3D感知物体放置)
[] 🧭 Compass Control: Multi Object Orientation Control for Text-to-Image Generation(罗盘控制:用于文本到图像生成的多对象方向控制)
[] 📍 TAPNext: Tracking Any Point (TAP) as Next Token Prediction(TAPNext:将追踪任意点(TAP)视为下一个令牌预测)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟