H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

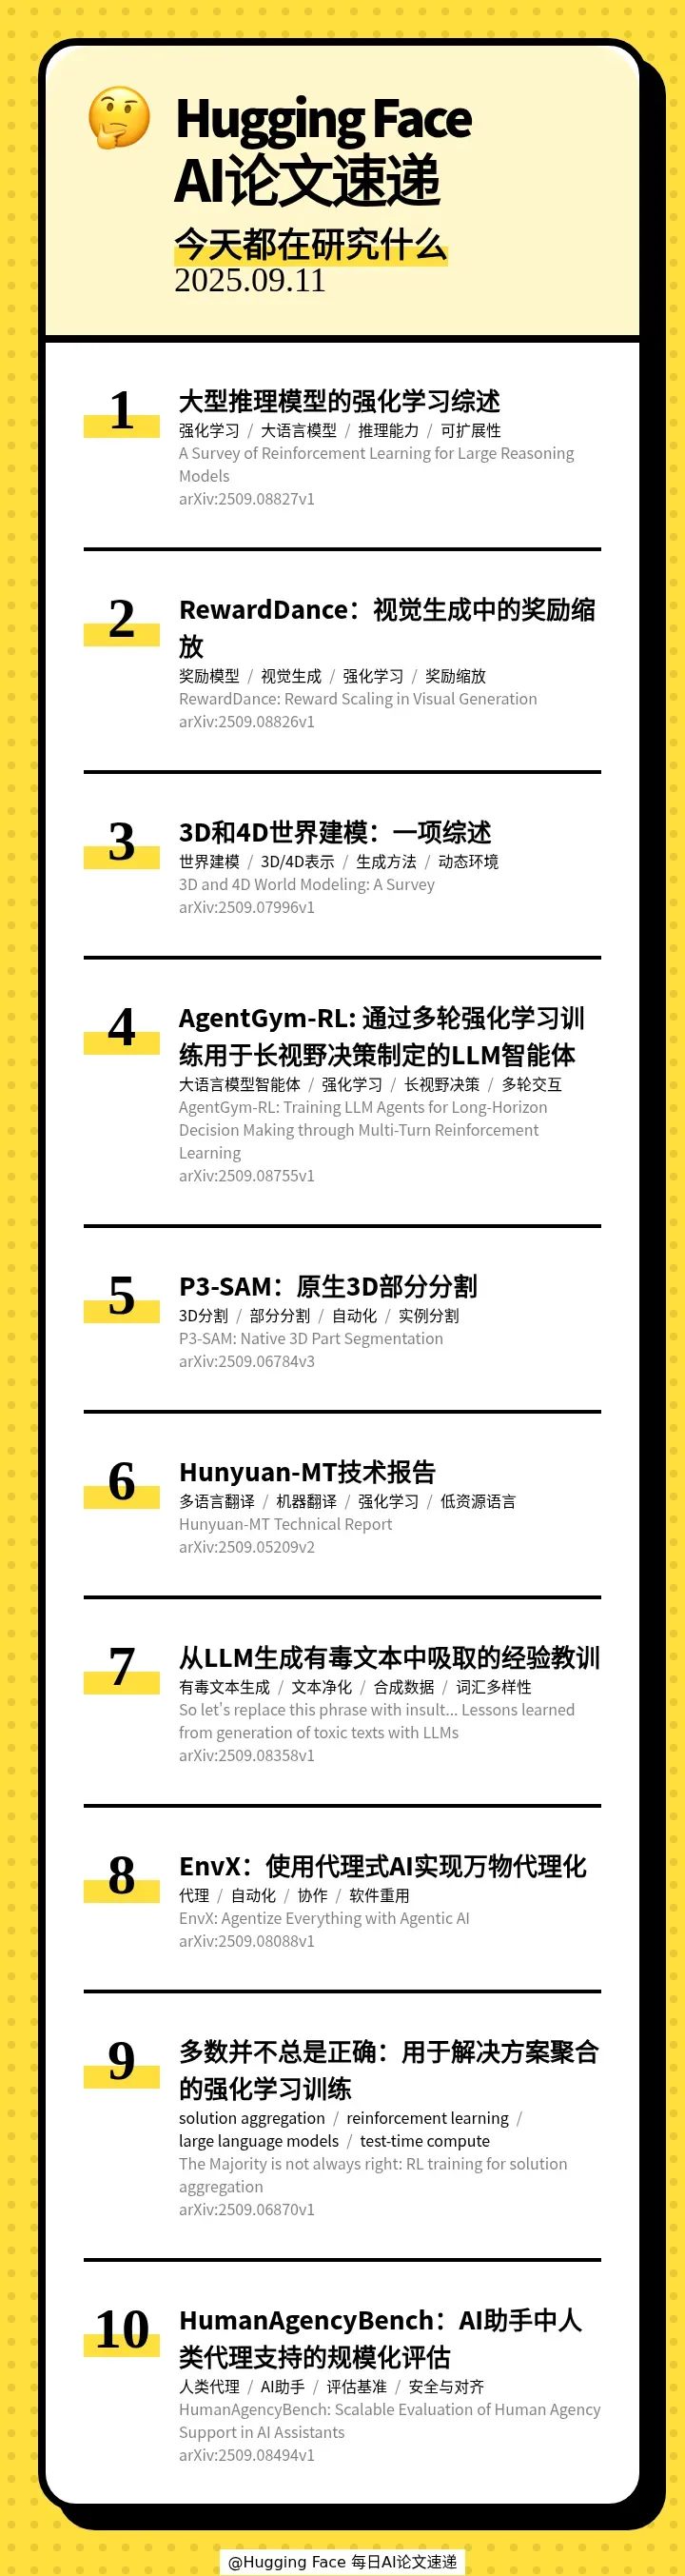
本期的 10 篇论文如下:
[] 🧠 A Survey of Reinforcement Learning for Large Reasoning Models(大型推理模型的强化学习综述)
[] 🔄 RewardDance: Reward Scaling in Visual Generation(RewardDance:视觉生成中的奖励缩放)
[] 🌐 3D and 4D World Modeling: A Survey(3D和4D世界建模:一项综述)
[] 🤖 AgentGym-RL: Training LLM Agents for Long-Horizon Decision Making through Multi-Turn Reinforcement Learning(AgentGym-RL: 通过多轮强化学习训练用于长视野决策制定的LLM智能体)
[] 🧩 P3-SAM: Native 3D Part Segmentation(P3-SAM:原生3D部分分割)
[] 🌐 Hunyuan-MT Technical Report(Hunyuan-MT技术报告)
[] ⚠ <think> So let's replace this phrase with insult... </think> Lessons learned from generation of toxic texts with LLMs(从LLM生成有毒文本中吸取的经验教训)
[] 🤖 EnvX: Agentize Everything with Agentic AI(EnvX:使用代理式AI实现万物代理化)
[] 🤔 The Majority is not always right: RL training for solution aggregation(多数并不总是正确:用于解决方案聚合的强化学习训练)
[] 🤖 HumanAgencyBench: Scalable Evaluation of Human Agency Support in AI Assistants(HumanAgencyBench:AI助手中人类代理支持的规模化评估)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 9 月 12 日 · 6 分钟
本期的 10 篇论文如下:
[] 🧠 A Survey of Reinforcement Learning for Large Reasoning Models(大型推理模型的强化学习综述)
[] 🔄 RewardDance: Reward Scaling in Visual Generation(RewardDance:视觉生成中的奖励缩放)
[] 🌐 3D and 4D World Modeling: A Survey(3D和4D世界建模:一项综述)
[] 🤖 AgentGym-RL: Training LLM Agents for Long-Horizon Decision Making through Multi-Turn Reinforcement Learning(AgentGym-RL: 通过多轮强化学习训练用于长视野决策制定的LLM智能体)
[] 🧩 P3-SAM: Native 3D Part Segmentation(P3-SAM:原生3D部分分割)
[] 🌐 Hunyuan-MT Technical Report(Hunyuan-MT技术报告)
[] ⚠ <think> So let's replace this phrase with insult... </think> Lessons learned from generation of toxic texts with LLMs(从LLM生成有毒文本中吸取的经验教训)
[] 🤖 EnvX: Agentize Everything with Agentic AI(EnvX:使用代理式AI实现万物代理化)
[] 🤔 The Majority is not always right: RL training for solution aggregation(多数并不总是正确:用于解决方案聚合的强化学习训练)
[] 🤖 HumanAgencyBench: Scalable Evaluation of Human Agency Support in AI Assistants(HumanAgencyBench:AI助手中人类代理支持的规模化评估)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟