H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

大家好,欢迎收听“Hugging Face 每日AI论文速递”。今天是2024年8月02日,我们将带您快速浏览16篇热门AI论文,涵盖图像与视频分割、多模态语言模型、3D网格重建等多个前沿领域。现在,让我们立即进入今天的论文速递。
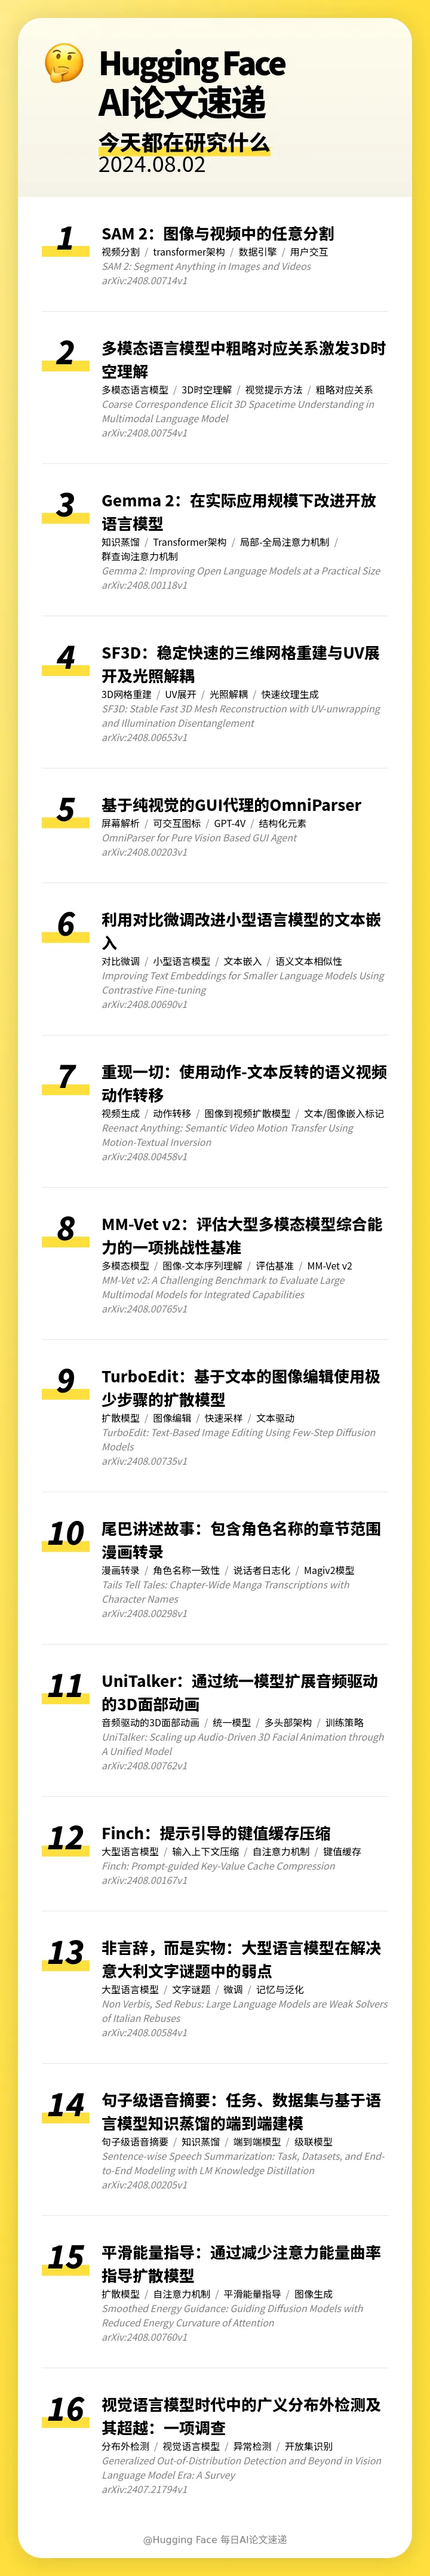
[] 🎥 SAM 2: Segment Anything in Images and Videos(SAM 2:图像与视频中的任意分割)
[] 🌐 Coarse Correspondence Elicit 3D Spacetime Understanding in Multimodal Language Model(多模态语言模型中粗略对应关系激发3D时空理解)
[] 🚀 Gemma 2: Improving Open Language Models at a Practical Size(Gemma 2:在实际应用规模下改进开放语言模型)
[] 🌐 SF3D: Stable Fast 3D Mesh Reconstruction with UV-unwrapping and Illumination Disentanglement(SF3D:稳定快速的三维网格重建与UV展开及光照解耦)
[] 📊 OmniParser for Pure Vision Based GUI Agent(基于纯视觉的GUI代理的OmniParser)
[] 📚 Improving Text Embeddings for Smaller Language Models Using Contrastive Fine-tuning(利用对比微调改进小型语言模型的文本嵌入)
[] 🎥 Reenact Anything: Semantic Video Motion Transfer Using Motion-Textual Inversion(重现一切:使用动作-文本反转的语义视频动作转移)
[] 📊 MM-Vet v2: A Challenging Benchmark to Evaluate Large Multimodal Models for Integrated Capabilities(MM-Vet v2:评估大型多模态模型综合能力的一项挑战性基准)
[] 🖼 TurboEdit: Text-Based Image Editing Using Few-Step Diffusion Models(TurboEdit:基于文本的图像编辑使用极少步骤的扩散模型)
[] 📖 Tails Tell Tales: Chapter-Wide Manga Transcriptions with Character Names(尾巴讲述故事:包含角色名称的章节范围漫画转录)
[] 🎭 UniTalker: Scaling up Audio-Driven 3D Facial Animation through A Unified Model(UniTalker:通过统一模型扩展音频驱动的3D面部动画)
[] 🚀 Finch: Prompt-guided Key-Value Cache Compression(Finch:提示引导的键值缓存压缩)
[] 🧩 Non Verbis, Sed Rebus: Large Language Models are Weak Solvers of Italian Rebuses(非言辞,而是实物:大型语言模型在解决意大利文字谜题中的弱点)
[] 📚 Sentence-wise Speech Summarization: Task, Datasets, and End-to-End Modeling with LM Knowledge Distillation(句子级语音摘要:任务、数据集与基于语言模型知识蒸馏的端到端建模)
[] 🌐 Smoothed Energy Guidance: Guiding Diffusion Models with Reduced Energy Curvature of Attention(平滑能量指导:通过减少注意力能量曲率指导扩散模型)
[] 📚 Generalized Out-of-Distribution Detection and Beyond in Vision Language Model Era: A Survey(视觉语言模型时代中的广义分布外检测及其超越:一项调查)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 8 月 3 日 · 11 分钟
大家好,欢迎收听“Hugging Face 每日AI论文速递”。今天是2024年8月02日,我们将带您快速浏览16篇热门AI论文,涵盖图像与视频分割、多模态语言模型、3D网格重建等多个前沿领域。现在,让我们立即进入今天的论文速递。
[] 🎥 SAM 2: Segment Anything in Images and Videos(SAM 2:图像与视频中的任意分割)
[] 🌐 Coarse Correspondence Elicit 3D Spacetime Understanding in Multimodal Language Model(多模态语言模型中粗略对应关系激发3D时空理解)
[] 🚀 Gemma 2: Improving Open Language Models at a Practical Size(Gemma 2:在实际应用规模下改进开放语言模型)
[] 🌐 SF3D: Stable Fast 3D Mesh Reconstruction with UV-unwrapping and Illumination Disentanglement(SF3D:稳定快速的三维网格重建与UV展开及光照解耦)
[] 📊 OmniParser for Pure Vision Based GUI Agent(基于纯视觉的GUI代理的OmniParser)
[] 📚 Improving Text Embeddings for Smaller Language Models Using Contrastive Fine-tuning(利用对比微调改进小型语言模型的文本嵌入)
[] 🎥 Reenact Anything: Semantic Video Motion Transfer Using Motion-Textual Inversion(重现一切:使用动作-文本反转的语义视频动作转移)
[] 📊 MM-Vet v2: A Challenging Benchmark to Evaluate Large Multimodal Models for Integrated Capabilities(MM-Vet v2:评估大型多模态模型综合能力的一项挑战性基准)
[] 🖼 TurboEdit: Text-Based Image Editing Using Few-Step Diffusion Models(TurboEdit:基于文本的图像编辑使用极少步骤的扩散模型)
[] 📖 Tails Tell Tales: Chapter-Wide Manga Transcriptions with Character Names(尾巴讲述故事:包含角色名称的章节范围漫画转录)
[] 🎭 UniTalker: Scaling up Audio-Driven 3D Facial Animation through A Unified Model(UniTalker:通过统一模型扩展音频驱动的3D面部动画)
[] 🚀 Finch: Prompt-guided Key-Value Cache Compression(Finch:提示引导的键值缓存压缩)
[] 🧩 Non Verbis, Sed Rebus: Large Language Models are Weak Solvers of Italian Rebuses(非言辞,而是实物:大型语言模型在解决意大利文字谜题中的弱点)
[] 📚 Sentence-wise Speech Summarization: Task, Datasets, and End-to-End Modeling with LM Knowledge Distillation(句子级语音摘要:任务、数据集与基于语言模型知识蒸馏的端到端建模)
[] 🌐 Smoothed Energy Guidance: Guiding Diffusion Models with Reduced Energy Curvature of Attention(平滑能量指导:通过减少注意力能量曲率指导扩散模型)
[] 📚 Generalized Out-of-Distribution Detection and Beyond in Vision Language Model Era: A Survey(视觉语言模型时代中的广义分布外检测及其超越:一项调查)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟