H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 23 篇论文如下:
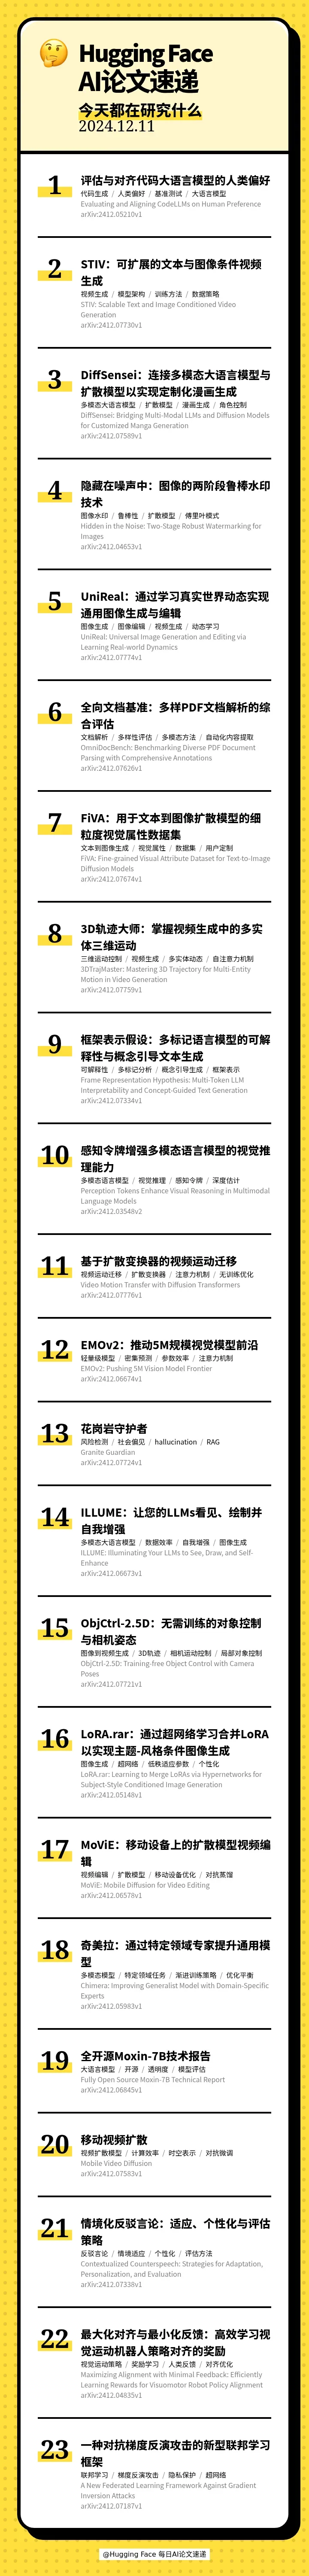
[] 🧑 Evaluating and Aligning CodeLLMs on Human Preference(评估与对齐代码大语言模型的人类偏好)
[] 🎥 STIV: Scalable Text and Image Conditioned Video Generation(STIV:可扩展的文本与图像条件视频生成)
[] 🎨 DiffSensei: Bridging Multi-Modal LLMs and Diffusion Models for Customized Manga Generation(DiffSensei:连接多模态大语言模型与扩散模型以实现定制化漫画生成)
[] 🔒 Hidden in the Noise: Two-Stage Robust Watermarking for Images(隐藏在噪声中:图像的两阶段鲁棒水印技术)
[] 🎥 UniReal: Universal Image Generation and Editing via Learning Real-world Dynamics(UniReal:通过学习真实世界动态实现通用图像生成与编辑)
[] 📄 OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations(全向文档基准:多样PDF文档解析的综合评估)
[] 🎨 FiVA: Fine-grained Visual Attribute Dataset for Text-to-Image Diffusion Models(FiVA:用于文本到图像扩散模型的细粒度视觉属性数据集)
[] 🎥 3DTrajMaster: Mastering 3D Trajectory for Multi-Entity Motion in Video Generation(3D轨迹大师:掌握视频生成中的多实体三维运动)
[] 🧠 Frame Representation Hypothesis: Multi-Token LLM Interpretability and Concept-Guided Text Generation(框架表示假设:多标记语言模型的可解释性与概念引导文本生成)
[] 🧠 Perception Tokens Enhance Visual Reasoning in Multimodal Language Models(感知令牌增强多模态语言模型的视觉推理能力)
[] 🎥 Video Motion Transfer with Diffusion Transformers(基于扩散变换器的视频运动迁移)
[] 🚀 EMOv2: Pushing 5M Vision Model Frontier(EMOv2:推动5M规模视觉模型前沿)
[] 🛡 Granite Guardian(花岗岩守护者)
[] 🌟 ILLUME: Illuminating Your LLMs to See, Draw, and Self-Enhance(ILLUME:让您的LLMs看见、绘制并自我增强)
[] 🎥 ObjCtrl-2.5D: Training-free Object Control with Camera Poses(ObjCtrl-2.5D:无需训练的对象控制与相机姿态)
[] 🚀 LoRA.rar: Learning to Merge LoRAs via Hypernetworks for Subject-Style Conditioned Image Generation(LoRA.rar:通过超网络学习合并LoRA以实现主题-风格条件图像生成)
[] 📱 MoViE: Mobile Diffusion for Video Editing(MoViE:移动设备上的扩散模型视频编辑)
[] 🧬 Chimera: Improving Generalist Model with Domain-Specific Experts(奇美拉:通过特定领域专家提升通用模型)
[] 🌐 Fully Open Source Moxin-7B Technical Report(全开源Moxin-7B技术报告)
[] 📱 Mobile Video Diffusion(移动视频扩散)
[] 🤖 Contextualized Counterspeech: Strategies for Adaptation, Personalization, and Evaluation(情境化反驳言论:适应、个性化与评估策略)
[] 🤖 Maximizing Alignment with Minimal Feedback: Efficiently Learning Rewards for Visuomotor Robot Policy Alignment(最大化对齐与最小化反馈:高效学习视觉运动机器人策略对齐的奖励)
[] 🔒 A New Federated Learning Framework Against Gradient Inversion Attacks(一种对抗梯度反演攻击的新型联邦学习框架)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 12 月 12 日 · 17 分钟
本期的 23 篇论文如下:
[] 🧑 Evaluating and Aligning CodeLLMs on Human Preference(评估与对齐代码大语言模型的人类偏好)
[] 🎥 STIV: Scalable Text and Image Conditioned Video Generation(STIV:可扩展的文本与图像条件视频生成)
[] 🎨 DiffSensei: Bridging Multi-Modal LLMs and Diffusion Models for Customized Manga Generation(DiffSensei:连接多模态大语言模型与扩散模型以实现定制化漫画生成)
[] 🔒 Hidden in the Noise: Two-Stage Robust Watermarking for Images(隐藏在噪声中:图像的两阶段鲁棒水印技术)
[] 🎥 UniReal: Universal Image Generation and Editing via Learning Real-world Dynamics(UniReal:通过学习真实世界动态实现通用图像生成与编辑)
[] 📄 OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations(全向文档基准:多样PDF文档解析的综合评估)
[] 🎨 FiVA: Fine-grained Visual Attribute Dataset for Text-to-Image Diffusion Models(FiVA:用于文本到图像扩散模型的细粒度视觉属性数据集)
[] 🎥 3DTrajMaster: Mastering 3D Trajectory for Multi-Entity Motion in Video Generation(3D轨迹大师:掌握视频生成中的多实体三维运动)
[] 🧠 Frame Representation Hypothesis: Multi-Token LLM Interpretability and Concept-Guided Text Generation(框架表示假设:多标记语言模型的可解释性与概念引导文本生成)
[] 🧠 Perception Tokens Enhance Visual Reasoning in Multimodal Language Models(感知令牌增强多模态语言模型的视觉推理能力)
[] 🎥 Video Motion Transfer with Diffusion Transformers(基于扩散变换器的视频运动迁移)
[] 🚀 EMOv2: Pushing 5M Vision Model Frontier(EMOv2:推动5M规模视觉模型前沿)
[] 🛡 Granite Guardian(花岗岩守护者)
[] 🌟 ILLUME: Illuminating Your LLMs to See, Draw, and Self-Enhance(ILLUME:让您的LLMs看见、绘制并自我增强)
[] 🎥 ObjCtrl-2.5D: Training-free Object Control with Camera Poses(ObjCtrl-2.5D:无需训练的对象控制与相机姿态)
[] 🚀 LoRA.rar: Learning to Merge LoRAs via Hypernetworks for Subject-Style Conditioned Image Generation(LoRA.rar:通过超网络学习合并LoRA以实现主题-风格条件图像生成)
[] 📱 MoViE: Mobile Diffusion for Video Editing(MoViE:移动设备上的扩散模型视频编辑)
[] 🧬 Chimera: Improving Generalist Model with Domain-Specific Experts(奇美拉:通过特定领域专家提升通用模型)
[] 🌐 Fully Open Source Moxin-7B Technical Report(全开源Moxin-7B技术报告)
[] 📱 Mobile Video Diffusion(移动视频扩散)
[] 🤖 Contextualized Counterspeech: Strategies for Adaptation, Personalization, and Evaluation(情境化反驳言论:适应、个性化与评估策略)
[] 🤖 Maximizing Alignment with Minimal Feedback: Efficiently Learning Rewards for Visuomotor Robot Policy Alignment(最大化对齐与最小化反馈:高效学习视觉运动机器人策略对齐的奖励)
[] 🔒 A New Federated Learning Framework Against Gradient Inversion Attacks(一种对抗梯度反演攻击的新型联邦学习框架)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟