H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 21 篇论文如下:
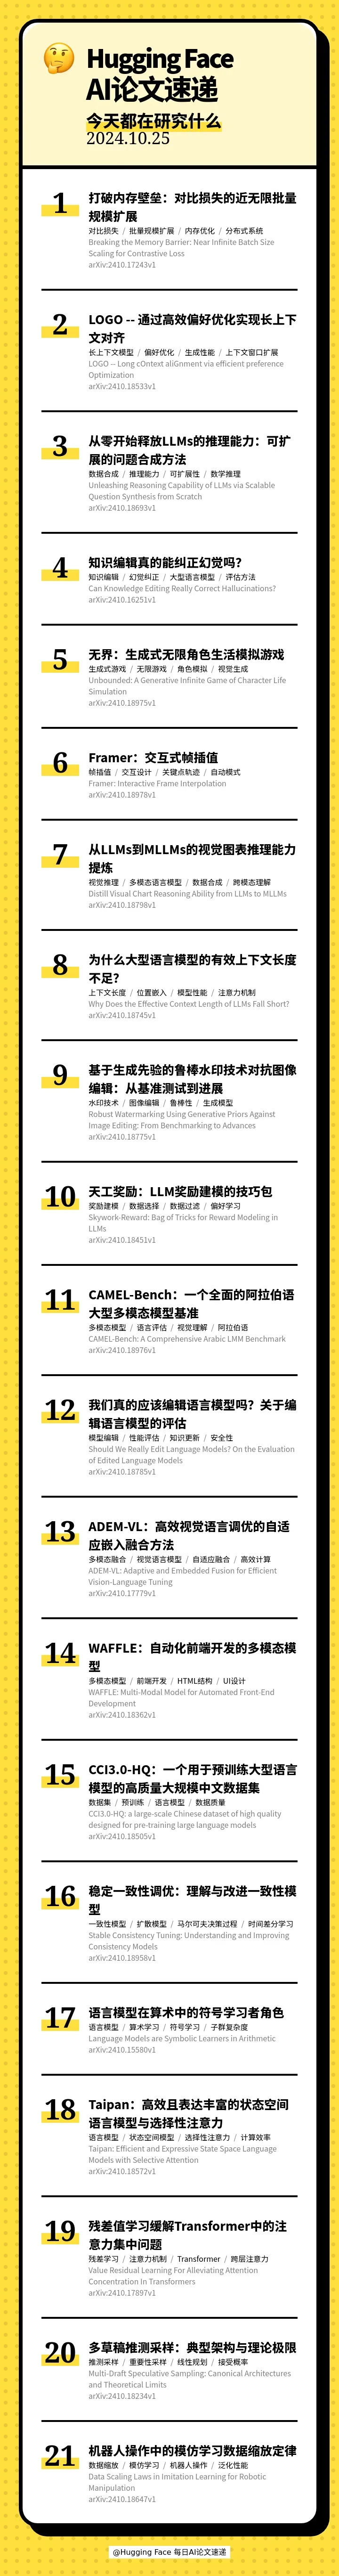
[] 🚀 Breaking the Memory Barrier: Near Infinite Batch Size Scaling for Contrastive Loss(打破内存壁垒:对比损失的近无限批量规模扩展)
[] 🔄 LOGO -- Long cOntext aliGnment via efficient preference Optimization(LOGO -- 通过高效偏好优化实现长上下文对齐)
[] 🧠 Unleashing Reasoning Capability of LLMs via Scalable Question Synthesis from Scratch(从零开始释放LLMs的推理能力:可扩展的问题合成方法)
[] 🤔 Can Knowledge Editing Really Correct Hallucinations?(知识编辑真的能纠正幻觉吗?)
[] 🎮 Unbounded: A Generative Infinite Game of Character Life Simulation(无界:生成式无限角色生活模拟游戏)
[] 🎥 Framer: Interactive Frame Interpolation(Framer:交互式帧插值)
[] 📊 Distill Visual Chart Reasoning Ability from LLMs to MLLMs(从LLMs到MLLMs的视觉图表推理能力提炼)
[] 📉 Why Does the Effective Context Length of LLMs Fall Short?(为什么大型语言模型的有效上下文长度不足?)
[] 🔒 Robust Watermarking Using Generative Priors Against Image Editing: From Benchmarking to Advances(基于生成先验的鲁棒水印技术对抗图像编辑:从基准测试到进展)
[] 🔧 Skywork-Reward: Bag of Tricks for Reward Modeling in LLMs(天工奖励:LLM奖励建模的技巧包)
[] 🌍 CAMEL-Bench: A Comprehensive Arabic LMM Benchmark(CAMEL-Bench:一个全面的阿拉伯语大型多模态模型基准)
[] 📊 Should We Really Edit Language Models? On the Evaluation of Edited Language Models(我们真的应该编辑语言模型吗?关于编辑语言模型的评估)
[] 🌐 ADEM-VL: Adaptive and Embedded Fusion for Efficient Vision-Language Tuning(ADEM-VL:高效视觉语言调优的自适应嵌入融合方法)
[] 🌐 WAFFLE: Multi-Modal Model for Automated Front-End Development(WAFFLE:自动化前端开发的多模态模型)
[] 📚 CCI3.0-HQ: a large-scale Chinese dataset of high quality designed for pre-training large language models(CCI3.0-HQ:一个用于预训练大型语言模型的高质量大规模中文数据集)
[] 🔄 Stable Consistency Tuning: Understanding and Improving Consistency Models(稳定一致性调优:理解与改进一致性模型)
[] 🧮 Language Models are Symbolic Learners in Arithmetic(语言模型在算术中的符号学习者角色)
[] 🐍 Taipan: Efficient and Expressive State Space Language Models with Selective Attention(Taipan:高效且表达丰富的状态空间语言模型与选择性注意力)
[] 🔄 Value Residual Learning For Alleviating Attention Concentration In Transformers(残差值学习缓解Transformer中的注意力集中问题)
[] 📚 Multi-Draft Speculative Sampling: Canonical Architectures and Theoretical Limits(多草稿推测采样:典型架构与理论极限)
[] 🤖 Data Scaling Laws in Imitation Learning for Robotic Manipulation(机器人操作中的模仿学习数据缩放定律)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 10 月 26 日 · 15 分钟
本期的 21 篇论文如下:
[] 🚀 Breaking the Memory Barrier: Near Infinite Batch Size Scaling for Contrastive Loss(打破内存壁垒:对比损失的近无限批量规模扩展)
[] 🔄 LOGO -- Long cOntext aliGnment via efficient preference Optimization(LOGO -- 通过高效偏好优化实现长上下文对齐)
[] 🧠 Unleashing Reasoning Capability of LLMs via Scalable Question Synthesis from Scratch(从零开始释放LLMs的推理能力:可扩展的问题合成方法)
[] 🤔 Can Knowledge Editing Really Correct Hallucinations?(知识编辑真的能纠正幻觉吗?)
[] 🎮 Unbounded: A Generative Infinite Game of Character Life Simulation(无界:生成式无限角色生活模拟游戏)
[] 🎥 Framer: Interactive Frame Interpolation(Framer:交互式帧插值)
[] 📊 Distill Visual Chart Reasoning Ability from LLMs to MLLMs(从LLMs到MLLMs的视觉图表推理能力提炼)
[] 📉 Why Does the Effective Context Length of LLMs Fall Short?(为什么大型语言模型的有效上下文长度不足?)
[] 🔒 Robust Watermarking Using Generative Priors Against Image Editing: From Benchmarking to Advances(基于生成先验的鲁棒水印技术对抗图像编辑:从基准测试到进展)
[] 🔧 Skywork-Reward: Bag of Tricks for Reward Modeling in LLMs(天工奖励:LLM奖励建模的技巧包)
[] 🌍 CAMEL-Bench: A Comprehensive Arabic LMM Benchmark(CAMEL-Bench:一个全面的阿拉伯语大型多模态模型基准)
[] 📊 Should We Really Edit Language Models? On the Evaluation of Edited Language Models(我们真的应该编辑语言模型吗?关于编辑语言模型的评估)
[] 🌐 ADEM-VL: Adaptive and Embedded Fusion for Efficient Vision-Language Tuning(ADEM-VL:高效视觉语言调优的自适应嵌入融合方法)
[] 🌐 WAFFLE: Multi-Modal Model for Automated Front-End Development(WAFFLE:自动化前端开发的多模态模型)
[] 📚 CCI3.0-HQ: a large-scale Chinese dataset of high quality designed for pre-training large language models(CCI3.0-HQ:一个用于预训练大型语言模型的高质量大规模中文数据集)
[] 🔄 Stable Consistency Tuning: Understanding and Improving Consistency Models(稳定一致性调优:理解与改进一致性模型)
[] 🧮 Language Models are Symbolic Learners in Arithmetic(语言模型在算术中的符号学习者角色)
[] 🐍 Taipan: Efficient and Expressive State Space Language Models with Selective Attention(Taipan:高效且表达丰富的状态空间语言模型与选择性注意力)
[] 🔄 Value Residual Learning For Alleviating Attention Concentration In Transformers(残差值学习缓解Transformer中的注意力集中问题)
[] 📚 Multi-Draft Speculative Sampling: Canonical Architectures and Theoretical Limits(多草稿推测采样:典型架构与理论极限)
[] 🤖 Data Scaling Laws in Imitation Learning for Robotic Manipulation(机器人操作中的模仿学习数据缩放定律)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟