H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

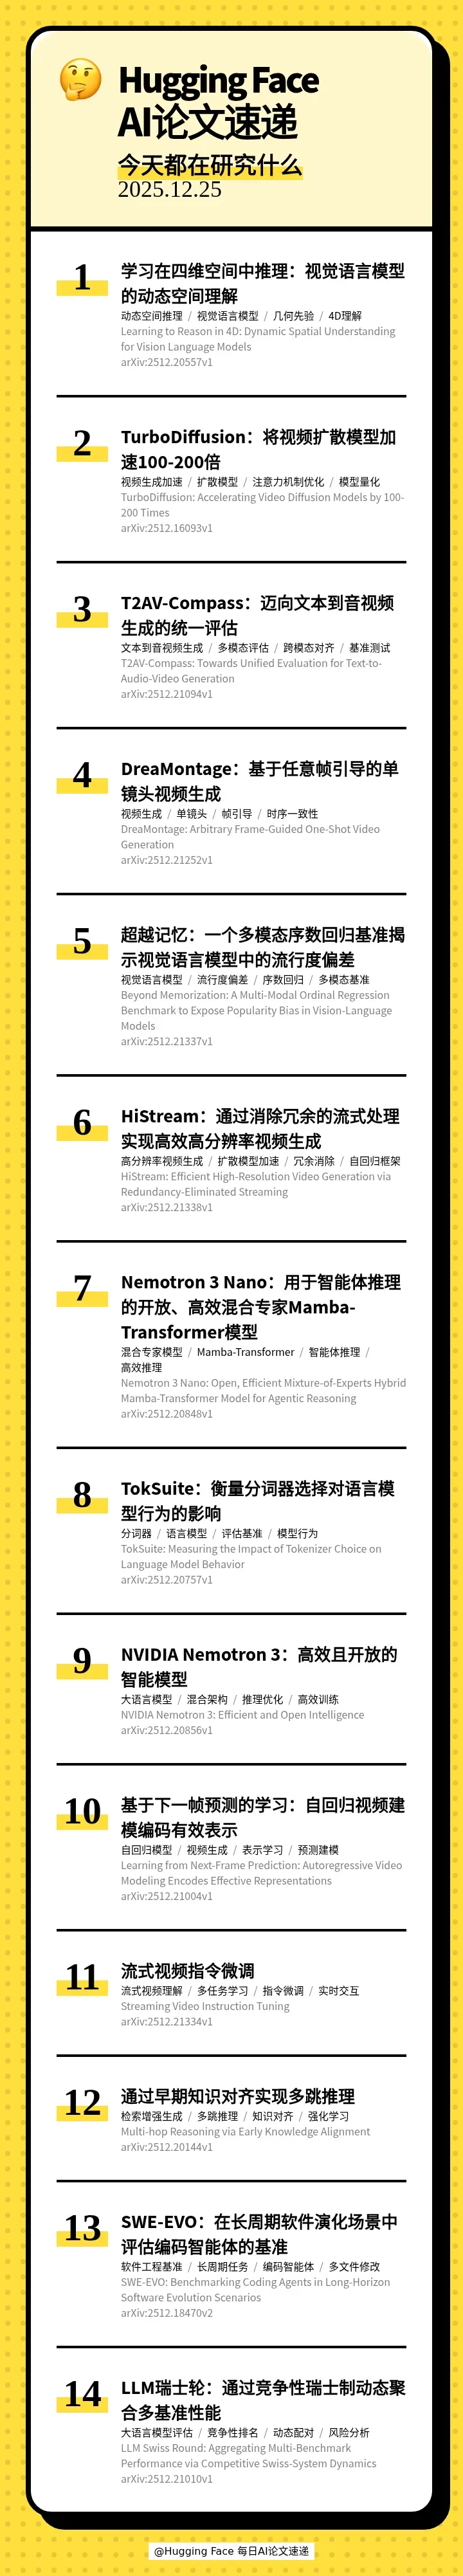
本期的 14 篇论文如下:
[] 🧠 Learning to Reason in 4D: Dynamic Spatial Understanding for Vision Language Models(学习在四维空间中推理:视觉语言模型的动态空间理解)
[] ⚡ TurboDiffusion: Accelerating Video Diffusion Models by 100-200 Times(TurboDiffusion:将视频扩散模型加速100-200倍)
[] 🧭 T2AV-Compass: Towards Unified Evaluation for Text-to-Audio-Video Generation(T2AV-Compass:迈向文本到音视频生成的统一评估)
[] 🎬 DreaMontage: Arbitrary Frame-Guided One-Shot Video Generation(DreaMontage:基于任意帧引导的单镜头视频生成)
[] 🔍 Beyond Memorization: A Multi-Modal Ordinal Regression Benchmark to Expose Popularity Bias in Vision-Language Models(超越记忆:一个多模态序数回归基准揭示视觉语言模型中的流行度偏差)
[] 🎬 HiStream: Efficient High-Resolution Video Generation via Redundancy-Eliminated Streaming(HiStream:通过消除冗余的流式处理实现高效高分辨率视频生成)
[] 🚀 Nemotron 3 Nano: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning(Nemotron 3 Nano:用于智能体推理的开放、高效混合专家Mamba-Transformer模型)
[] 🔍 TokSuite: Measuring the Impact of Tokenizer Choice on Language Model Behavior(TokSuite:衡量分词器选择对语言模型行为的影响)
[] 🚀 NVIDIA Nemotron 3: Efficient and Open Intelligence(NVIDIA Nemotron 3:高效且开放的智能模型)
[] 🎬 Learning from Next-Frame Prediction: Autoregressive Video Modeling Encodes Effective Representations(基于下一帧预测的学习:自回归视频建模编码有效表示)
[] 🎬 Streaming Video Instruction Tuning(流式视频指令微调)
[] 🧠 Multi-hop Reasoning via Early Knowledge Alignment(通过早期知识对齐实现多跳推理)
[] 📊 SWE-EVO: Benchmarking Coding Agents in Long-Horizon Software Evolution Scenarios(SWE-EVO:在长周期软件演化场景中评估编码智能体的基准)
[] 🏆 LLM Swiss Round: Aggregating Multi-Benchmark Performance via Competitive Swiss-System Dynamics(LLM瑞士轮:通过竞争性瑞士制动态聚合多基准性能)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 12 月 26 日 · 10 分钟
本期的 14 篇论文如下:
[] 🧠 Learning to Reason in 4D: Dynamic Spatial Understanding for Vision Language Models(学习在四维空间中推理:视觉语言模型的动态空间理解)
[] ⚡ TurboDiffusion: Accelerating Video Diffusion Models by 100-200 Times(TurboDiffusion:将视频扩散模型加速100-200倍)
[] 🧭 T2AV-Compass: Towards Unified Evaluation for Text-to-Audio-Video Generation(T2AV-Compass:迈向文本到音视频生成的统一评估)
[] 🎬 DreaMontage: Arbitrary Frame-Guided One-Shot Video Generation(DreaMontage:基于任意帧引导的单镜头视频生成)
[] 🔍 Beyond Memorization: A Multi-Modal Ordinal Regression Benchmark to Expose Popularity Bias in Vision-Language Models(超越记忆:一个多模态序数回归基准揭示视觉语言模型中的流行度偏差)
[] 🎬 HiStream: Efficient High-Resolution Video Generation via Redundancy-Eliminated Streaming(HiStream:通过消除冗余的流式处理实现高效高分辨率视频生成)
[] 🚀 Nemotron 3 Nano: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning(Nemotron 3 Nano:用于智能体推理的开放、高效混合专家Mamba-Transformer模型)
[] 🔍 TokSuite: Measuring the Impact of Tokenizer Choice on Language Model Behavior(TokSuite:衡量分词器选择对语言模型行为的影响)
[] 🚀 NVIDIA Nemotron 3: Efficient and Open Intelligence(NVIDIA Nemotron 3:高效且开放的智能模型)
[] 🎬 Learning from Next-Frame Prediction: Autoregressive Video Modeling Encodes Effective Representations(基于下一帧预测的学习:自回归视频建模编码有效表示)
[] 🎬 Streaming Video Instruction Tuning(流式视频指令微调)
[] 🧠 Multi-hop Reasoning via Early Knowledge Alignment(通过早期知识对齐实现多跳推理)
[] 📊 SWE-EVO: Benchmarking Coding Agents in Long-Horizon Software Evolution Scenarios(SWE-EVO:在长周期软件演化场景中评估编码智能体的基准)
[] 🏆 LLM Swiss Round: Aggregating Multi-Benchmark Performance via Competitive Swiss-System Dynamics(LLM瑞士轮:通过竞争性瑞士制动态聚合多基准性能)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟