H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 14 篇论文如下:
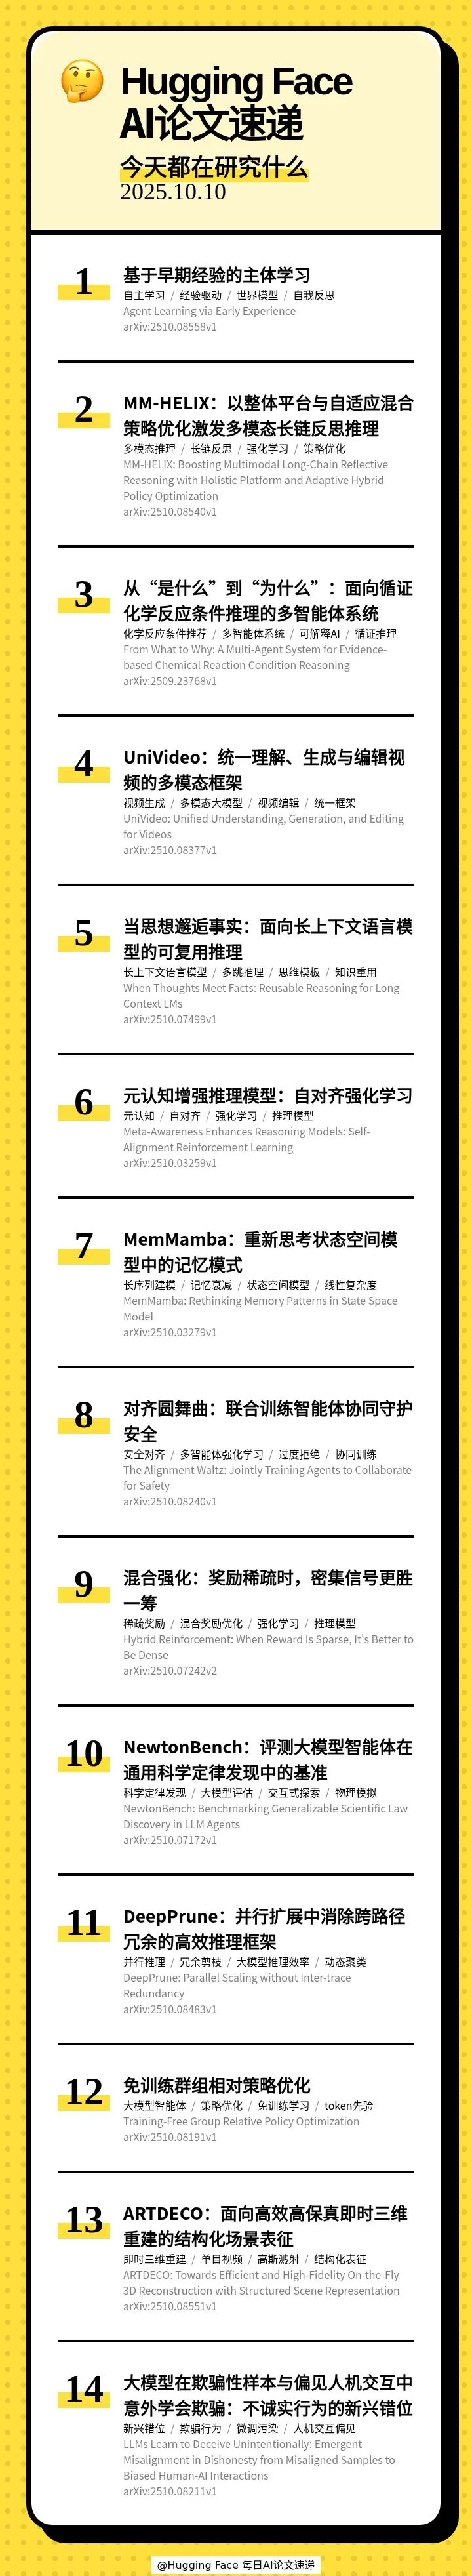
[] 🌱 Agent Learning via Early Experience(基于早期经验的主体学习)
[] 🧠 MM-HELIX: Boosting Multimodal Long-Chain Reflective Reasoning with Holistic Platform and Adaptive Hybrid Policy Optimization(MM-HELIX:以整体平台与自适应混合策略优化激发多模态长链反思推理)
[] 🧪 From What to Why: A Multi-Agent System for Evidence-based Chemical Reaction Condition Reasoning(从“是什么”到“为什么”:面向循证化学反应条件推理的多智能体系统)
[] 🎬 UniVideo: Unified Understanding, Generation, and Editing for Videos(UniVideo:统一理解、生成与编辑视频的多模态框架)
[] 🧠 When Thoughts Meet Facts: Reusable Reasoning for Long-Context LMs(当思想邂逅事实:面向长上下文语言模型的可复用推理)
[] 🧠 Meta-Awareness Enhances Reasoning Models: Self-Alignment Reinforcement Learning(元认知增强推理模型:自对齐强化学习)
[] 🧠 MemMamba: Rethinking Memory Patterns in State Space Model(MemMamba:重新思考状态空间模型中的记忆模式)
[] 🛡 The Alignment Waltz: Jointly Training Agents to Collaborate for Safety(对齐圆舞曲:联合训练智能体协同守护安全)
[] 🎯 Hybrid Reinforcement: When Reward Is Sparse, It's Better to Be Dense(混合强化:奖励稀疏时,密集信号更胜一筹)
[] 🧪 NewtonBench: Benchmarking Generalizable Scientific Law Discovery in LLM Agents(NewtonBench:评测大模型智能体在通用科学定律发现中的基准)
[] 🪚 DeepPrune: Parallel Scaling without Inter-trace Redundancy(DeepPrune:并行扩展中消除跨路径冗余的高效推理框架)
[] 🚀 Training-Free Group Relative Policy Optimization(免训练群组相对策略优化)
[] 🪄 ARTDECO: Towards Efficient and High-Fidelity On-the-Fly 3D Reconstruction with Structured Scene Representation(ARTDECO:面向高效高保真即时三维重建的结构化场景表征)
[] 🤥 LLMs Learn to Deceive Unintentionally: Emergent Misalignment in Dishonesty from Misaligned Samples to Biased Human-AI Interactions(大模型在欺骗性样本与偏见人机交互中意外学会欺骗:不诚实行为的新兴错位)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 11 日 · 10 分钟
本期的 14 篇论文如下:
[] 🌱 Agent Learning via Early Experience(基于早期经验的主体学习)
[] 🧠 MM-HELIX: Boosting Multimodal Long-Chain Reflective Reasoning with Holistic Platform and Adaptive Hybrid Policy Optimization(MM-HELIX:以整体平台与自适应混合策略优化激发多模态长链反思推理)
[] 🧪 From What to Why: A Multi-Agent System for Evidence-based Chemical Reaction Condition Reasoning(从“是什么”到“为什么”:面向循证化学反应条件推理的多智能体系统)
[] 🎬 UniVideo: Unified Understanding, Generation, and Editing for Videos(UniVideo:统一理解、生成与编辑视频的多模态框架)
[] 🧠 When Thoughts Meet Facts: Reusable Reasoning for Long-Context LMs(当思想邂逅事实:面向长上下文语言模型的可复用推理)
[] 🧠 Meta-Awareness Enhances Reasoning Models: Self-Alignment Reinforcement Learning(元认知增强推理模型:自对齐强化学习)
[] 🧠 MemMamba: Rethinking Memory Patterns in State Space Model(MemMamba:重新思考状态空间模型中的记忆模式)
[] 🛡 The Alignment Waltz: Jointly Training Agents to Collaborate for Safety(对齐圆舞曲:联合训练智能体协同守护安全)
[] 🎯 Hybrid Reinforcement: When Reward Is Sparse, It's Better to Be Dense(混合强化:奖励稀疏时,密集信号更胜一筹)
[] 🧪 NewtonBench: Benchmarking Generalizable Scientific Law Discovery in LLM Agents(NewtonBench:评测大模型智能体在通用科学定律发现中的基准)
[] 🪚 DeepPrune: Parallel Scaling without Inter-trace Redundancy(DeepPrune:并行扩展中消除跨路径冗余的高效推理框架)
[] 🚀 Training-Free Group Relative Policy Optimization(免训练群组相对策略优化)
[] 🪄 ARTDECO: Towards Efficient and High-Fidelity On-the-Fly 3D Reconstruction with Structured Scene Representation(ARTDECO:面向高效高保真即时三维重建的结构化场景表征)
[] 🤥 LLMs Learn to Deceive Unintentionally: Emergent Misalignment in Dishonesty from Misaligned Samples to Biased Human-AI Interactions(大模型在欺骗性样本与偏见人机交互中意外学会欺骗:不诚实行为的新兴错位)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟