H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
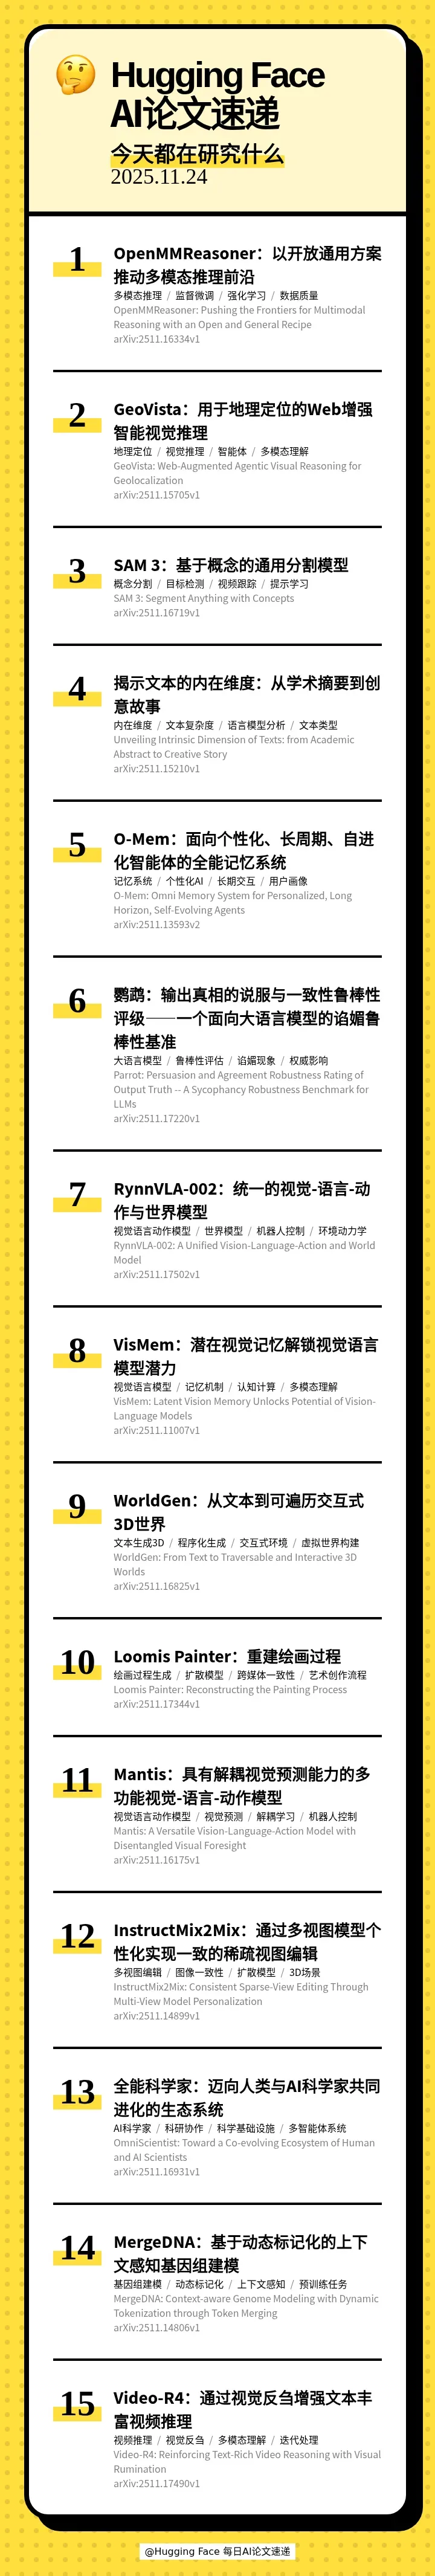
[] 🧠 OpenMMReasoner: Pushing the Frontiers for Multimodal Reasoning with an Open and General Recipe(OpenMMReasoner:以开放通用方案推动多模态推理前沿)
[] 🌍 GeoVista: Web-Augmented Agentic Visual Reasoning for Geolocalization(GeoVista:用于地理定位的Web增强智能视觉推理)
[] 🎯 SAM 3: Segment Anything with Concepts(SAM 3:基于概念的通用分割模型)
[] 📊 Unveiling Intrinsic Dimension of Texts: from Academic Abstract to Creative Story(揭示文本的内在维度:从学术摘要到创意故事)
[] 🧠 O-Mem: Omni Memory System for Personalized, Long Horizon, Self-Evolving Agents(O-Mem:面向个性化、长周期、自进化智能体的全能记忆系统)
[] 🦜 Parrot: Persuasion and Agreement Robustness Rating of Output Truth -- A Sycophancy Robustness Benchmark for LLMs(鹦鹉:输出真相的说服与一致性鲁棒性评级——一个面向大语言模型的谄媚鲁棒性基准)
[] 🧠 RynnVLA-002: A Unified Vision-Language-Action and World Model(RynnVLA-002:统一的视觉-语言-动作与世界模型)
[] 🧠 VisMem: Latent Vision Memory Unlocks Potential of Vision-Language Models(VisMem:潜在视觉记忆解锁视觉语言模型潜力)
[] 🌍 WorldGen: From Text to Traversable and Interactive 3D Worlds(WorldGen:从文本到可遍历交互式3D世界)
[] 🎨 Loomis Painter: Reconstructing the Painting Process(Loomis Painter:重建绘画过程)
[] 🔮 Mantis: A Versatile Vision-Language-Action Model with Disentangled Visual Foresight(Mantis:具有解耦视觉预测能力的多功能视觉-语言-动作模型)
[] 🎨 InstructMix2Mix: Consistent Sparse-View Editing Through Multi-View Model Personalization(InstructMix2Mix:通过多视图模型个性化实现一致的稀疏视图编辑)
[] 🔬 OmniScientist: Toward a Co-evolving Ecosystem of Human and AI Scientists(全能科学家:迈向人类与AI科学家共同进化的生态系统)
[] 🧬 MergeDNA: Context-aware Genome Modeling with Dynamic Tokenization through Token Merging(MergeDNA:基于动态标记化的上下文感知基因组建模)
[] 🔍 Video-R4: Reinforcing Text-Rich Video Reasoning with Visual Rumination(Video-R4:通过视觉反刍增强文本丰富视频推理)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 11 月 25 日 · 11 分钟
本期的 15 篇论文如下:
[] 🧠 OpenMMReasoner: Pushing the Frontiers for Multimodal Reasoning with an Open and General Recipe(OpenMMReasoner:以开放通用方案推动多模态推理前沿)
[] 🌍 GeoVista: Web-Augmented Agentic Visual Reasoning for Geolocalization(GeoVista:用于地理定位的Web增强智能视觉推理)
[] 🎯 SAM 3: Segment Anything with Concepts(SAM 3:基于概念的通用分割模型)
[] 📊 Unveiling Intrinsic Dimension of Texts: from Academic Abstract to Creative Story(揭示文本的内在维度:从学术摘要到创意故事)
[] 🧠 O-Mem: Omni Memory System for Personalized, Long Horizon, Self-Evolving Agents(O-Mem:面向个性化、长周期、自进化智能体的全能记忆系统)
[] 🦜 Parrot: Persuasion and Agreement Robustness Rating of Output Truth -- A Sycophancy Robustness Benchmark for LLMs(鹦鹉:输出真相的说服与一致性鲁棒性评级——一个面向大语言模型的谄媚鲁棒性基准)
[] 🧠 RynnVLA-002: A Unified Vision-Language-Action and World Model(RynnVLA-002:统一的视觉-语言-动作与世界模型)
[] 🧠 VisMem: Latent Vision Memory Unlocks Potential of Vision-Language Models(VisMem:潜在视觉记忆解锁视觉语言模型潜力)
[] 🌍 WorldGen: From Text to Traversable and Interactive 3D Worlds(WorldGen:从文本到可遍历交互式3D世界)
[] 🎨 Loomis Painter: Reconstructing the Painting Process(Loomis Painter:重建绘画过程)
[] 🔮 Mantis: A Versatile Vision-Language-Action Model with Disentangled Visual Foresight(Mantis:具有解耦视觉预测能力的多功能视觉-语言-动作模型)
[] 🎨 InstructMix2Mix: Consistent Sparse-View Editing Through Multi-View Model Personalization(InstructMix2Mix:通过多视图模型个性化实现一致的稀疏视图编辑)
[] 🔬 OmniScientist: Toward a Co-evolving Ecosystem of Human and AI Scientists(全能科学家:迈向人类与AI科学家共同进化的生态系统)
[] 🧬 MergeDNA: Context-aware Genome Modeling with Dynamic Tokenization through Token Merging(MergeDNA:基于动态标记化的上下文感知基因组建模)
[] 🔍 Video-R4: Reinforcing Text-Rich Video Reasoning with Visual Rumination(Video-R4:通过视觉反刍增强文本丰富视频推理)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟