H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
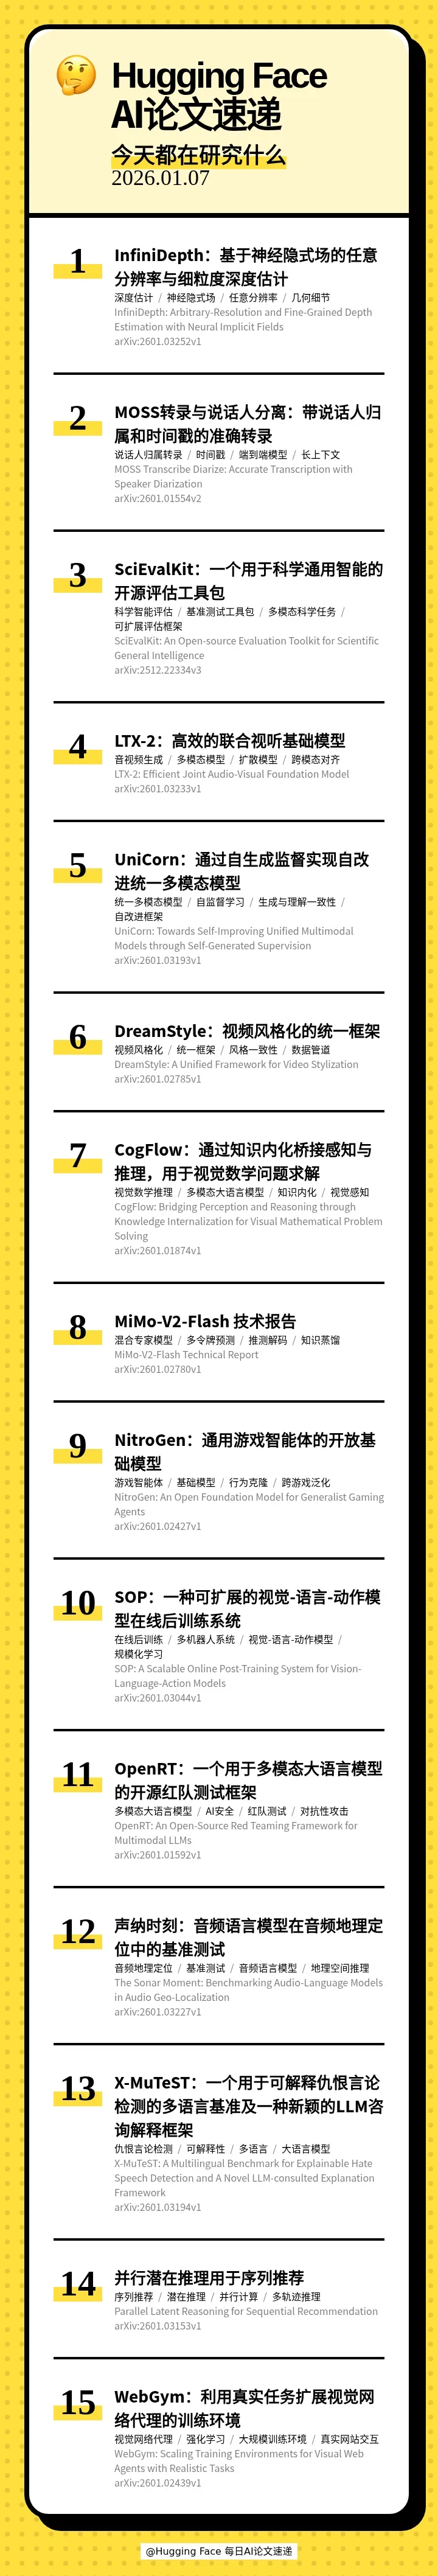
[] 🔍 InfiniDepth: Arbitrary-Resolution and Fine-Grained Depth Estimation with Neural Implicit Fields(InfiniDepth:基于神经隐式场的任意分辨率与细粒度深度估计)
[] 🎙 MOSS Transcribe Diarize: Accurate Transcription with Speaker Diarization(MOSS转录与说话人分离:带说话人归属和时间戳的准确转录)
[] 🔬 SciEvalKit: An Open-source Evaluation Toolkit for Scientific General Intelligence(SciEvalKit:一个用于科学通用智能的开源评估工具包)
[] 🎬 LTX-2: Efficient Joint Audio-Visual Foundation Model(LTX-2:高效的联合视听基础模型)
[] 🦄 UniCorn: Towards Self-Improving Unified Multimodal Models through Self-Generated Supervision(UniCorn:通过自生成监督实现自改进统一多模态模型)
[] 🎨 DreamStyle: A Unified Framework for Video Stylization(DreamStyle:视频风格化的统一框架)
[] 🧠 CogFlow: Bridging Perception and Reasoning through Knowledge Internalization for Visual Mathematical Problem Solving(CogFlow:通过知识内化桥接感知与推理,用于视觉数学问题求解)
[] ⚡ MiMo-V2-Flash Technical Report(MiMo-V2-Flash 技术报告)
[] 🎮 NitroGen: An Open Foundation Model for Generalist Gaming Agents(NitroGen:通用游戏智能体的开放基础模型)
[] 🤖 SOP: A Scalable Online Post-Training System for Vision-Language-Action Models(SOP:一种可扩展的视觉-语言-动作模型在线后训练系统)
[] 🛡 OpenRT: An Open-Source Red Teaming Framework for Multimodal LLMs(OpenRT:一个用于多模态大语言模型的开源红队测试框架)
[] 📍 The Sonar Moment: Benchmarking Audio-Language Models in Audio Geo-Localization(声纳时刻:音频语言模型在音频地理定位中的基准测试)
[] 🔍 X-MuTeST: A Multilingual Benchmark for Explainable Hate Speech Detection and A Novel LLM-consulted Explanation Framework(X-MuTeST:一个用于可解释仇恨言论检测的多语言基准及一种新颖的LLM咨询解释框架)
[] 🧠 Parallel Latent Reasoning for Sequential Recommendation(并行潜在推理用于序列推荐)
[] 🤖 WebGym: Scaling Training Environments for Visual Web Agents with Realistic Tasks(WebGym:利用真实任务扩展视觉网络代理的训练环境)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 1 月 8 日 · 12 分钟
本期的 15 篇论文如下:
[] 🔍 InfiniDepth: Arbitrary-Resolution and Fine-Grained Depth Estimation with Neural Implicit Fields(InfiniDepth:基于神经隐式场的任意分辨率与细粒度深度估计)
[] 🎙 MOSS Transcribe Diarize: Accurate Transcription with Speaker Diarization(MOSS转录与说话人分离:带说话人归属和时间戳的准确转录)
[] 🔬 SciEvalKit: An Open-source Evaluation Toolkit for Scientific General Intelligence(SciEvalKit:一个用于科学通用智能的开源评估工具包)
[] 🎬 LTX-2: Efficient Joint Audio-Visual Foundation Model(LTX-2:高效的联合视听基础模型)
[] 🦄 UniCorn: Towards Self-Improving Unified Multimodal Models through Self-Generated Supervision(UniCorn:通过自生成监督实现自改进统一多模态模型)
[] 🎨 DreamStyle: A Unified Framework for Video Stylization(DreamStyle:视频风格化的统一框架)
[] 🧠 CogFlow: Bridging Perception and Reasoning through Knowledge Internalization for Visual Mathematical Problem Solving(CogFlow:通过知识内化桥接感知与推理,用于视觉数学问题求解)
[] ⚡ MiMo-V2-Flash Technical Report(MiMo-V2-Flash 技术报告)
[] 🎮 NitroGen: An Open Foundation Model for Generalist Gaming Agents(NitroGen:通用游戏智能体的开放基础模型)
[] 🤖 SOP: A Scalable Online Post-Training System for Vision-Language-Action Models(SOP:一种可扩展的视觉-语言-动作模型在线后训练系统)
[] 🛡 OpenRT: An Open-Source Red Teaming Framework for Multimodal LLMs(OpenRT:一个用于多模态大语言模型的开源红队测试框架)
[] 📍 The Sonar Moment: Benchmarking Audio-Language Models in Audio Geo-Localization(声纳时刻:音频语言模型在音频地理定位中的基准测试)
[] 🔍 X-MuTeST: A Multilingual Benchmark for Explainable Hate Speech Detection and A Novel LLM-consulted Explanation Framework(X-MuTeST:一个用于可解释仇恨言论检测的多语言基准及一种新颖的LLM咨询解释框架)
[] 🧠 Parallel Latent Reasoning for Sequential Recommendation(并行潜在推理用于序列推荐)
[] 🤖 WebGym: Scaling Training Environments for Visual Web Agents with Realistic Tasks(WebGym:利用真实任务扩展视觉网络代理的训练环境)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟