H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

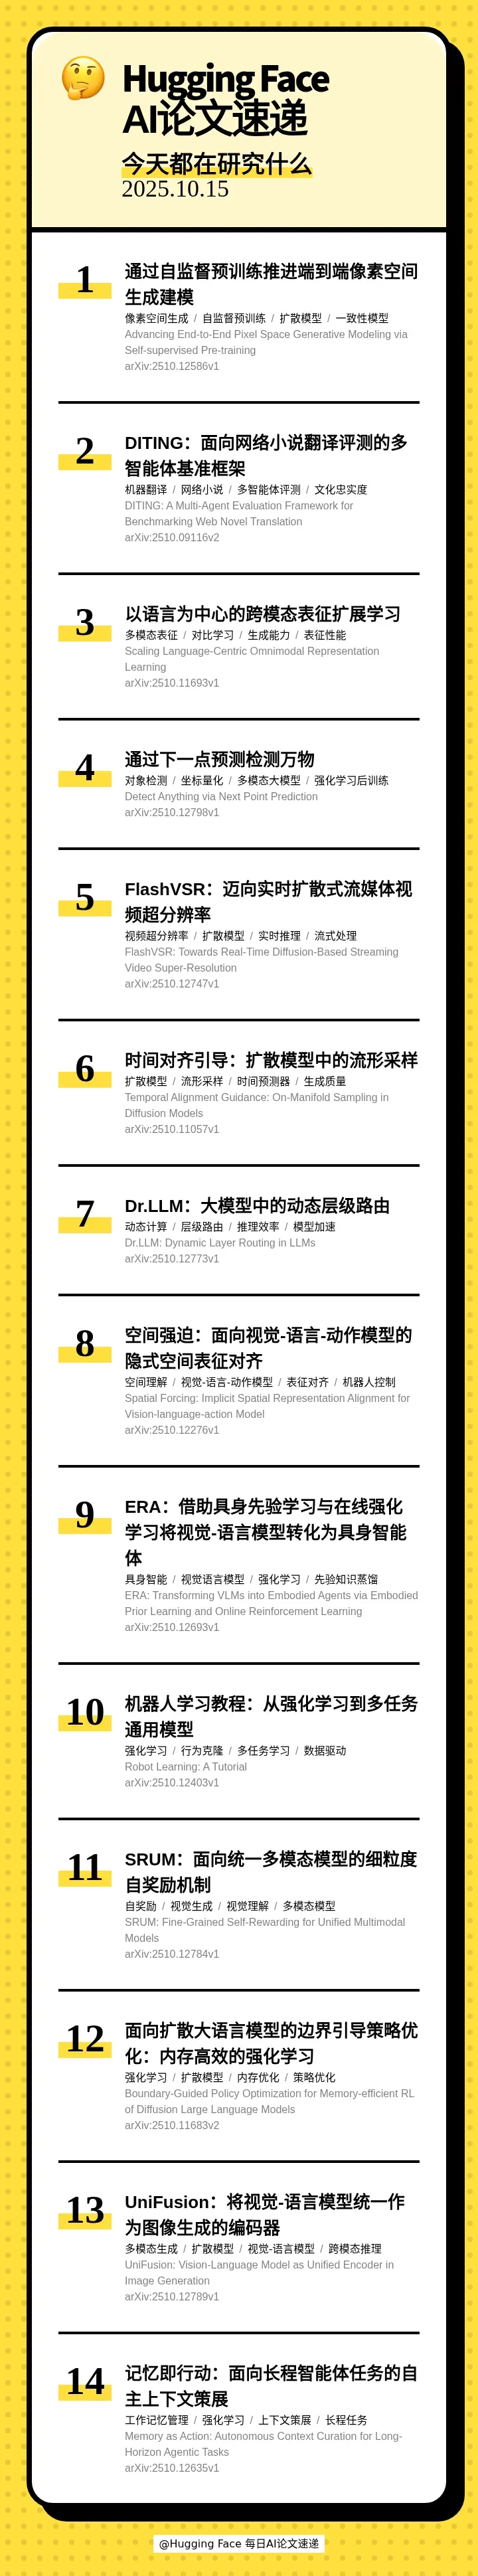
本期的 14 篇论文如下:
[] 🖼 Advancing End-to-End Pixel Space Generative Modeling via Self-supervised Pre-training(通过自监督预训练推进端到端像素空间生成建模)
[] 📚 DITING: A Multi-Agent Evaluation Framework for Benchmarking Web Novel Translation(DITING:面向网络小说翻译评测的多智能体基准框架)
[] 🌐 Scaling Language-Centric Omnimodal Representation Learning(以语言为中心的跨模态表征扩展学习)
[] 🎯 Detect Anything via Next Point Prediction(通过下一点预测检测万物)
[] ⚡ FlashVSR: Towards Real-Time Diffusion-Based Streaming Video Super-Resolution(FlashVSR:迈向实时扩散式流媒体视频超分辨率)
[] 🎯 Temporal Alignment Guidance: On-Manifold Sampling in Diffusion Models(时间对齐引导:扩散模型中的流形采样)
[] 🧠 Dr.LLM: Dynamic Layer Routing in LLMs(Dr.LLM:大模型中的动态层级路由)
[] 🎯 Spatial Forcing: Implicit Spatial Representation Alignment for Vision-language-action Model(空间强迫:面向视觉-语言-动作模型的隐式空间表征对齐)
[] 🤖 ERA: Transforming VLMs into Embodied Agents via Embodied Prior Learning and Online Reinforcement Learning(ERA:借助具身先验学习与在线强化学习将视觉-语言模型转化为具身智能体)
[] 🤖 Robot Learning: A Tutorial(机器人学习教程:从强化学习到多任务通用模型)
[] 🔄 SRUM: Fine-Grained Self-Rewarding for Unified Multimodal Models(SRUM:面向统一多模态模型的细粒度自奖励机制)
[] 🧠 Boundary-Guided Policy Optimization for Memory-efficient RL of Diffusion Large Language Models(面向扩散大语言模型的边界引导策略优化:内存高效的强化学习)
[] 🖼 UniFusion: Vision-Language Model as Unified Encoder in Image Generation(UniFusion:将视觉-语言模型统一作为图像生成的编码器)
[] 🧠 Memory as Action: Autonomous Context Curation for Long-Horizon Agentic Tasks(记忆即行动:面向长程智能体任务的自主上下文策展)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 16 日 · 11 分钟
本期的 14 篇论文如下:
[] 🖼 Advancing End-to-End Pixel Space Generative Modeling via Self-supervised Pre-training(通过自监督预训练推进端到端像素空间生成建模)
[] 📚 DITING: A Multi-Agent Evaluation Framework for Benchmarking Web Novel Translation(DITING:面向网络小说翻译评测的多智能体基准框架)
[] 🌐 Scaling Language-Centric Omnimodal Representation Learning(以语言为中心的跨模态表征扩展学习)
[] 🎯 Detect Anything via Next Point Prediction(通过下一点预测检测万物)
[] ⚡ FlashVSR: Towards Real-Time Diffusion-Based Streaming Video Super-Resolution(FlashVSR:迈向实时扩散式流媒体视频超分辨率)
[] 🎯 Temporal Alignment Guidance: On-Manifold Sampling in Diffusion Models(时间对齐引导:扩散模型中的流形采样)
[] 🧠 Dr.LLM: Dynamic Layer Routing in LLMs(Dr.LLM:大模型中的动态层级路由)
[] 🎯 Spatial Forcing: Implicit Spatial Representation Alignment for Vision-language-action Model(空间强迫:面向视觉-语言-动作模型的隐式空间表征对齐)
[] 🤖 ERA: Transforming VLMs into Embodied Agents via Embodied Prior Learning and Online Reinforcement Learning(ERA:借助具身先验学习与在线强化学习将视觉-语言模型转化为具身智能体)
[] 🤖 Robot Learning: A Tutorial(机器人学习教程:从强化学习到多任务通用模型)
[] 🔄 SRUM: Fine-Grained Self-Rewarding for Unified Multimodal Models(SRUM:面向统一多模态模型的细粒度自奖励机制)
[] 🧠 Boundary-Guided Policy Optimization for Memory-efficient RL of Diffusion Large Language Models(面向扩散大语言模型的边界引导策略优化:内存高效的强化学习)
[] 🖼 UniFusion: Vision-Language Model as Unified Encoder in Image Generation(UniFusion:将视觉-语言模型统一作为图像生成的编码器)
[] 🧠 Memory as Action: Autonomous Context Curation for Long-Horizon Agentic Tasks(记忆即行动:面向长程智能体任务的自主上下文策展)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟