H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
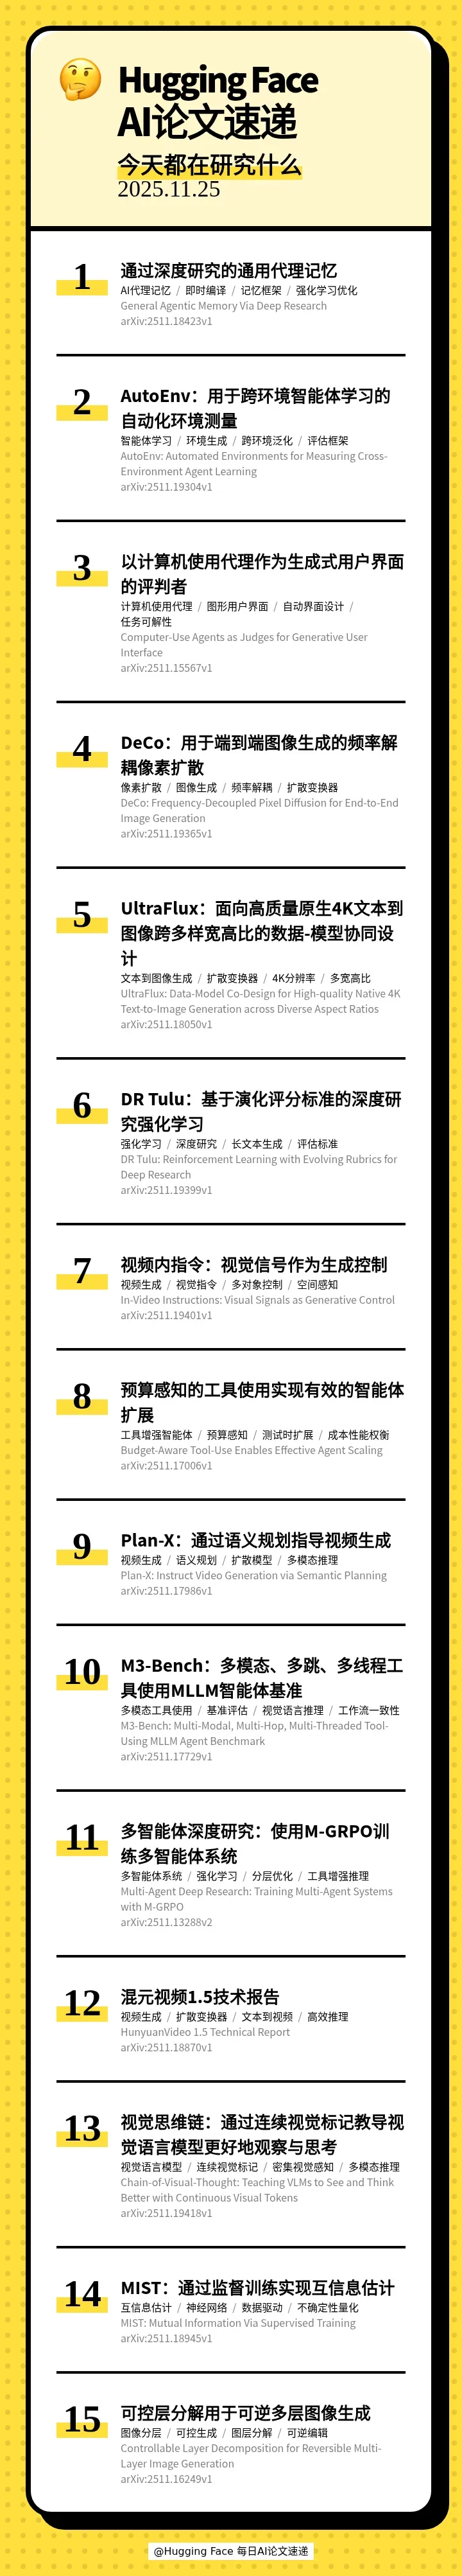
[] 🧠 General Agentic Memory Via Deep Research(通过深度研究的通用代理记忆)
[] 🧪 AutoEnv: Automated Environments for Measuring Cross-Environment Agent Learning(AutoEnv:用于跨环境智能体学习的自动化环境测量)
[] 🤖 Computer-Use Agents as Judges for Generative User Interface(以计算机使用代理作为生成式用户界面的评判者)
[] 🎨 DeCo: Frequency-Decoupled Pixel Diffusion for End-to-End Image Generation(DeCo:用于端到端图像生成的频率解耦像素扩散)
[] 🎨 UltraFlux: Data-Model Co-Design for High-quality Native 4K Text-to-Image Generation across Diverse Aspect Ratios(UltraFlux:面向高质量原生4K文本到图像跨多样宽高比的数据-模型协同设计)
[] 🔍 DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research(DR Tulu:基于演化评分标准的深度研究强化学习)
[] 🎬 In-Video Instructions: Visual Signals as Generative Control(视频内指令:视觉信号作为生成控制)
[] 📊 Budget-Aware Tool-Use Enables Effective Agent Scaling(预算感知的工具使用实现有效的智能体扩展)
[] 🎬 Plan-X: Instruct Video Generation via Semantic Planning(Plan-X:通过语义规划指导视频生成)
[] 🧪 M3-Bench: Multi-Modal, Multi-Hop, Multi-Threaded Tool-Using MLLM Agent Benchmark(M3-Bench:多模态、多跳、多线程工具使用MLLM智能体基准)
[] 🤖 Multi-Agent Deep Research: Training Multi-Agent Systems with M-GRPO(多智能体深度研究:使用M-GRPO训练多智能体系统)
[] 🎬 HunyuanVideo 1.5 Technical Report(混元视频1.5技术报告)
[] 🧠 Chain-of-Visual-Thought: Teaching VLMs to See and Think Better with Continuous Visual Tokens(视觉思维链:通过连续视觉标记教导视觉语言模型更好地观察与思考)
[] 🧠 MIST: Mutual Information Via Supervised Training(MIST:通过监督训练实现互信息估计)
[] 🎨 Controllable Layer Decomposition for Reversible Multi-Layer Image Generation(可控层分解用于可逆多层图像生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 11 月 26 日 · 10 分钟
本期的 15 篇论文如下:
[] 🧠 General Agentic Memory Via Deep Research(通过深度研究的通用代理记忆)
[] 🧪 AutoEnv: Automated Environments for Measuring Cross-Environment Agent Learning(AutoEnv:用于跨环境智能体学习的自动化环境测量)
[] 🤖 Computer-Use Agents as Judges for Generative User Interface(以计算机使用代理作为生成式用户界面的评判者)
[] 🎨 DeCo: Frequency-Decoupled Pixel Diffusion for End-to-End Image Generation(DeCo:用于端到端图像生成的频率解耦像素扩散)
[] 🎨 UltraFlux: Data-Model Co-Design for High-quality Native 4K Text-to-Image Generation across Diverse Aspect Ratios(UltraFlux:面向高质量原生4K文本到图像跨多样宽高比的数据-模型协同设计)
[] 🔍 DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research(DR Tulu:基于演化评分标准的深度研究强化学习)
[] 🎬 In-Video Instructions: Visual Signals as Generative Control(视频内指令:视觉信号作为生成控制)
[] 📊 Budget-Aware Tool-Use Enables Effective Agent Scaling(预算感知的工具使用实现有效的智能体扩展)
[] 🎬 Plan-X: Instruct Video Generation via Semantic Planning(Plan-X:通过语义规划指导视频生成)
[] 🧪 M3-Bench: Multi-Modal, Multi-Hop, Multi-Threaded Tool-Using MLLM Agent Benchmark(M3-Bench:多模态、多跳、多线程工具使用MLLM智能体基准)
[] 🤖 Multi-Agent Deep Research: Training Multi-Agent Systems with M-GRPO(多智能体深度研究:使用M-GRPO训练多智能体系统)
[] 🎬 HunyuanVideo 1.5 Technical Report(混元视频1.5技术报告)
[] 🧠 Chain-of-Visual-Thought: Teaching VLMs to See and Think Better with Continuous Visual Tokens(视觉思维链:通过连续视觉标记教导视觉语言模型更好地观察与思考)
[] 🧠 MIST: Mutual Information Via Supervised Training(MIST:通过监督训练实现互信息估计)
[] 🎨 Controllable Layer Decomposition for Reversible Multi-Layer Image Generation(可控层分解用于可逆多层图像生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟