H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

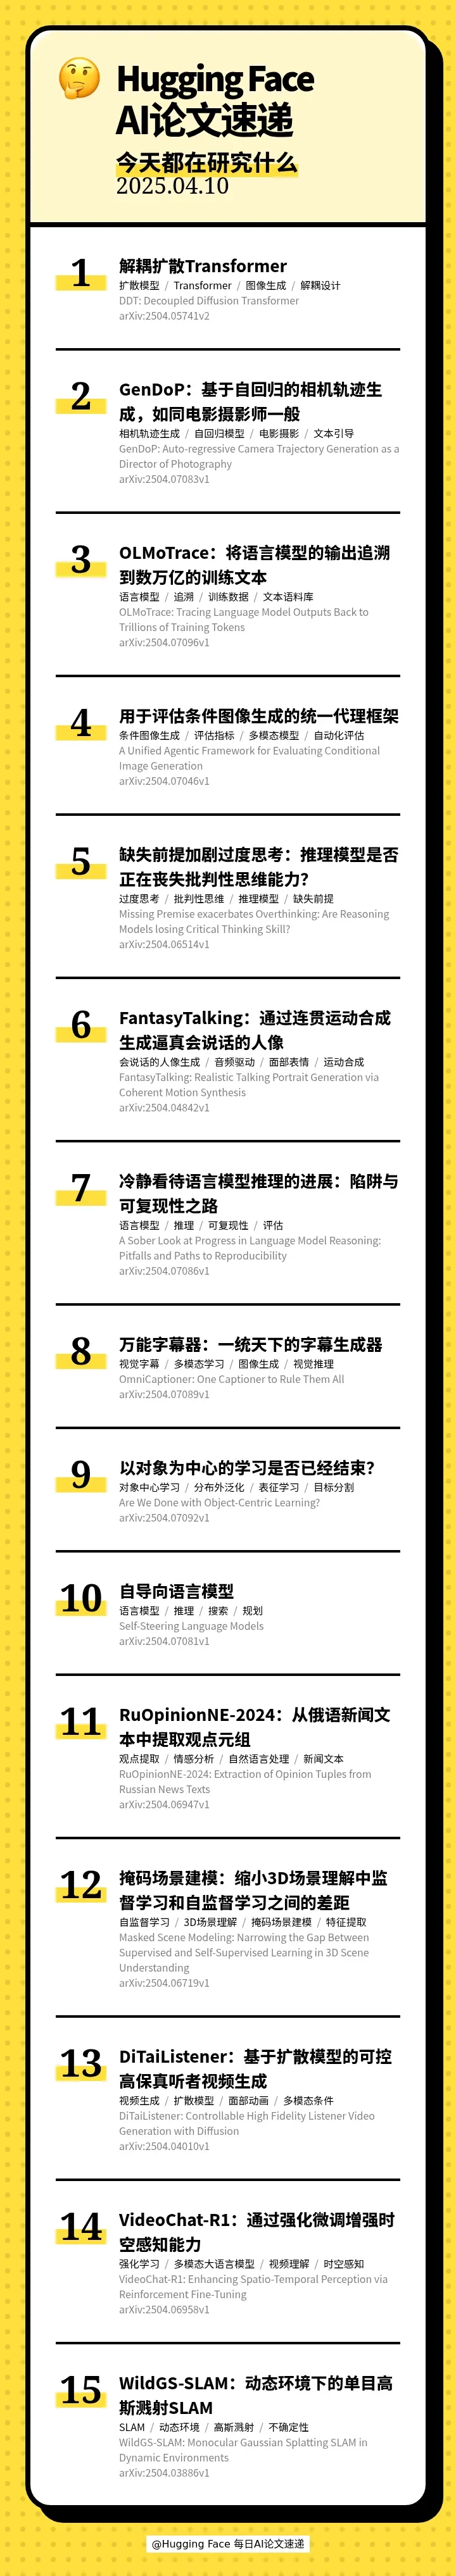
本期的 15 篇论文如下:
[] 🎨 DDT: Decoupled Diffusion Transformer(解耦扩散Transformer)
[] 🎬 GenDoP: Auto-regressive Camera Trajectory Generation as a Director of Photography(GenDoP:基于自回归的相机轨迹生成,如同电影摄影师一般)
[] 🔍 OLMoTrace: Tracing Language Model Outputs Back to Trillions of Training Tokens(OLMoTrace:将语言模型的输出追溯到数万亿的训练文本)
[] 🖼 A Unified Agentic Framework for Evaluating Conditional Image Generation(用于评估条件图像生成的统一代理框架)
[] 🤔 Missing Premise exacerbates Overthinking: Are Reasoning Models losing Critical Thinking Skill?(缺失前提加剧过度思考:推理模型是否正在丧失批判性思维能力?)
[] 🗣 FantasyTalking: Realistic Talking Portrait Generation via Coherent Motion Synthesis(FantasyTalking:通过连贯运动合成生成逼真会说话的人像)
[] 🧐 A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility(冷静看待语言模型推理的进展:陷阱与可复现性之路)
[] 🖼 OmniCaptioner: One Captioner to Rule Them All(万能字幕器:一统天下的字幕生成器)
[] 🧩 Are We Done with Object-Centric Learning?(以对象为中心的学习是否已经结束?)
[] 🤖 Self-Steering Language Models(自导向语言模型)
[] 🇷 RuOpinionNE-2024: Extraction of Opinion Tuples from Russian News Texts(RuOpinionNE-2024:从俄语新闻文本中提取观点元组)
[] 🤖 Masked Scene Modeling: Narrowing the Gap Between Supervised and Self-Supervised Learning in 3D Scene Understanding(掩码场景建模:缩小3D场景理解中监督学习和自监督学习之间的差距)
[] 👂 DiTaiListener: Controllable High Fidelity Listener Video Generation with Diffusion(DiTaiListener:基于扩散模型的可控高保真听者视频生成)
[] 🤖 VideoChat-R1: Enhancing Spatio-Temporal Perception via Reinforcement Fine-Tuning(VideoChat-R1:通过强化微调增强时空感知能力)
[] 🤖 WildGS-SLAM: Monocular Gaussian Splatting SLAM in Dynamic Environments(WildGS-SLAM:动态环境下的单目高斯溅射SLAM)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 4 月 11 日 · 11 分钟
本期的 15 篇论文如下:
[] 🎨 DDT: Decoupled Diffusion Transformer(解耦扩散Transformer)
[] 🎬 GenDoP: Auto-regressive Camera Trajectory Generation as a Director of Photography(GenDoP:基于自回归的相机轨迹生成,如同电影摄影师一般)
[] 🔍 OLMoTrace: Tracing Language Model Outputs Back to Trillions of Training Tokens(OLMoTrace:将语言模型的输出追溯到数万亿的训练文本)
[] 🖼 A Unified Agentic Framework for Evaluating Conditional Image Generation(用于评估条件图像生成的统一代理框架)
[] 🤔 Missing Premise exacerbates Overthinking: Are Reasoning Models losing Critical Thinking Skill?(缺失前提加剧过度思考:推理模型是否正在丧失批判性思维能力?)
[] 🗣 FantasyTalking: Realistic Talking Portrait Generation via Coherent Motion Synthesis(FantasyTalking:通过连贯运动合成生成逼真会说话的人像)
[] 🧐 A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility(冷静看待语言模型推理的进展:陷阱与可复现性之路)
[] 🖼 OmniCaptioner: One Captioner to Rule Them All(万能字幕器:一统天下的字幕生成器)
[] 🧩 Are We Done with Object-Centric Learning?(以对象为中心的学习是否已经结束?)
[] 🤖 Self-Steering Language Models(自导向语言模型)
[] 🇷 RuOpinionNE-2024: Extraction of Opinion Tuples from Russian News Texts(RuOpinionNE-2024:从俄语新闻文本中提取观点元组)
[] 🤖 Masked Scene Modeling: Narrowing the Gap Between Supervised and Self-Supervised Learning in 3D Scene Understanding(掩码场景建模:缩小3D场景理解中监督学习和自监督学习之间的差距)
[] 👂 DiTaiListener: Controllable High Fidelity Listener Video Generation with Diffusion(DiTaiListener:基于扩散模型的可控高保真听者视频生成)
[] 🤖 VideoChat-R1: Enhancing Spatio-Temporal Perception via Reinforcement Fine-Tuning(VideoChat-R1:通过强化微调增强时空感知能力)
[] 🤖 WildGS-SLAM: Monocular Gaussian Splatting SLAM in Dynamic Environments(WildGS-SLAM:动态环境下的单目高斯溅射SLAM)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟