H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

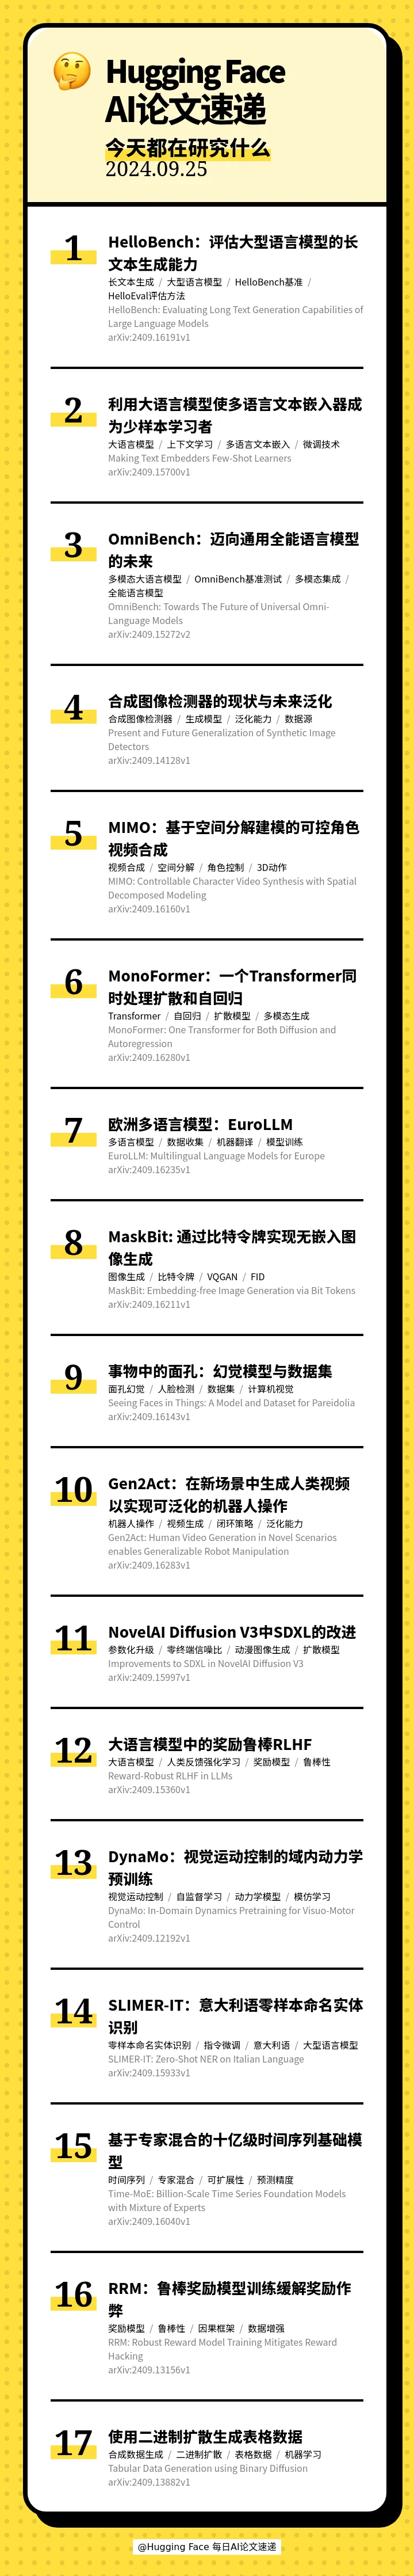
本期的 17 篇论文如下:
[] 📄 HelloBench: Evaluating Long Text Generation Capabilities of Large Language Models(HelloBench:评估大型语言模型的长文本生成能力)
[] 🌐 Making Text Embedders Few-Shot Learners(利用大语言模型使多语言文本嵌入器成为少样本学习者)
[] 🌐 OmniBench: Towards The Future of Universal Omni-Language Models(OmniBench:迈向通用全能语言模型的未来)
[] 🔄 Present and Future Generalization of Synthetic Image Detectors(合成图像检测器的现状与未来泛化)
[] 🎥 MIMO: Controllable Character Video Synthesis with Spatial Decomposed Modeling(MIMO:基于空间分解建模的可控角色视频合成)
[] 🔄 MonoFormer: One Transformer for Both Diffusion and Autoregression(MonoFormer:一个Transformer同时处理扩散和自回归)
[] 🌍 EuroLLM: Multilingual Language Models for Europe(欧洲多语言模型:EuroLLM)
[] 🖼 MaskBit: Embedding-free Image Generation via Bit Tokens(MaskBit: 通过比特令牌实现无嵌入图像生成)
[] 👁 Seeing Faces in Things: A Model and Dataset for Pareidolia(事物中的面孔:幻觉模型与数据集)
[] 🤖 Gen2Act: Human Video Generation in Novel Scenarios enables Generalizable Robot Manipulation(Gen2Act:在新场景中生成人类视频以实现可泛化的机器人操作)
[] 🎨 Improvements to SDXL in NovelAI Diffusion V3(NovelAI Diffusion V3中SDXL的改进)
[] 🔄 Reward-Robust RLHF in LLMs(大语言模型中的奖励鲁棒RLHF)
[] 🤖 DynaMo: In-Domain Dynamics Pretraining for Visuo-Motor Control(DynaMo:视觉运动控制的域内动力学预训练)
[] 🇮 SLIMER-IT: Zero-Shot NER on Italian Language(SLIMER-IT:意大利语零样本命名实体识别)
[] 📈 Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts(基于专家混合的十亿级时间序列基础模型)
[] 🛡 RRM: Robust Reward Model Training Mitigates Reward Hacking(RRM:鲁棒奖励模型训练缓解奖励作弊)
[] 📊 Tabular Data Generation using Binary Diffusion(使用二进制扩散生成表格数据)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 9 月 26 日 · 12 分钟
本期的 17 篇论文如下:
[] 📄 HelloBench: Evaluating Long Text Generation Capabilities of Large Language Models(HelloBench:评估大型语言模型的长文本生成能力)
[] 🌐 Making Text Embedders Few-Shot Learners(利用大语言模型使多语言文本嵌入器成为少样本学习者)
[] 🌐 OmniBench: Towards The Future of Universal Omni-Language Models(OmniBench:迈向通用全能语言模型的未来)
[] 🔄 Present and Future Generalization of Synthetic Image Detectors(合成图像检测器的现状与未来泛化)
[] 🎥 MIMO: Controllable Character Video Synthesis with Spatial Decomposed Modeling(MIMO:基于空间分解建模的可控角色视频合成)
[] 🔄 MonoFormer: One Transformer for Both Diffusion and Autoregression(MonoFormer:一个Transformer同时处理扩散和自回归)
[] 🌍 EuroLLM: Multilingual Language Models for Europe(欧洲多语言模型:EuroLLM)
[] 🖼 MaskBit: Embedding-free Image Generation via Bit Tokens(MaskBit: 通过比特令牌实现无嵌入图像生成)
[] 👁 Seeing Faces in Things: A Model and Dataset for Pareidolia(事物中的面孔:幻觉模型与数据集)
[] 🤖 Gen2Act: Human Video Generation in Novel Scenarios enables Generalizable Robot Manipulation(Gen2Act:在新场景中生成人类视频以实现可泛化的机器人操作)
[] 🎨 Improvements to SDXL in NovelAI Diffusion V3(NovelAI Diffusion V3中SDXL的改进)
[] 🔄 Reward-Robust RLHF in LLMs(大语言模型中的奖励鲁棒RLHF)
[] 🤖 DynaMo: In-Domain Dynamics Pretraining for Visuo-Motor Control(DynaMo:视觉运动控制的域内动力学预训练)
[] 🇮 SLIMER-IT: Zero-Shot NER on Italian Language(SLIMER-IT:意大利语零样本命名实体识别)
[] 📈 Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts(基于专家混合的十亿级时间序列基础模型)
[] 🛡 RRM: Robust Reward Model Training Mitigates Reward Hacking(RRM:鲁棒奖励模型训练缓解奖励作弊)
[] 📊 Tabular Data Generation using Binary Diffusion(使用二进制扩散生成表格数据)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟