H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
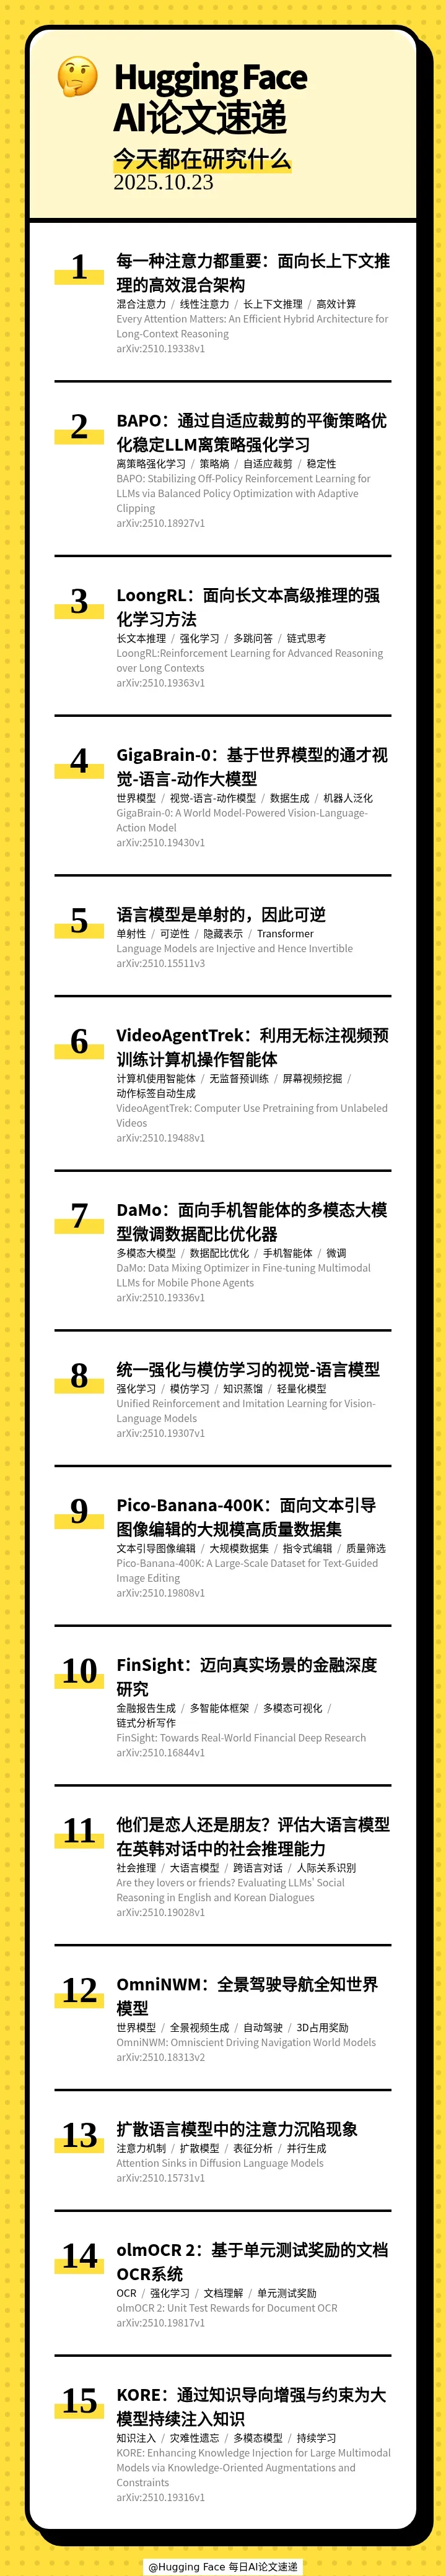
[] 🧠 Every Attention Matters: An Efficient Hybrid Architecture for Long-Context Reasoning(每一种注意力都重要:面向长上下文推理的高效混合架构)
[] ⚖ BAPO: Stabilizing Off-Policy Reinforcement Learning for LLMs via Balanced Policy Optimization with Adaptive Clipping(BAPO:通过自适应裁剪的平衡策略优化稳定LLM离策略强化学习)
[] 🧠 LoongRL:Reinforcement Learning for Advanced Reasoning over Long Contexts(LoongRL:面向长文本高级推理的强化学习方法)
[] 🌍 GigaBrain-0: A World Model-Powered Vision-Language-Action Model(GigaBrain-0:基于世界模型的通才视觉-语言-动作大模型)
[] 🔄 Language Models are Injective and Hence Invertible(语言模型是单射的,因此可逆)
[] 📹 VideoAgentTrek: Computer Use Pretraining from Unlabeled Videos(VideoAgentTrek:利用无标注视频预训练计算机操作智能体)
[] 📲 DaMo: Data Mixing Optimizer in Fine-tuning Multimodal LLMs for Mobile Phone Agents(DaMo:面向手机智能体的多模态大模型微调数据配比优化器)
[] 🚀 Unified Reinforcement and Imitation Learning for Vision-Language Models(统一强化与模仿学习的视觉-语言模型)
[] 🖼 Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing(Pico-Banana-400K:面向文本引导图像编辑的大规模高质量数据集)
[] 📊 FinSight: Towards Real-World Financial Deep Research(FinSight:迈向真实场景的金融深度研究)
[] 🧠 Are they lovers or friends? Evaluating LLMs' Social Reasoning in English and Korean Dialogues(他们是恋人还是朋友?评估大语言模型在英韩对话中的社会推理能力)
[] 🌍 OmniNWM: Omniscient Driving Navigation World Models(OmniNWM:全景驾驶导航全知世界模型)
[] 🕳 Attention Sinks in Diffusion Language Models(扩散语言模型中的注意力沉陷现象)
[] 📄 olmOCR 2: Unit Test Rewards for Document OCR(olmOCR 2:基于单元测试奖励的文档OCR系统)
[] 🧠 KORE: Enhancing Knowledge Injection for Large Multimodal Models via Knowledge-Oriented Augmentations and Constraints(KORE:通过知识导向增强与约束为大模型持续注入知识)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 24 日 · 11 分钟
本期的 15 篇论文如下:
[] 🧠 Every Attention Matters: An Efficient Hybrid Architecture for Long-Context Reasoning(每一种注意力都重要:面向长上下文推理的高效混合架构)
[] ⚖ BAPO: Stabilizing Off-Policy Reinforcement Learning for LLMs via Balanced Policy Optimization with Adaptive Clipping(BAPO:通过自适应裁剪的平衡策略优化稳定LLM离策略强化学习)
[] 🧠 LoongRL:Reinforcement Learning for Advanced Reasoning over Long Contexts(LoongRL:面向长文本高级推理的强化学习方法)
[] 🌍 GigaBrain-0: A World Model-Powered Vision-Language-Action Model(GigaBrain-0:基于世界模型的通才视觉-语言-动作大模型)
[] 🔄 Language Models are Injective and Hence Invertible(语言模型是单射的,因此可逆)
[] 📹 VideoAgentTrek: Computer Use Pretraining from Unlabeled Videos(VideoAgentTrek:利用无标注视频预训练计算机操作智能体)
[] 📲 DaMo: Data Mixing Optimizer in Fine-tuning Multimodal LLMs for Mobile Phone Agents(DaMo:面向手机智能体的多模态大模型微调数据配比优化器)
[] 🚀 Unified Reinforcement and Imitation Learning for Vision-Language Models(统一强化与模仿学习的视觉-语言模型)
[] 🖼 Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing(Pico-Banana-400K:面向文本引导图像编辑的大规模高质量数据集)
[] 📊 FinSight: Towards Real-World Financial Deep Research(FinSight:迈向真实场景的金融深度研究)
[] 🧠 Are they lovers or friends? Evaluating LLMs' Social Reasoning in English and Korean Dialogues(他们是恋人还是朋友?评估大语言模型在英韩对话中的社会推理能力)
[] 🌍 OmniNWM: Omniscient Driving Navigation World Models(OmniNWM:全景驾驶导航全知世界模型)
[] 🕳 Attention Sinks in Diffusion Language Models(扩散语言模型中的注意力沉陷现象)
[] 📄 olmOCR 2: Unit Test Rewards for Document OCR(olmOCR 2:基于单元测试奖励的文档OCR系统)
[] 🧠 KORE: Enhancing Knowledge Injection for Large Multimodal Models via Knowledge-Oriented Augmentations and Constraints(KORE:通过知识导向增强与约束为大模型持续注入知识)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟