H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

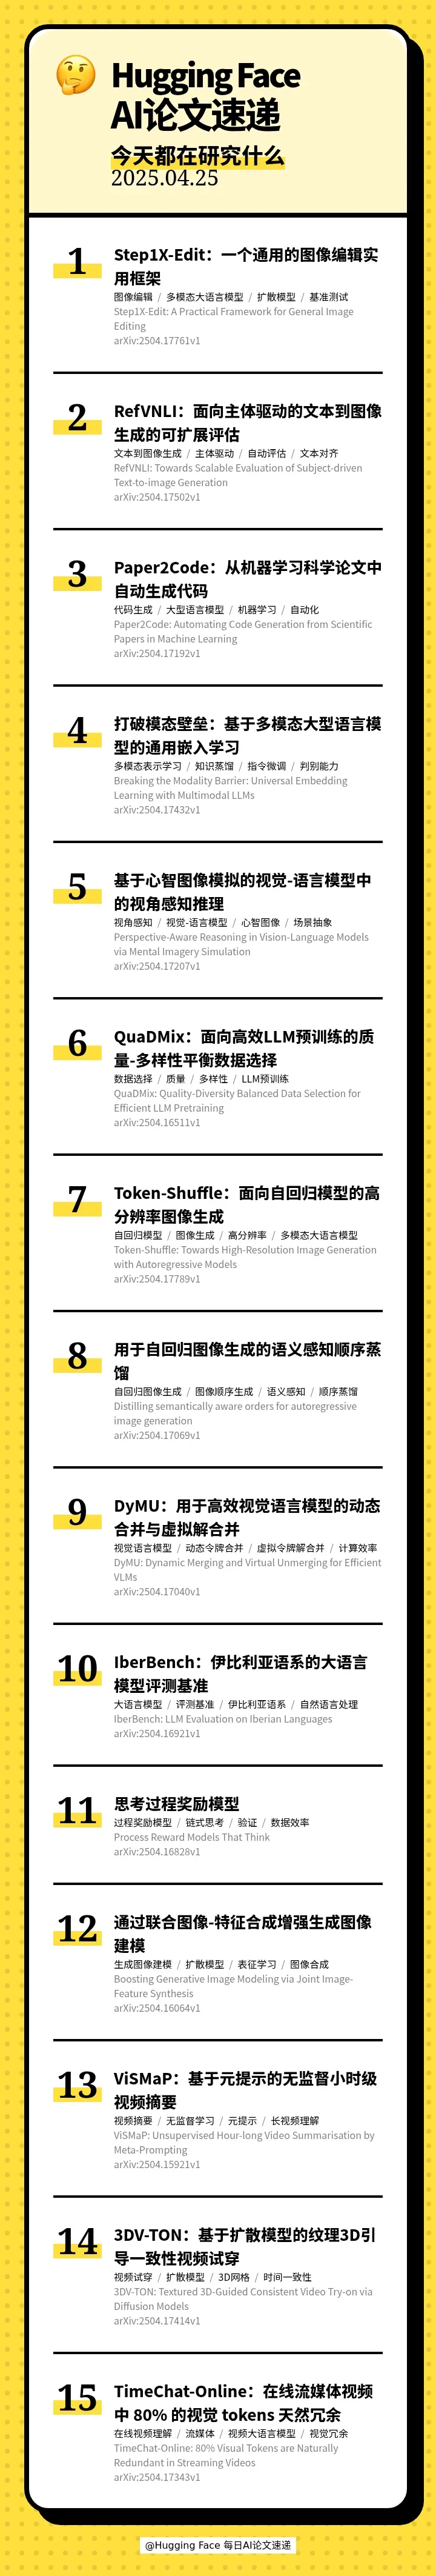
本期的 15 篇论文如下:
[] 🖼 Step1X-Edit: A Practical Framework for General Image Editing(Step1X-Edit:一个通用的图像编辑实用框架)
[] 🖼 RefVNLI: Towards Scalable Evaluation of Subject-driven Text-to-image Generation(RefVNLI:面向主体驱动的文本到图像生成的可扩展评估)
[] 🤖 Paper2Code: Automating Code Generation from Scientific Papers in Machine Learning(Paper2Code:从机器学习科学论文中自动生成代码)
[] 🖼 Breaking the Modality Barrier: Universal Embedding Learning with Multimodal LLMs(打破模态壁垒:基于多模态大型语言模型的通用嵌入学习)
[] 🧠 Perspective-Aware Reasoning in Vision-Language Models via Mental Imagery Simulation(基于心智图像模拟的视觉-语言模型中的视角感知推理)
[] ⚖ QuaDMix: Quality-Diversity Balanced Data Selection for Efficient LLM Pretraining(QuaDMix:面向高效LLM预训练的质量-多样性平衡数据选择)
[] 🖼 Token-Shuffle: Towards High-Resolution Image Generation with Autoregressive Models(Token-Shuffle:面向自回归模型的高分辨率图像生成)
[] 🖼 Distilling semantically aware orders for autoregressive image generation(用于自回归图像生成的语义感知顺序蒸馏)
[] 🗜 DyMU: Dynamic Merging and Virtual Unmerging for Efficient VLMs(DyMU:用于高效视觉语言模型的动态合并与虚拟解合并)
[] 🇪 IberBench: LLM Evaluation on Iberian Languages(IberBench:伊比利亚语系的大语言模型评测基准)
[] 🧠 Process Reward Models That Think(思考过程奖励模型)
[] 🎨 Boosting Generative Image Modeling via Joint Image-Feature Synthesis(通过联合图像-特征合成增强生成图像建模)
[] 🎬 ViSMaP: Unsupervised Hour-long Video Summarisation by Meta-Prompting(ViSMaP:基于元提示的无监督小时级视频摘要)
[] 👗 3DV-TON: Textured 3D-Guided Consistent Video Try-on via Diffusion Models(3DV-TON:基于扩散模型的纹理3D引导一致性视频试穿)
[] 📹 TimeChat-Online: 80% Visual Tokens are Naturally Redundant in Streaming Videos(TimeChat-Online:在线流媒体视频中 80% 的视觉 tokens 天然冗余)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 4 月 26 日 · 11 分钟
本期的 15 篇论文如下:
[] 🖼 Step1X-Edit: A Practical Framework for General Image Editing(Step1X-Edit:一个通用的图像编辑实用框架)
[] 🖼 RefVNLI: Towards Scalable Evaluation of Subject-driven Text-to-image Generation(RefVNLI:面向主体驱动的文本到图像生成的可扩展评估)
[] 🤖 Paper2Code: Automating Code Generation from Scientific Papers in Machine Learning(Paper2Code:从机器学习科学论文中自动生成代码)
[] 🖼 Breaking the Modality Barrier: Universal Embedding Learning with Multimodal LLMs(打破模态壁垒:基于多模态大型语言模型的通用嵌入学习)
[] 🧠 Perspective-Aware Reasoning in Vision-Language Models via Mental Imagery Simulation(基于心智图像模拟的视觉-语言模型中的视角感知推理)
[] ⚖ QuaDMix: Quality-Diversity Balanced Data Selection for Efficient LLM Pretraining(QuaDMix:面向高效LLM预训练的质量-多样性平衡数据选择)
[] 🖼 Token-Shuffle: Towards High-Resolution Image Generation with Autoregressive Models(Token-Shuffle:面向自回归模型的高分辨率图像生成)
[] 🖼 Distilling semantically aware orders for autoregressive image generation(用于自回归图像生成的语义感知顺序蒸馏)
[] 🗜 DyMU: Dynamic Merging and Virtual Unmerging for Efficient VLMs(DyMU:用于高效视觉语言模型的动态合并与虚拟解合并)
[] 🇪 IberBench: LLM Evaluation on Iberian Languages(IberBench:伊比利亚语系的大语言模型评测基准)
[] 🧠 Process Reward Models That Think(思考过程奖励模型)
[] 🎨 Boosting Generative Image Modeling via Joint Image-Feature Synthesis(通过联合图像-特征合成增强生成图像建模)
[] 🎬 ViSMaP: Unsupervised Hour-long Video Summarisation by Meta-Prompting(ViSMaP:基于元提示的无监督小时级视频摘要)
[] 👗 3DV-TON: Textured 3D-Guided Consistent Video Try-on via Diffusion Models(3DV-TON:基于扩散模型的纹理3D引导一致性视频试穿)
[] 📹 TimeChat-Online: 80% Visual Tokens are Naturally Redundant in Streaming Videos(TimeChat-Online:在线流媒体视频中 80% 的视觉 tokens 天然冗余)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟