H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
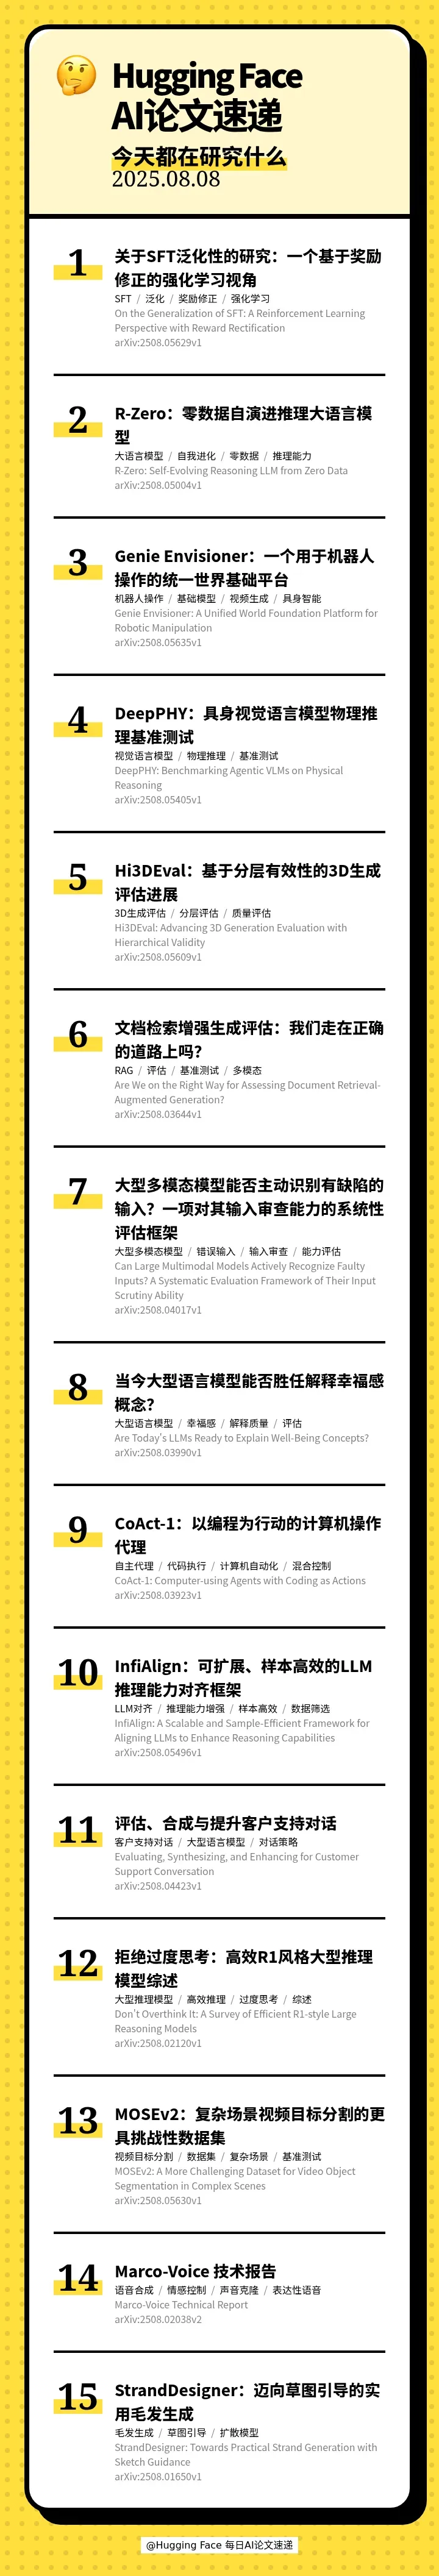
[] ✨ On the Generalization of SFT: A Reinforcement Learning Perspective with Reward Rectification(关于SFT泛化性的研究:一个基于奖励修正的强化学习视角)
[] 🌱 R-Zero: Self-Evolving Reasoning LLM from Zero Data(R-Zero:零数据自演进推理大语言模型)
[] 🤖 Genie Envisioner: A Unified World Foundation Platform for Robotic Manipulation(Genie Envisioner:一个用于机器人操作的统一世界基础平台)
[] 🤔 DeepPHY: Benchmarking Agentic VLMs on Physical Reasoning(DeepPHY:具身视觉语言模型物理推理基准测试)
[] 📊 Hi3DEval: Advancing 3D Generation Evaluation with Hierarchical Validity(Hi3DEval:基于分层有效性的3D生成评估进展)
[] 🤔 Are We on the Right Way for Assessing Document Retrieval-Augmented Generation?(文档检索增强生成评估:我们走在正确的道路上吗?)
[] 🔍 Can Large Multimodal Models Actively Recognize Faulty Inputs? A Systematic Evaluation Framework of Their Input Scrutiny Ability(大型多模态模型能否主动识别有缺陷的输入?一项对其输入审查能力的系统性评估框架)
[] 💡 Are Today's LLMs Ready to Explain Well-Being Concepts?(当今大型语言模型能否胜任解释幸福感概念?)
[] 🚀 CoAct-1: Computer-using Agents with Coding as Actions(CoAct-1:以编程为行动的计算机操作代理)
[] 🚀 InfiAlign: A Scalable and Sample-Efficient Framework for Aligning LLMs to Enhance Reasoning Capabilities(InfiAlign:可扩展、样本高效的LLM推理能力对齐框架)
[] 💬 Evaluating, Synthesizing, and Enhancing for Customer Support Conversation(评估、合成与提升客户支持对话)
[] 💡 Don't Overthink It: A Survey of Efficient R1-style Large Reasoning Models(拒绝过度思考:高效R1风格大型推理模型综述)
[] 🤯 MOSEv2: A More Challenging Dataset for Video Object Segmentation in Complex Scenes(MOSEv2:复杂场景视频目标分割的更具挑战性数据集)
[] 🎤 Marco-Voice Technical Report(Marco-Voice 技术报告)
[] 🎨 StrandDesigner: Towards Practical Strand Generation with Sketch Guidance(StrandDesigner:迈向草图引导的实用毛发生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 8 月 9 日 · 7 分钟
本期的 15 篇论文如下:
[] ✨ On the Generalization of SFT: A Reinforcement Learning Perspective with Reward Rectification(关于SFT泛化性的研究:一个基于奖励修正的强化学习视角)
[] 🌱 R-Zero: Self-Evolving Reasoning LLM from Zero Data(R-Zero:零数据自演进推理大语言模型)
[] 🤖 Genie Envisioner: A Unified World Foundation Platform for Robotic Manipulation(Genie Envisioner:一个用于机器人操作的统一世界基础平台)
[] 🤔 DeepPHY: Benchmarking Agentic VLMs on Physical Reasoning(DeepPHY:具身视觉语言模型物理推理基准测试)
[] 📊 Hi3DEval: Advancing 3D Generation Evaluation with Hierarchical Validity(Hi3DEval:基于分层有效性的3D生成评估进展)
[] 🤔 Are We on the Right Way for Assessing Document Retrieval-Augmented Generation?(文档检索增强生成评估:我们走在正确的道路上吗?)
[] 🔍 Can Large Multimodal Models Actively Recognize Faulty Inputs? A Systematic Evaluation Framework of Their Input Scrutiny Ability(大型多模态模型能否主动识别有缺陷的输入?一项对其输入审查能力的系统性评估框架)
[] 💡 Are Today's LLMs Ready to Explain Well-Being Concepts?(当今大型语言模型能否胜任解释幸福感概念?)
[] 🚀 CoAct-1: Computer-using Agents with Coding as Actions(CoAct-1:以编程为行动的计算机操作代理)
[] 🚀 InfiAlign: A Scalable and Sample-Efficient Framework for Aligning LLMs to Enhance Reasoning Capabilities(InfiAlign:可扩展、样本高效的LLM推理能力对齐框架)
[] 💬 Evaluating, Synthesizing, and Enhancing for Customer Support Conversation(评估、合成与提升客户支持对话)
[] 💡 Don't Overthink It: A Survey of Efficient R1-style Large Reasoning Models(拒绝过度思考:高效R1风格大型推理模型综述)
[] 🤯 MOSEv2: A More Challenging Dataset for Video Object Segmentation in Complex Scenes(MOSEv2:复杂场景视频目标分割的更具挑战性数据集)
[] 🎤 Marco-Voice Technical Report(Marco-Voice 技术报告)
[] 🎨 StrandDesigner: Towards Practical Strand Generation with Sketch Guidance(StrandDesigner:迈向草图引导的实用毛发生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟