H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
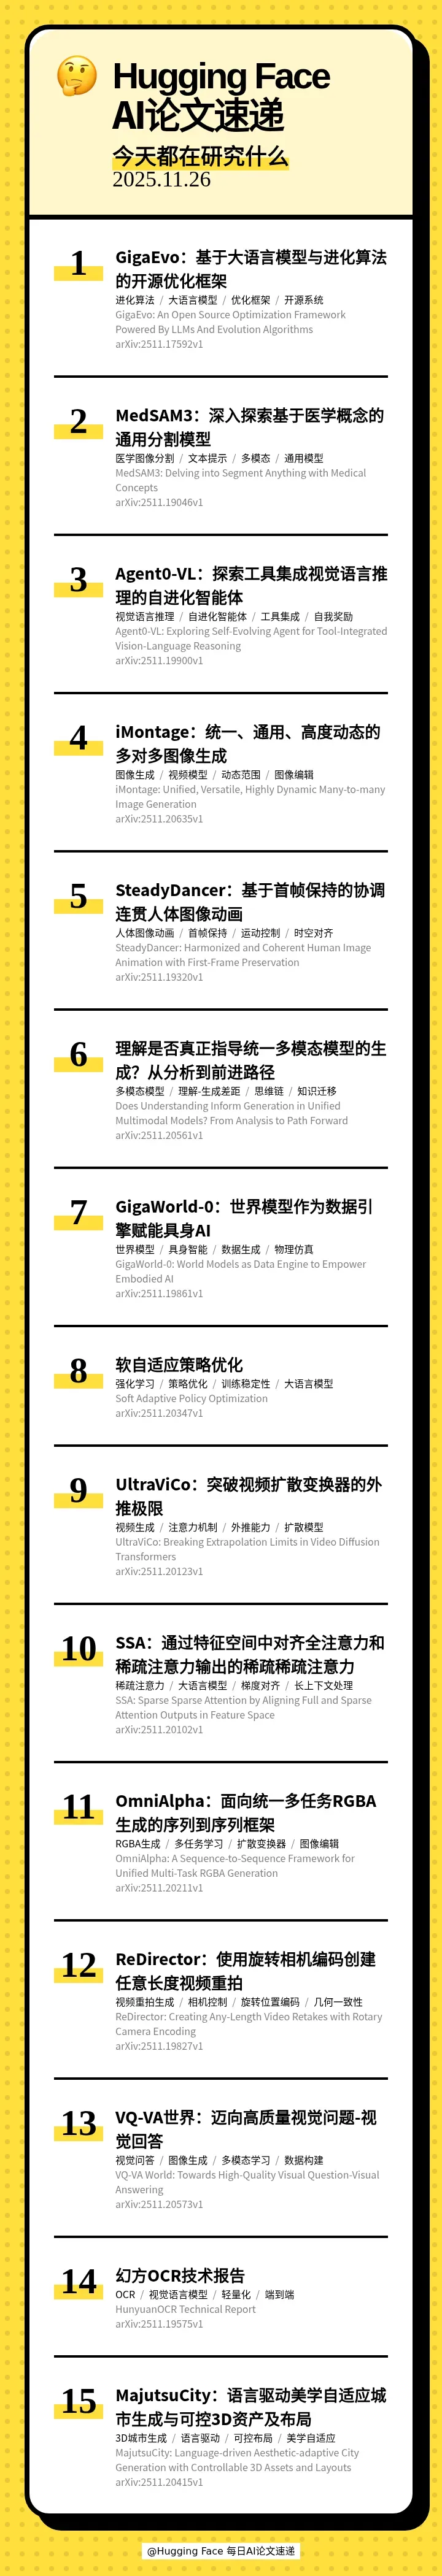
[] 🧬 GigaEvo: An Open Source Optimization Framework Powered By LLMs And Evolution Algorithms(GigaEvo:基于大语言模型与进化算法的开源优化框架)
[] 🔬 MedSAM3: Delving into Segment Anything with Medical Concepts(MedSAM3:深入探索基于医学概念的通用分割模型)
[] 🔍 Agent0-VL: Exploring Self-Evolving Agent for Tool-Integrated Vision-Language Reasoning(Agent0-VL:探索工具集成视觉语言推理的自进化智能体)
[] 🎨 iMontage: Unified, Versatile, Highly Dynamic Many-to-many Image Generation(iMontage:统一、通用、高度动态的多对多图像生成)
[] 🕺 SteadyDancer: Harmonized and Coherent Human Image Animation with First-Frame Preservation(SteadyDancer:基于首帧保持的协调连贯人体图像动画)
[] 🔍 Does Understanding Inform Generation in Unified Multimodal Models? From Analysis to Path Forward(理解是否真正指导统一多模态模型的生成?从分析到前进路径)
[] 🤖 GigaWorld-0: World Models as Data Engine to Empower Embodied AI(GigaWorld-0:世界模型作为数据引擎赋能具身AI)
[] 🎯 Soft Adaptive Policy Optimization(软自适应策略优化)
[] 🎬 UltraViCo: Breaking Extrapolation Limits in Video Diffusion Transformers(UltraViCo:突破视频扩散变换器的外推极限)
[] 🎯 SSA: Sparse Sparse Attention by Aligning Full and Sparse Attention Outputs in Feature Space(SSA:通过特征空间中对齐全注意力和稀疏注意力输出的稀疏稀疏注意力)
[] 🎨 OmniAlpha: A Sequence-to-Sequence Framework for Unified Multi-Task RGBA Generation(OmniAlpha:面向统一多任务RGBA生成的序列到序列框架)
[] 🎬 ReDirector: Creating Any-Length Video Retakes with Rotary Camera Encoding(ReDirector:使用旋转相机编码创建任意长度视频重拍)
[] 🖼 VQ-VA World: Towards High-Quality Visual Question-Visual Answering(VQ-VA世界:迈向高质量视觉问题-视觉回答)
[] 🔍 HunyuanOCR Technical Report(幻方OCR技术报告)
[] 🏙 MajutsuCity: Language-driven Aesthetic-adaptive City Generation with Controllable 3D Assets and Layouts(MajutsuCity:语言驱动美学自适应城市生成与可控3D资产及布局)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 11 月 27 日 · 11 分钟
本期的 15 篇论文如下:
[] 🧬 GigaEvo: An Open Source Optimization Framework Powered By LLMs And Evolution Algorithms(GigaEvo:基于大语言模型与进化算法的开源优化框架)
[] 🔬 MedSAM3: Delving into Segment Anything with Medical Concepts(MedSAM3:深入探索基于医学概念的通用分割模型)
[] 🔍 Agent0-VL: Exploring Self-Evolving Agent for Tool-Integrated Vision-Language Reasoning(Agent0-VL:探索工具集成视觉语言推理的自进化智能体)
[] 🎨 iMontage: Unified, Versatile, Highly Dynamic Many-to-many Image Generation(iMontage:统一、通用、高度动态的多对多图像生成)
[] 🕺 SteadyDancer: Harmonized and Coherent Human Image Animation with First-Frame Preservation(SteadyDancer:基于首帧保持的协调连贯人体图像动画)
[] 🔍 Does Understanding Inform Generation in Unified Multimodal Models? From Analysis to Path Forward(理解是否真正指导统一多模态模型的生成?从分析到前进路径)
[] 🤖 GigaWorld-0: World Models as Data Engine to Empower Embodied AI(GigaWorld-0:世界模型作为数据引擎赋能具身AI)
[] 🎯 Soft Adaptive Policy Optimization(软自适应策略优化)
[] 🎬 UltraViCo: Breaking Extrapolation Limits in Video Diffusion Transformers(UltraViCo:突破视频扩散变换器的外推极限)
[] 🎯 SSA: Sparse Sparse Attention by Aligning Full and Sparse Attention Outputs in Feature Space(SSA:通过特征空间中对齐全注意力和稀疏注意力输出的稀疏稀疏注意力)
[] 🎨 OmniAlpha: A Sequence-to-Sequence Framework for Unified Multi-Task RGBA Generation(OmniAlpha:面向统一多任务RGBA生成的序列到序列框架)
[] 🎬 ReDirector: Creating Any-Length Video Retakes with Rotary Camera Encoding(ReDirector:使用旋转相机编码创建任意长度视频重拍)
[] 🖼 VQ-VA World: Towards High-Quality Visual Question-Visual Answering(VQ-VA世界:迈向高质量视觉问题-视觉回答)
[] 🔍 HunyuanOCR Technical Report(幻方OCR技术报告)
[] 🏙 MajutsuCity: Language-driven Aesthetic-adaptive City Generation with Controllable 3D Assets and Layouts(MajutsuCity:语言驱动美学自适应城市生成与可控3D资产及布局)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟