H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

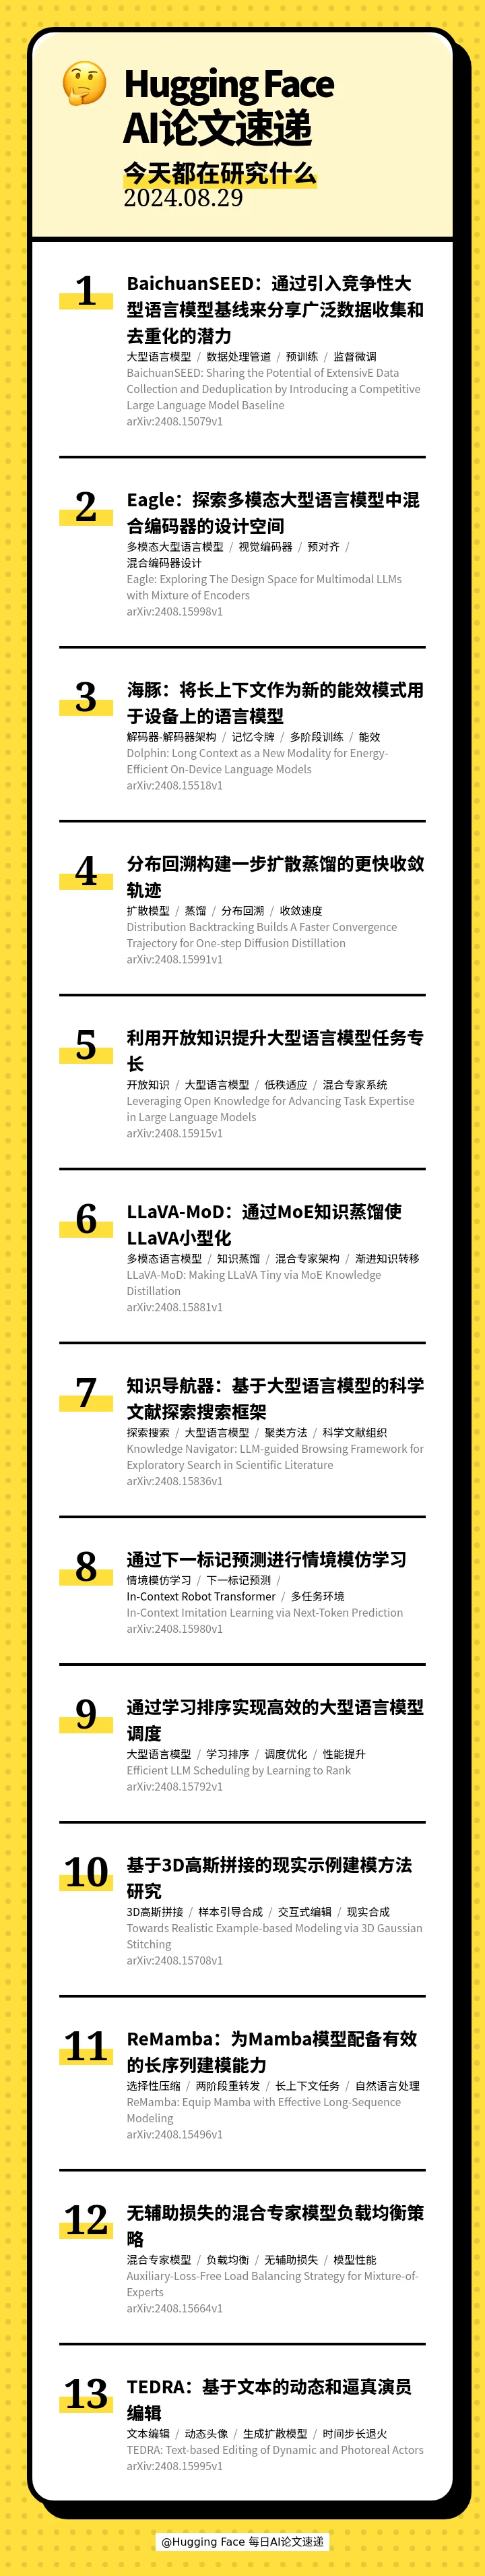
大家好,欢迎收听“Hugging Face 每日AI论文速递”。今天是2024年8月29日,我们将带您快速浏览13篇热门AI论文,涵盖大型语言模型、多模态设计、能效模式等多个前沿领域。现在,让我们立即进入今天的论文速递。
[] 📚 BaichuanSEED: Sharing the Potential of ExtensivE Data Collection and Deduplication by Introducing a Competitive Large Language Model Baseline(BaichuanSEED:通过引入竞争性大型语言模型基线来分享广泛数据收集和去重化的潜力)
[] 🦅 Eagle: Exploring The Design Space for Multimodal LLMs with Mixture of Encoders(Eagle:探索多模态大型语言模型中混合编码器的设计空间)
[] 🐬 Dolphin: Long Context as a New Modality for Energy-Efficient On-Device Language Models(海豚:将长上下文作为新的能效模式用于设备上的语言模型)
[] 🚀 Distribution Backtracking Builds A Faster Convergence Trajectory for One-step Diffusion Distillation(分布回溯构建一步扩散蒸馏的更快收敛轨迹)
[] 📚 Leveraging Open Knowledge for Advancing Task Expertise in Large Language Models(利用开放知识提升大型语言模型任务专长)
[] 🔍 LLaVA-MoD: Making LLaVA Tiny via MoE Knowledge Distillation(LLaVA-MoD:通过MoE知识蒸馏使LLaVA小型化)
[] 🔍 Knowledge Navigator: LLM-guided Browsing Framework for Exploratory Search in Scientific Literature(知识导航器:基于大型语言模型的科学文献探索搜索框架)
[] 🤖 In-Context Imitation Learning via Next-Token Prediction(通过下一标记预测进行情境模仿学习)
[] 📊 Efficient LLM Scheduling by Learning to Rank(通过学习排序实现高效的大型语言模型调度)
[] 🔍 Towards Realistic Example-based Modeling via 3D Gaussian Stitching(基于3D高斯拼接的现实示例建模方法研究)
[] 📚 ReMamba: Equip Mamba with Effective Long-Sequence Modeling(ReMamba:为Mamba模型配备有效的长序列建模能力)
[] 🔄 Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts(无辅助损失的混合专家模型负载均衡策略)
[] 🎭 TEDRA: Text-based Editing of Dynamic and Photoreal Actors(TEDRA:基于文本的动态和逼真演员编辑)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 8 月 30 日 · 9 分钟
大家好,欢迎收听“Hugging Face 每日AI论文速递”。今天是2024年8月29日,我们将带您快速浏览13篇热门AI论文,涵盖大型语言模型、多模态设计、能效模式等多个前沿领域。现在,让我们立即进入今天的论文速递。
[] 📚 BaichuanSEED: Sharing the Potential of ExtensivE Data Collection and Deduplication by Introducing a Competitive Large Language Model Baseline(BaichuanSEED:通过引入竞争性大型语言模型基线来分享广泛数据收集和去重化的潜力)
[] 🦅 Eagle: Exploring The Design Space for Multimodal LLMs with Mixture of Encoders(Eagle:探索多模态大型语言模型中混合编码器的设计空间)
[] 🐬 Dolphin: Long Context as a New Modality for Energy-Efficient On-Device Language Models(海豚:将长上下文作为新的能效模式用于设备上的语言模型)
[] 🚀 Distribution Backtracking Builds A Faster Convergence Trajectory for One-step Diffusion Distillation(分布回溯构建一步扩散蒸馏的更快收敛轨迹)
[] 📚 Leveraging Open Knowledge for Advancing Task Expertise in Large Language Models(利用开放知识提升大型语言模型任务专长)
[] 🔍 LLaVA-MoD: Making LLaVA Tiny via MoE Knowledge Distillation(LLaVA-MoD:通过MoE知识蒸馏使LLaVA小型化)
[] 🔍 Knowledge Navigator: LLM-guided Browsing Framework for Exploratory Search in Scientific Literature(知识导航器:基于大型语言模型的科学文献探索搜索框架)
[] 🤖 In-Context Imitation Learning via Next-Token Prediction(通过下一标记预测进行情境模仿学习)
[] 📊 Efficient LLM Scheduling by Learning to Rank(通过学习排序实现高效的大型语言模型调度)
[] 🔍 Towards Realistic Example-based Modeling via 3D Gaussian Stitching(基于3D高斯拼接的现实示例建模方法研究)
[] 📚 ReMamba: Equip Mamba with Effective Long-Sequence Modeling(ReMamba:为Mamba模型配备有效的长序列建模能力)
[] 🔄 Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts(无辅助损失的混合专家模型负载均衡策略)
[] 🎭 TEDRA: Text-based Editing of Dynamic and Photoreal Actors(TEDRA:基于文本的动态和逼真演员编辑)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟