H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

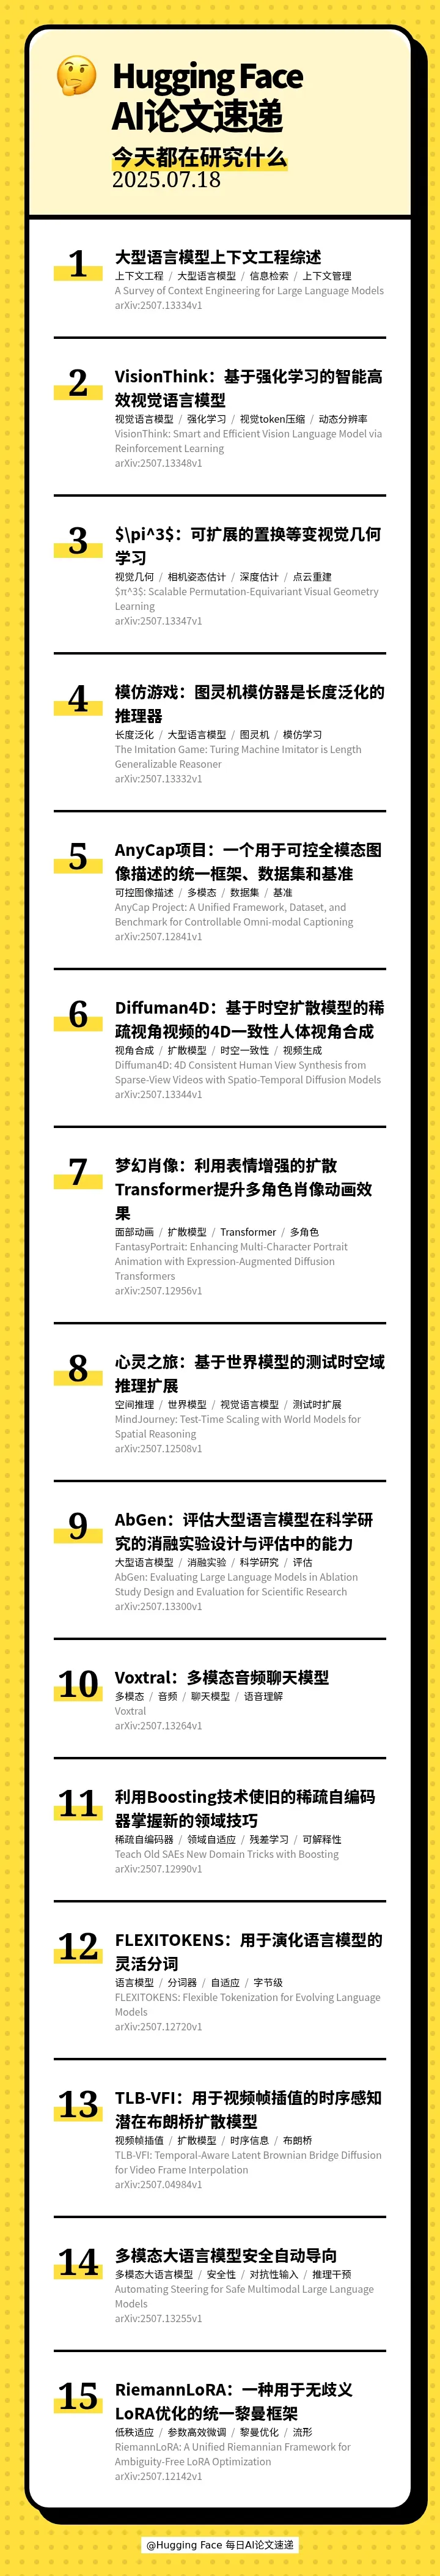
本期的 15 篇论文如下:
[] 🧮 A Survey of Context Engineering for Large Language Models(大型语言模型上下文工程综述)
[] 🧠 VisionThink: Smart and Efficient Vision Language Model via Reinforcement Learning(VisionThink:基于强化学习的智能高效视觉语言模型)
[] 📸 $π^3$: Scalable Permutation-Equivariant Visual Geometry Learning($\pi^3$:可扩展的置换等变视觉几何学习)
[] 🤖 The Imitation Game: Turing Machine Imitator is Length Generalizable Reasoner(模仿游戏:图灵机模仿器是长度泛化的推理器)
[] 🖼 AnyCap Project: A Unified Framework, Dataset, and Benchmark for Controllable Omni-modal Captioning(AnyCap项目:一个用于可控全模态图像描述的统一框架、数据集和基准)
[] 🧑 Diffuman4D: 4D Consistent Human View Synthesis from Sparse-View Videos with Spatio-Temporal Diffusion Models(Diffuman4D:基于时空扩散模型的稀疏视角视频的4D一致性人体视角合成)
[] 🎭 FantasyPortrait: Enhancing Multi-Character Portrait Animation with Expression-Augmented Diffusion Transformers(梦幻肖像:利用表情增强的扩散Transformer提升多角色肖像动画效果)
[] 🧠 MindJourney: Test-Time Scaling with World Models for Spatial Reasoning(心灵之旅:基于世界模型的测试时空域推理扩展)
[] 🔬 AbGen: Evaluating Large Language Models in Ablation Study Design and Evaluation for Scientific Research(AbGen:评估大型语言模型在科学研究的消融实验设计与评估中的能力)
[] 🗣 Voxtral(Voxtral:多模态音频聊天模型)
[] 💡 Teach Old SAEs New Domain Tricks with Boosting(利用Boosting技术使旧的稀疏自编码器掌握新的领域技巧)
[] 💡 FLEXITOKENS: Flexible Tokenization for Evolving Language Models(FLEXITOKENS:用于演化语言模型的灵活分词)
[] 🎬 TLB-VFI: Temporal-Aware Latent Brownian Bridge Diffusion for Video Frame Interpolation(TLB-VFI:用于视频帧插值的时序感知潜在布朗桥扩散模型)
[] 🛡 Automating Steering for Safe Multimodal Large Language Models(多模态大语言模型安全自动导向)
[] ⚙ RiemannLoRA: A Unified Riemannian Framework for Ambiguity-Free LoRA Optimization(RiemannLoRA:一种用于无歧义LoRA优化的统一黎曼框架)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 7 月 19 日 · 14 分钟
本期的 15 篇论文如下:
[] 🧮 A Survey of Context Engineering for Large Language Models(大型语言模型上下文工程综述)
[] 🧠 VisionThink: Smart and Efficient Vision Language Model via Reinforcement Learning(VisionThink:基于强化学习的智能高效视觉语言模型)
[] 📸 $π^3$: Scalable Permutation-Equivariant Visual Geometry Learning($\pi^3$:可扩展的置换等变视觉几何学习)
[] 🤖 The Imitation Game: Turing Machine Imitator is Length Generalizable Reasoner(模仿游戏:图灵机模仿器是长度泛化的推理器)
[] 🖼 AnyCap Project: A Unified Framework, Dataset, and Benchmark for Controllable Omni-modal Captioning(AnyCap项目:一个用于可控全模态图像描述的统一框架、数据集和基准)
[] 🧑 Diffuman4D: 4D Consistent Human View Synthesis from Sparse-View Videos with Spatio-Temporal Diffusion Models(Diffuman4D:基于时空扩散模型的稀疏视角视频的4D一致性人体视角合成)
[] 🎭 FantasyPortrait: Enhancing Multi-Character Portrait Animation with Expression-Augmented Diffusion Transformers(梦幻肖像:利用表情增强的扩散Transformer提升多角色肖像动画效果)
[] 🧠 MindJourney: Test-Time Scaling with World Models for Spatial Reasoning(心灵之旅:基于世界模型的测试时空域推理扩展)
[] 🔬 AbGen: Evaluating Large Language Models in Ablation Study Design and Evaluation for Scientific Research(AbGen:评估大型语言模型在科学研究的消融实验设计与评估中的能力)
[] 🗣 Voxtral(Voxtral:多模态音频聊天模型)
[] 💡 Teach Old SAEs New Domain Tricks with Boosting(利用Boosting技术使旧的稀疏自编码器掌握新的领域技巧)
[] 💡 FLEXITOKENS: Flexible Tokenization for Evolving Language Models(FLEXITOKENS:用于演化语言模型的灵活分词)
[] 🎬 TLB-VFI: Temporal-Aware Latent Brownian Bridge Diffusion for Video Frame Interpolation(TLB-VFI:用于视频帧插值的时序感知潜在布朗桥扩散模型)
[] 🛡 Automating Steering for Safe Multimodal Large Language Models(多模态大语言模型安全自动导向)
[] ⚙ RiemannLoRA: A Unified Riemannian Framework for Ambiguity-Free LoRA Optimization(RiemannLoRA:一种用于无歧义LoRA优化的统一黎曼框架)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟