H
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
【赞助商】
OpenClaw快报
每天五分钟,听听 OpenClaw 快报,带你了解最新动态和业内讨论
传送门 https://www.xiaoyuzhoufm.com/podcast/6a1732a2dffa135d0ab5ef43
【目录】
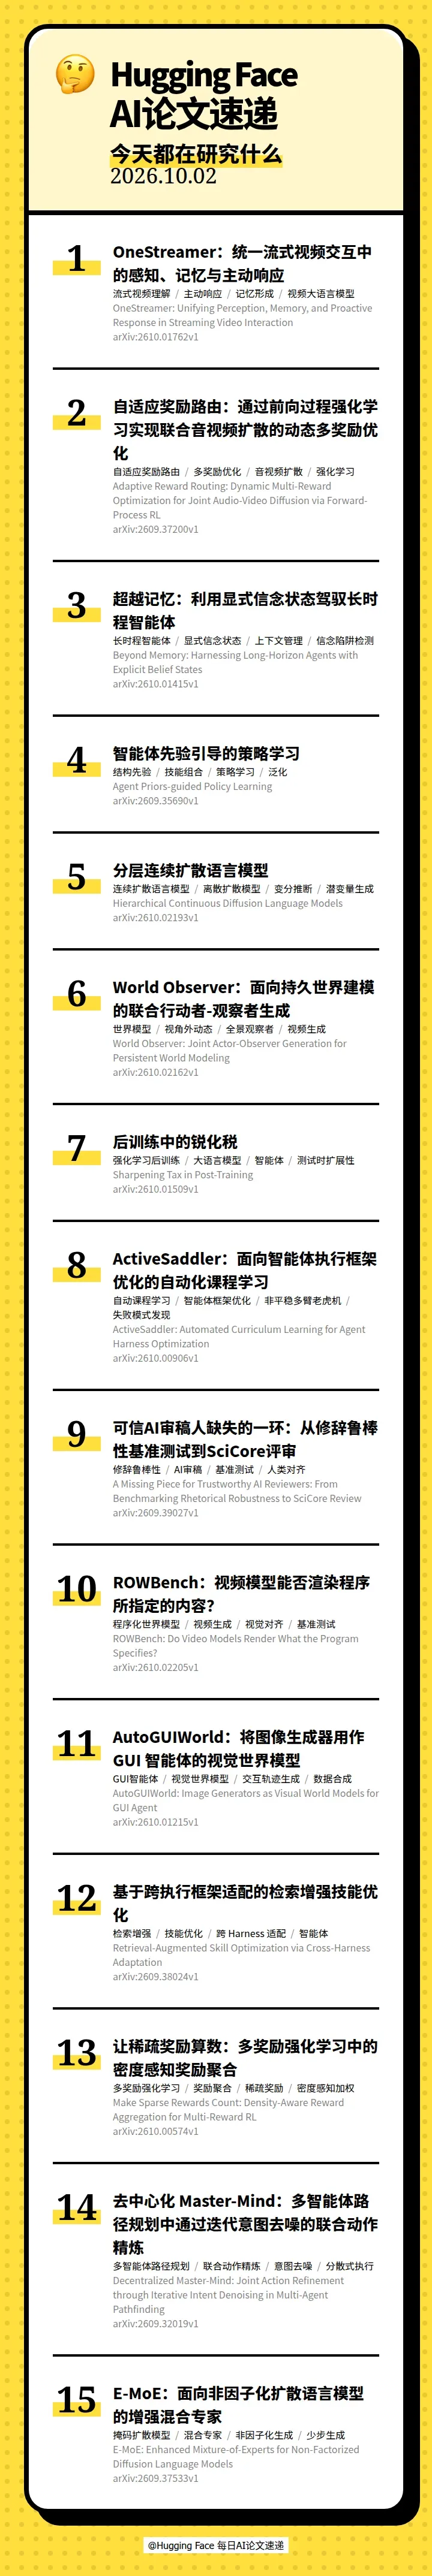
本期的 15 篇论文如下:
[] 🎥 OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction(OneStreamer:统一流式视频交互中的感知、记忆与主动响应)
[] 🔀 Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL(自适应奖励路由:通过前向过程强化学习实现联合音视频扩散的动态多奖励优化)
[] 🧠 Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States(超越记忆:利用显式信念状态驾驭长时程智能体)
[] 🤖 Agent Priors-guided Policy Learning(智能体先验引导的策略学习)
[] 🌀 Hierarchical Continuous Diffusion Language Models(分层连续扩散语言模型)
[] 👁 World Observer: Joint Actor-Observer Generation for Persistent World Modeling(World Observer:面向持久世界建模的联合行动者-观察者生成)
[] 📉 Sharpening Tax in Post-Training(后训练中的锐化税)
[] 🎯 ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization(ActiveSaddler:面向智能体执行框架优化的自动化课程学习)
[] 🤖 A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review(可信AI审稿人缺失的一环:从修辞鲁棒性基准测试到SciCore评审)
[] 🎮 ROWBench: Do Video Models Render What the Program Specifies?(ROWBench:视频模型能否渲染程序所指定的内容?)
[] 🤖 AutoGUIWorld: Image Generators as Visual World Models for GUI Agent(AutoGUIWorld:将图像生成器用作 GUI 智能体的视觉世界模型)
[] 🔍 Retrieval-Augmented Skill Optimization via Cross-Harness Adaptation(基于跨执行框架适配的检索增强技能优化)
[] ⚖ Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL(让稀疏奖励算数:多奖励强化学习中的密度感知奖励聚合)
[] 🤖 Decentralized Master-Mind: Joint Action Refinement through Iterative Intent Denoising in Multi-Agent Pathfinding(去中心化 Master-Mind:多智能体路径规划中通过迭代意图去噪的联合动作精炼)
[] 🧩 E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models(E-MoE:面向非因子化扩散语言模型的增强混合专家)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
AI 从整集转写里归纳的,不是节目方的宣传语
《后训练中的锐化税》比较十四对模型后指出:后训练提升 pass@1 却压低 pass@k 覆盖,模型越大税越重。
AutoGUIWorld 用预训练图像生成器预测下一张界面截图,ScreenSpot-Pro 成功率从 31.7% 升到 57.1%。
AI 读完整集转写后给出的推荐理由
十二分钟过完 2026 年 10 月 2 日的十五篇 AI 论文。最值得留意的是《后训练中的锐化税》:作者比较十四对基座与后训练模型,发现后训练把 pass@1 拉上去的同时压低了 pass@k 覆盖,任务变得要么总成功要么总失败,模型越大税越重。此外 OneStreamer 把上下文长度砍掉 93.1%,AutoGUIWorld 让 ScreenSpot-Pro 成功率从 31.7% 升到 57.1%,DMM-MICPO-3M 在 MoveAI 解出 1600 项中的 1598 项。
由 AI 从整集转写生成,是创作者说明之外的补充
本期 HuggingFace 每日 AI 论文速递覆盖 2026 年 10 月 2 日的十五篇论文,横跨流式视频交互、音视频扩散、智能体框架优化、扩散语言模型与多智能体规划。重点包括:OneStreamer 用主动分层字幕把上下文长度降低 93.1%;《超越记忆》提出显式信念状态,在四个基准上最高提升 37.89%;《后训练中的锐化税》比较十四对基座与后训练模型,发现后训练提升 pass@1 却降低 pass@k 覆盖;AutoGUIWorld 用图像生成器做 GUI 视觉世界模型,ScreenSpot-Pro 成功率从 31.7% 升至 57.1%;DMM-MICPO-3M 在 MoveAI 解出 1600 项中的 1598 项。整体线索是性能瓶颈从容量转向状态维护与验证。
点一章从那里开始播 · 与上面创作者标的时间点各自独立
开场:十五篇论文的四个方向
主持人交代本期为 2026 年 10 月 2 日刊,十五篇论文聚焦流式视频、音视频扩散、智能体与扩散语言模型,并播报赞助商口播后进入正文。
OneStreamer 与自适应奖励路由
第一篇 OneStreamer 研究流式视频大模型如何保留历史证据并主动判断何时沉默或回应,基于 Qwen3-VL-4B,上下文长度降低 93.1%。第二篇提出自适应奖励路由,用双向跨模态注意力动态定位应更新的 token 与网络层,在 LTX-2 上十项指标九项最佳。
显式信念状态与策略结构先验
第三篇《超越记忆》指出仅整理历史记忆的智能体难以理解当前世界,提出维护显式信念状态并识别停滞,四个基准最高提升 37.89%。第四篇把策略结构先验作为技能与组合器的接口,十六个未见组合中解出八个。
分层连续扩散语言模型与世界观察者
第五篇 HCDLM 用连续前轨迹做唯一持久状态,在 LAMBADA、WikiText 和 LMEB 上优于多种扩散基线。第六篇 WorldObserver 让透视行动者与全景观察者共享同一世界状态,提升视野外动态建模,局限是依赖全景输入。
锐化税与自动化课程学习
第七篇比较十四对基座与后训练模型,发现后训练提升 pass@1 却降低 pass@k 覆盖,任务两极化,并提出 PTGS 动态调温。第八篇 ActiveSaddler 把场景选择建模为自动化课程学习,在 GAIA 和 TerminalBench 2.0 上达 59.8% 和 80.0%。
AI 审稿人鲁棒性与 ROWBench
第九篇指出同一科学内容换种说法 AI 审稿分数可能变化,提出修辞鲁棒性要求并构建 RobustReview 基准。第十篇 ROWBench 检验视频模型能否忠实渲染程序规定的实体状态与定时事件,用 170 个片段、200 个视角评测 11 个模型。
AutoGUIWorld 与跨框架技能检索
第十一篇让预训练图像生成器充当 GUI 智能体的视觉世界模型,微调得到 AGW-3B,ScreenSpot-Pro 成功率从 31.7% 升至 57.1%。第十二篇针对 92.9% 检索技能来自不同框架的错配问题,提出 RACY 做跨执行框架适配。
奖励聚合与去中心化多智能体规划
第十三篇用优势能量和活跃组密度诊断多奖励信号失衡,提出 DAA 动态校准各奖励贡献。第十四篇 DMM 通过迭代意图去噪精炼联合动作,DMM-MICPO-3M 在 MoveAI 解出 1600 项中的 1598 项。
E-MoE 与收尾
第十五篇 E-MoE 用混合专家路由为掩码扩散语言模型引入离散共享隐变量,LMEB 单步生成困惑度 643.8,优于 1270.8 和 1433.8 的基线。主持人总结本期内容并引导评论、点赞、转发、订阅及关注小红书账号。
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟
2026.11.05 | 动作读取视觉层级;分钟级游戏世界数据
11 月 6 日 · 11 分钟
HuggingFace 每日AI论文速递 · 10 月 3 日 · 12 分钟
【赞助商】
OpenClaw快报
每天五分钟,听听 OpenClaw 快报,带你了解最新动态和业内讨论
传送门 https://www.xiaoyuzhoufm.com/podcast/6a1732a2dffa135d0ab5ef43
【目录】
本期的 15 篇论文如下:
[] 🎥 OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction(OneStreamer:统一流式视频交互中的感知、记忆与主动响应)
[] 🔀 Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL(自适应奖励路由:通过前向过程强化学习实现联合音视频扩散的动态多奖励优化)
[] 🧠 Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States(超越记忆:利用显式信念状态驾驭长时程智能体)
[] 🤖 Agent Priors-guided Policy Learning(智能体先验引导的策略学习)
[] 🌀 Hierarchical Continuous Diffusion Language Models(分层连续扩散语言模型)
[] 👁 World Observer: Joint Actor-Observer Generation for Persistent World Modeling(World Observer:面向持久世界建模的联合行动者-观察者生成)
[] 📉 Sharpening Tax in Post-Training(后训练中的锐化税)
[] 🎯 ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization(ActiveSaddler:面向智能体执行框架优化的自动化课程学习)
[] 🤖 A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review(可信AI审稿人缺失的一环:从修辞鲁棒性基准测试到SciCore评审)
[] 🎮 ROWBench: Do Video Models Render What the Program Specifies?(ROWBench:视频模型能否渲染程序所指定的内容?)
[] 🤖 AutoGUIWorld: Image Generators as Visual World Models for GUI Agent(AutoGUIWorld:将图像生成器用作 GUI 智能体的视觉世界模型)
[] 🔍 Retrieval-Augmented Skill Optimization via Cross-Harness Adaptation(基于跨执行框架适配的检索增强技能优化)
[] ⚖ Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL(让稀疏奖励算数:多奖励强化学习中的密度感知奖励聚合)
[] 🤖 Decentralized Master-Mind: Joint Action Refinement through Iterative Intent Denoising in Multi-Agent Pathfinding(去中心化 Master-Mind:多智能体路径规划中通过迭代意图去噪的联合动作精炼)
[] 🧩 E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models(E-MoE:面向非因子化扩散语言模型的增强混合专家)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
AI 从整集转写里归纳的,不是节目方的宣传语
《后训练中的锐化税》比较十四对模型后指出:后训练提升 pass@1 却压低 pass@k 覆盖,模型越大税越重。
AutoGUIWorld 用预训练图像生成器预测下一张界面截图,ScreenSpot-Pro 成功率从 31.7% 升到 57.1%。
AI 读完整集转写后给出的推荐理由
十二分钟过完 2026 年 10 月 2 日的十五篇 AI 论文。最值得留意的是《后训练中的锐化税》:作者比较十四对基座与后训练模型,发现后训练把 pass@1 拉上去的同时压低了 pass@k 覆盖,任务变得要么总成功要么总失败,模型越大税越重。此外 OneStreamer 把上下文长度砍掉 93.1%,AutoGUIWorld 让 ScreenSpot-Pro 成功率从 31.7% 升到 57.1%,DMM-MICPO-3M 在 MoveAI 解出 1600 项中的 1598 项。
由 AI 从整集转写生成,是创作者说明之外的补充
本期 HuggingFace 每日 AI 论文速递覆盖 2026 年 10 月 2 日的十五篇论文,横跨流式视频交互、音视频扩散、智能体框架优化、扩散语言模型与多智能体规划。重点包括:OneStreamer 用主动分层字幕把上下文长度降低 93.1%;《超越记忆》提出显式信念状态,在四个基准上最高提升 37.89%;《后训练中的锐化税》比较十四对基座与后训练模型,发现后训练提升 pass@1 却降低 pass@k 覆盖;AutoGUIWorld 用图像生成器做 GUI 视觉世界模型,ScreenSpot-Pro 成功率从 31.7% 升至 57.1%;DMM-MICPO-3M 在 MoveAI 解出 1600 项中的 1598 项。整体线索是性能瓶颈从容量转向状态维护与验证。
点一章从那里开始播 · 与创作者标的时间点各自独立
开场:十五篇论文的四个方向
OneStreamer 与自适应奖励路由
显式信念状态与策略结构先验
分层连续扩散语言模型与世界观察者
锐化税与自动化课程学习
AI 审稿人鲁棒性与 ROWBench
AutoGUIWorld 与跨框架技能检索
奖励聚合与去中心化多智能体规划
E-MoE 与收尾
节目里自然聊到的,不是广告
AI 识别出的推广,播放条上用橙色区段标出
面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 738 期 · 最近更新 11 月 8 日
AI 对内容的推测
☕🧄 这个比喻出自 2009 年周立波的一句「喝咖啡的怎么能和吃大蒜的呆在一起呢」;郭德纲后来在《你要高雅》里回了一句「雅和俗分不开,喝着咖啡就着大蒜,秋水共长天一色」。我们借它标注风格取向 —— 两端没有高下,编辑部式与熟人局式都能做出极好的节目。
https://feed.xyzfm.space/7jtt3j3lbbra复制概要、章节、提及与推广标注由 AI 生成,可能有误;内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟