4
锐评国模与 Neo Lab,畅谈 RL 人生与 RLaaS | 对谈 Mind Lab 首席科学家骁腾
11 月 7 日 · 1 小时 03 分
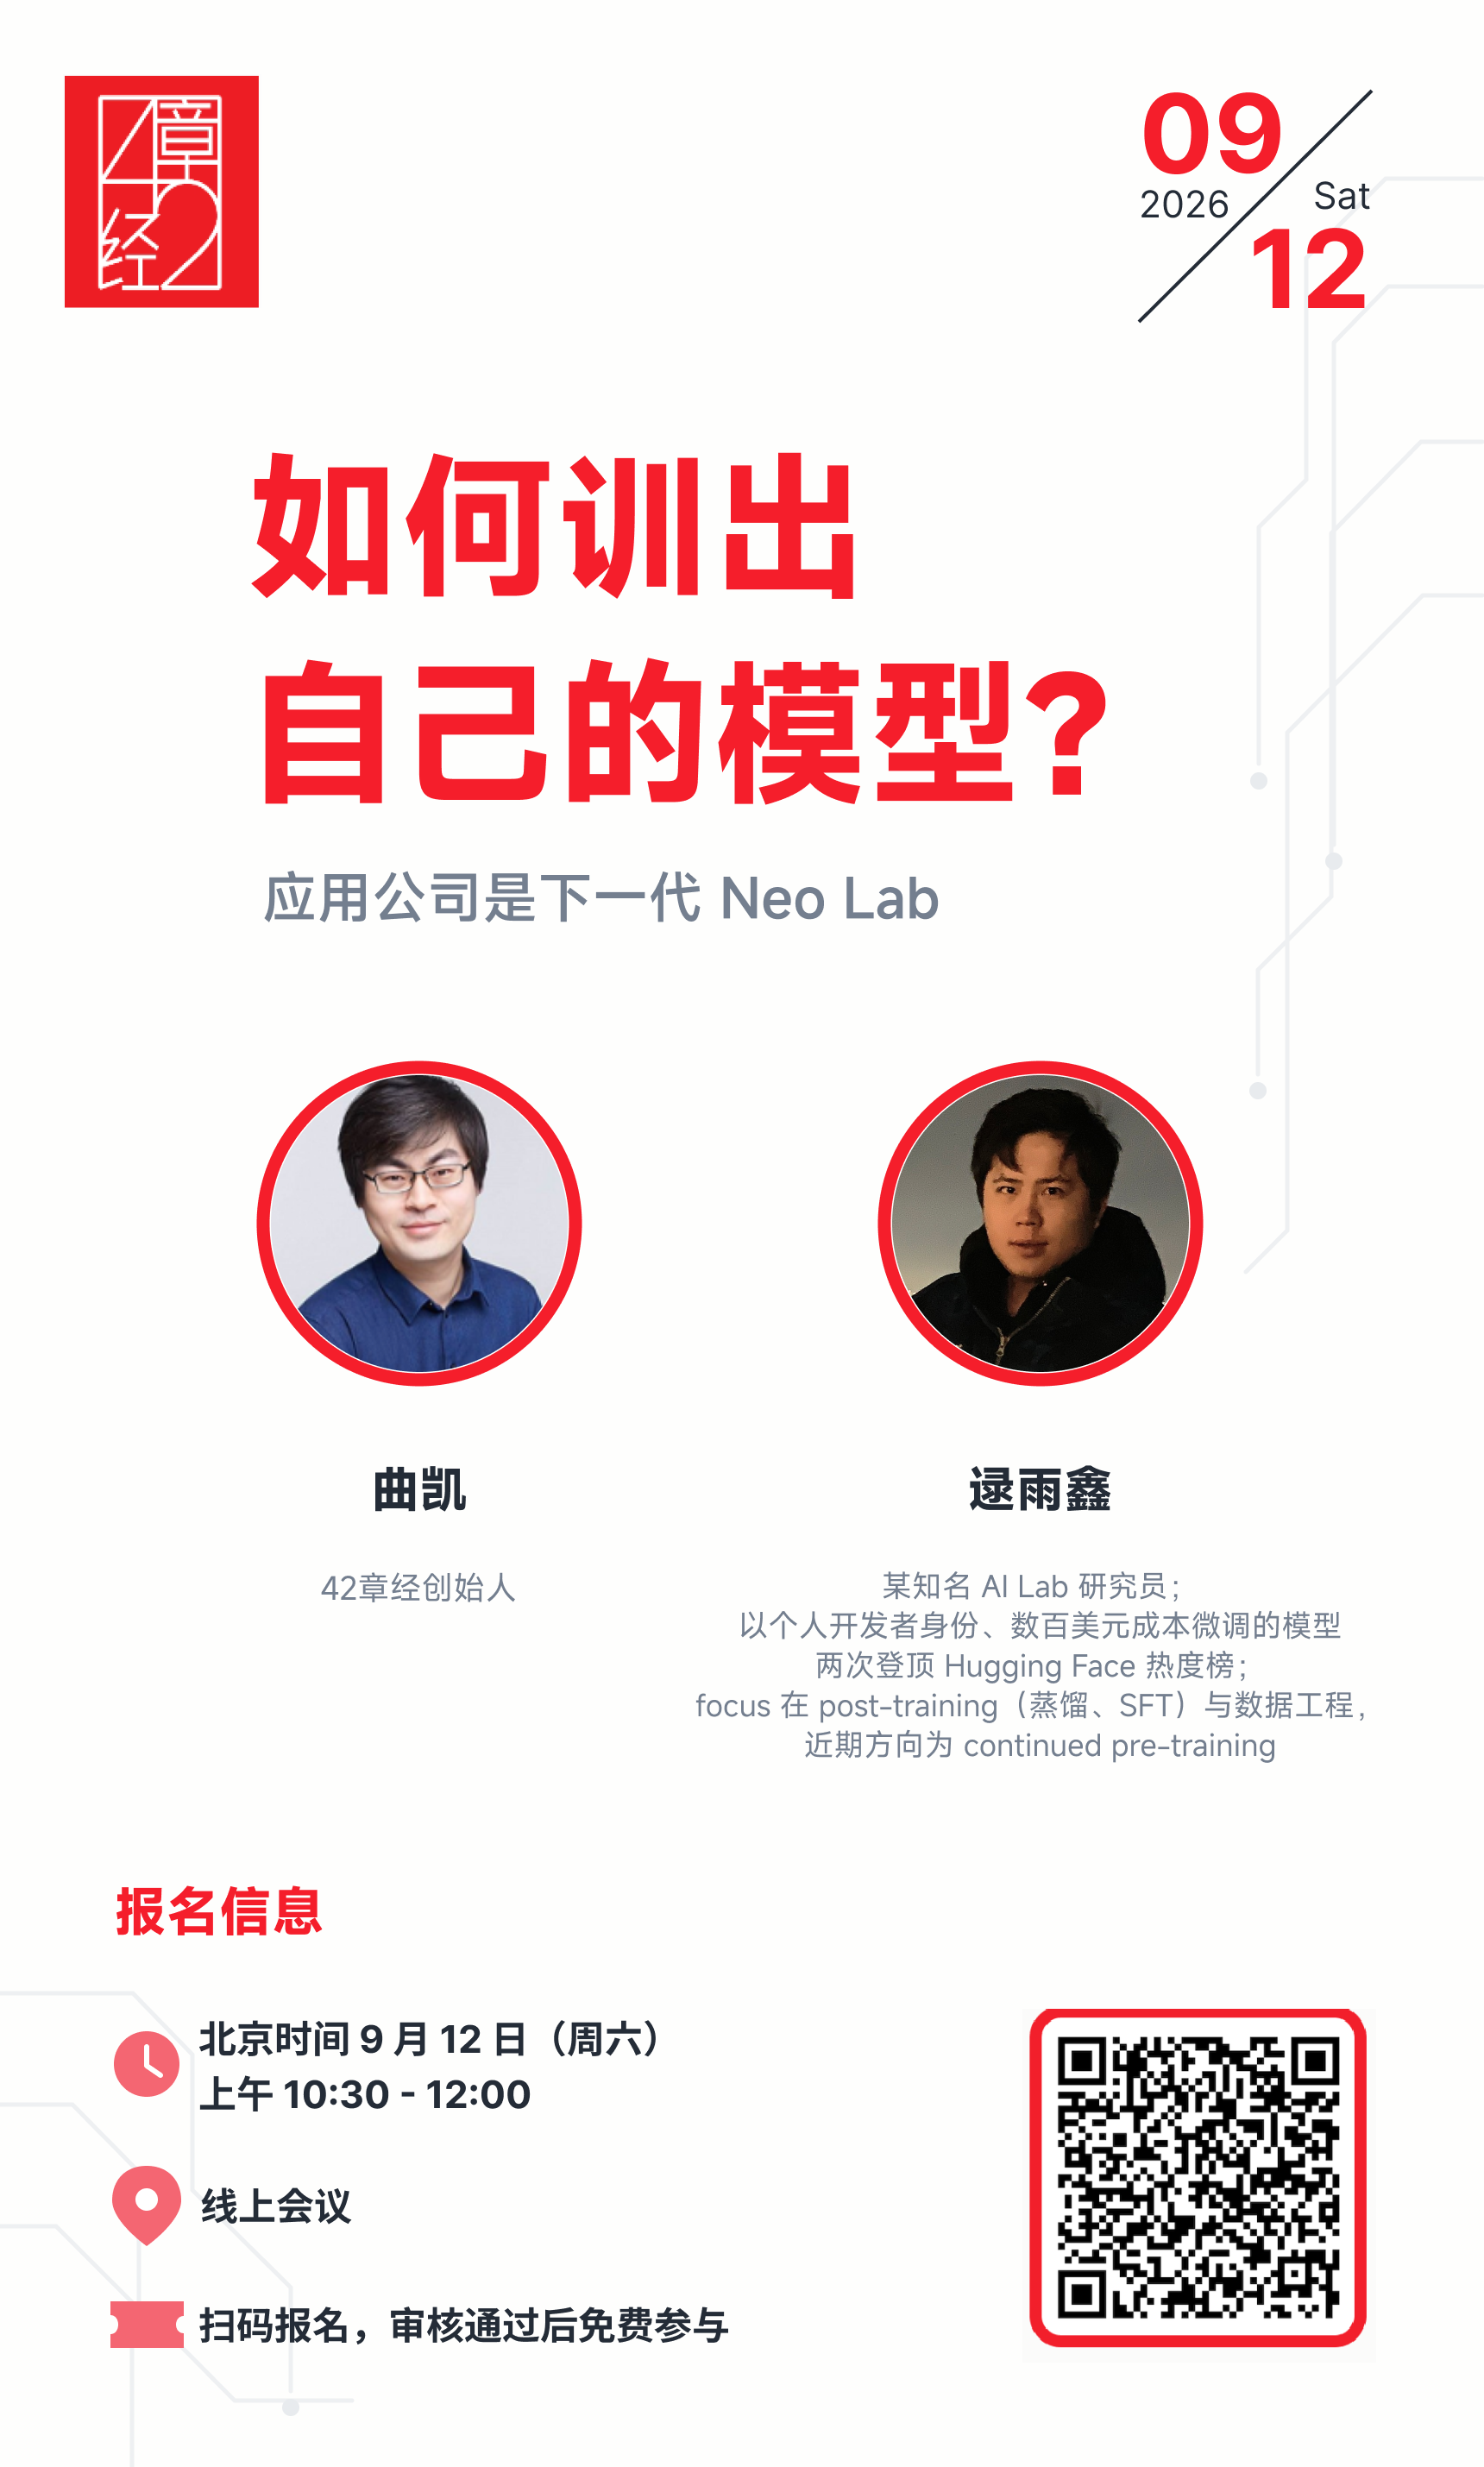
活动预告🥳:9 月 12 日,我们会请到雨鑫做一场线上活动,大家记得翻到 shownotes 末尾查看报名信息!
最近硅谷有了新热点:主权 AI 和 Personal Intelligence。简单来说,就是很多人开始相信,未来会有越来越多的应用公司和个人,训练自己的模型。
对绝大多数人来说,训练模型仍然是一件听起来遥不可及、门槛很高的事,但我们这期节目的嘉宾逯雨鑫却认为,它非常简单,简单到他此前没有 AI Lab 的经历,也不是 AI PhD,只用了 2 周和数百美元,就后训练出了两个登顶 Hugging Face Model Trending 榜首的小模型。
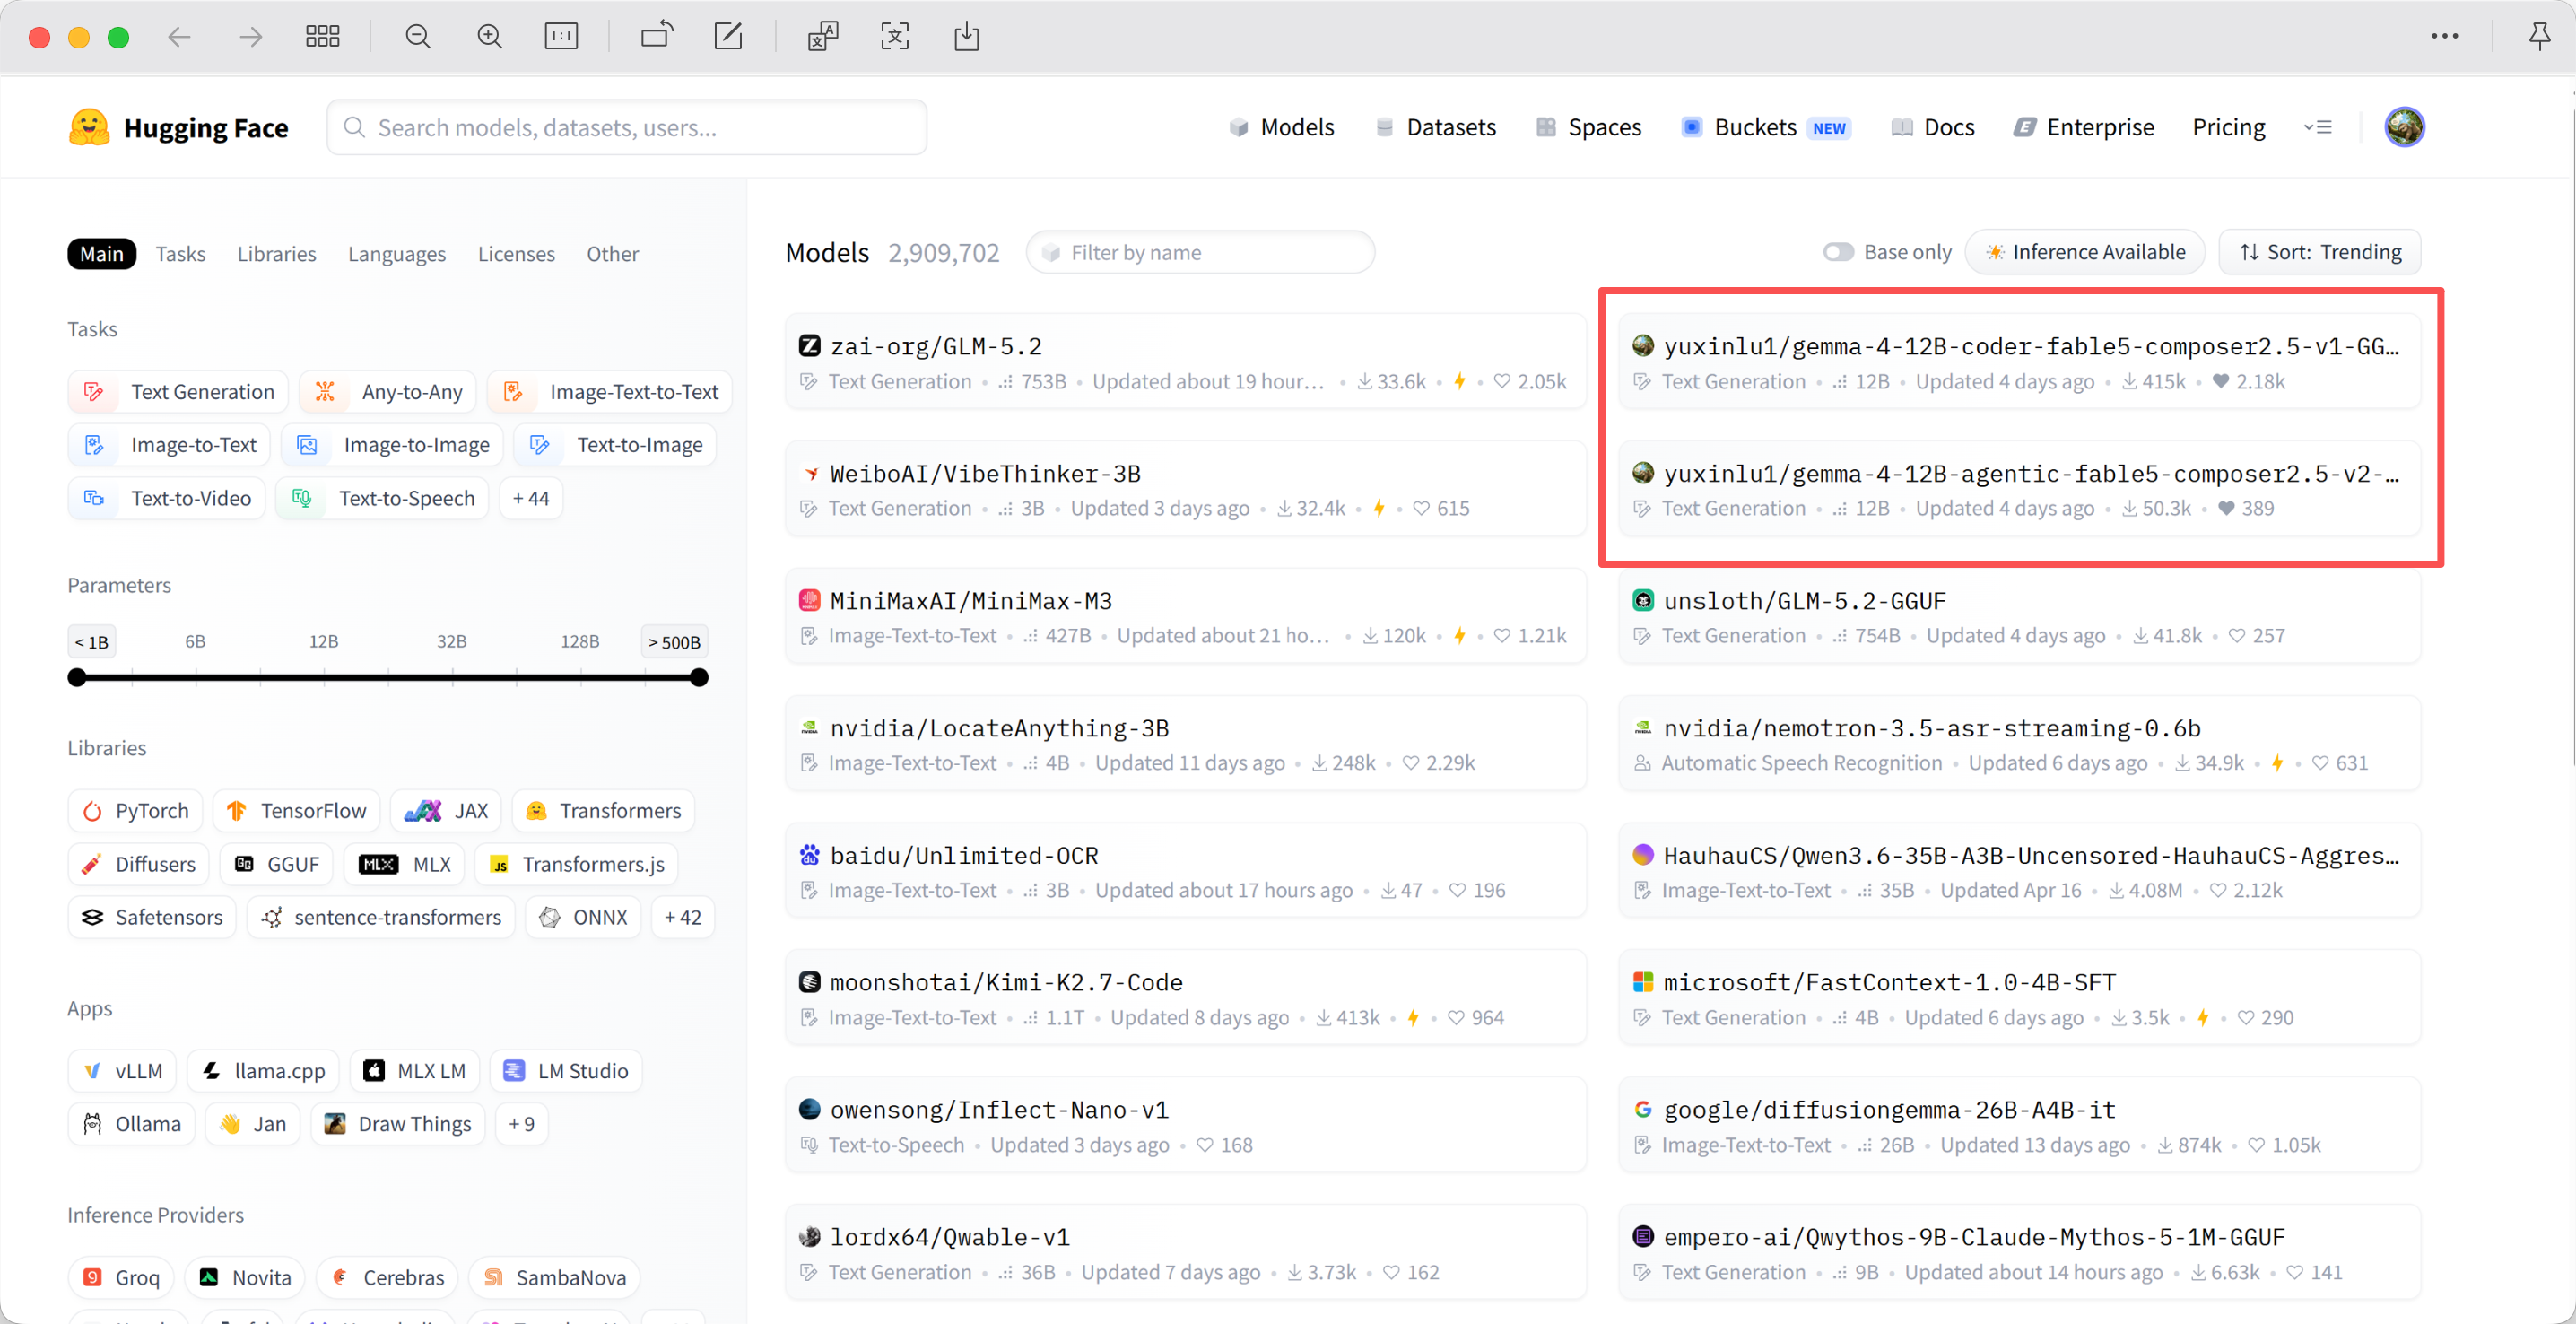
他具体是怎么做到的、摸索出了怎样的 Pipeline?过程中踩过哪些坑?以及无论对个人还是公司来说,训练模型最大的卡点都是数据,那么他是怎么攻克这个难题的?在蒸馏路线、数据来源上,又有哪些 secret sauce?
节目后半段,我们还进一步讨论了主权 AI、Personal Intelligence 和 Local AI 相关的各种问题,比如这些事情普及开来的门槛在哪里、未来 AI Lab 和应用公司的分工与价值会有什么变化等等。
就在一个月前,我们还在讲 AI 应用遭受的冷遇;但录完这期,我们好像又看到了应用的曙光。也许在不久的将来,越来越多的应用公司都会成为 Neo Lab,Local AI 也可能成为一个 PC 级别的机会。而拥抱模型训练和 Local AI,最好的时间可能就是现在。
希望雨鑫摸索出的实践路径,能给应用公司和个人带来一些启发。如果你还想了解更多,也欢迎报名 shownote 末尾的线上活动,来和雨鑫直接交流(尤其欢迎应用创业者!)
【人类博物馆】
导游:曲凯,42章经创始人
52 号珍藏:逯雨鑫,Mind Lab 研究员;以个人开发者身份、数百美元成本微调的模型两次登顶 Hugging Face 热度榜;focus 在 post-training(蒸馏、SFT)与数据工程,近期方向为 continued pre-training
【时光机】
Part 1 训模型的实操经验
非 PhD / AI Lab 背景,凭什么能训出榜一模型?
训这两个模型的成本具体有多少?
个人训模型的完整 Pipeline 和避坑经验
最大的难点和卡点:数据
合成数据效果并不好?
数据从哪来、具体要用多少、如何配比?
数据难以提前预估效果的原因:Capacity Gap
简评蒸馏的各种路线,以及到底什么叫「聪明地蒸」?
自己训、自己用,性价比真的更高吗?
坑最少的开源模型是?
Part 2 对主权 AI 的思考
自己训模型会成为应用公司的标配吗?
训模型可能会成为一件商品化的事情?
应用公司反而可能会成为 Neo Lab?
AI Lab 和应用公司之间的分工可能会有什么变化?
现在 AI Lab 砸钱买数据,就有点像移动互联网早期字节砸钱买用户
如果主权 AI 真的兴起,AI Lab 的价值会有什么变化?
Local AI 会不会成为 PC 级别的机会?
用户最终会不会还是希望用上 SOTA 级别的智能,而不是 Local AI?
【活动预告🥳】
9 月 12 日,我们会请到雨鑫做一场线上活动,感兴趣的朋友欢迎点击链接或扫描下面的二维码,一起来认识&交流!
【The gang that made this happen】
制作人:陈皮
剪辑:陈皮
片头:Mondo Bongo - Joe Strummer & The Mescaleros
片尾:Spacemen 3 - Set Me Free (Reprise)
说明里标出的时间点,点一下跳过去
AI 从整集转写里归纳的,不是节目方的宣传语
真实数据占六七成、五千条要人工审五百条——小模型微调的真实成本几乎全在数据审核上。
嘉宾亲历的细节:42B 底座量化后大部分时间在说粤语,以及小模型「没做完就宣布完成」的过度自信病症。
编辑追问隐私是不是伪需求,嘉宾坦承自己本地模型使用率并不高,没有把趋势说成 already here。
AI 读完整集转写后给出的推荐理由
一个没读博士、没进过大厂 AI Lab 的研究生,用一张 5090 和几百美元,做出了 Hugging Face 开源榜第一的模型。他把流程拆成五步,说清 95% 的时间其实花在审数据上,还讲了小模型「任务没做完就宣布完成」这种具体病症怎么治。后半段聊 AI Lab 会收缩、应用公司接管后训练,以及本地模型到底是不是真需求。
由 AI 从整集转写生成,是创作者说明之外的补充
研究员逯雨鑫在没有博士背景、没进过 AI Lab 的情况下,用一张 5090、几百美元和两周时间,做出了在 Hugging Face 开源模型榜登顶的微调模型。他在节目里完整拆解了流程:定目标、选底座、搭数据管线、选 SFT 而非 RL、迭代评测,并指出 95% 的时间花在数据上,合成数据必须人工审核,还要面对老师太强学生太弱的 Capacity Gap。后半段讨论产业走向:AI Lab 会收缩到前沿研究与预训练,中大型应用公司会自建三四人的小团队接管后训练,因为数据在应用侧;以及本地 AI 与隐私需求的真实边界。
点一章从那里开始播 · 与上面创作者标的时间点各自独立
一个研究生,做出了开源榜一的模型
主播介绍逯雨鑫:做过 data engineer,读了 AI 方向研究生,目前在一家 AI Lab 做研究员,而那个登顶 Hugging Face 的模型是他入职前独立完成的。嘉宾自述从 2022 年 GPT 开放时开始接触 AI,认为工业界训模型主要就是 SFT 和 RL 两条路,基础补好人人可做。
五天、一张 5090、几百美元
第一版基于 42B 底座继续训练,耗时五天;第二版两三周。硬件只有一张 5090 加 QLoRA,配合 Claude Max 订阅合成靶向数据,社区用户还贡献了真实轨迹数据。租卡一两美元一小时,硬件成本不超过一百美元。效果上 agentic benchmark 从约十五分提到五十五到六十分,但其他 benchmark 有下降。
五步流程:定目标、选底座、搭数据、选方法、迭代
逯雨鑫把流程拆成五步,强调先明确目标而非追热点;选底座要注意中文能力,42B 底座量化后大量输出粤语,中文场景应选千问系;数据可合成也可取自 Hugging Face 与 ModelScope;方法上只有 SFT 对个人和应用公司实际,RL 成本过高;最后跑 benchmark 从错题迭代。
95% 的时间都花在数据上
他明确说真正卡住自己的是数据洞察力,训练本身几小时一轮非常快。整套流程的脚本、数据、benchmark 全部开源,环境也能低价买到,所以难点不在工程而在数据。
合成数据治不了所有的病
真实数据占 60% 到 70%,其余是靶向合成数据。他举小模型「过度自信」的例子:任务没完成就宣布完成,这类数据公开集里没有,只能自己合成,但只对 AI 说一句做出来的数据完全不对,必须自己下场对齐目标。五千条数据要人工审五百条。
Capacity Gap:老师太强,学生太弱
第一版三天做数据一天训练,第二版两周里十二天做数据。数据看着好,训出来仍可能没提升,因为几 T 参数级别的老师模型轨迹蒸馏进 12B 学生模型会丢失大量能力。结论只能一版一版测,不要因为一版不理想就放弃。
什么叫好的蒸馏:看锚点,不看分数
蒸馏分 on-policy 与 off-policy,后者成本极高。逯雨鑫给出判据:锚点决定好坏。锚在 benchmark 上、蒸一堆衍生变体而真实目标在别处,就是不好的蒸馏;只要模型分布被拉向真正想要的方向,benchmark 掉分也是好蒸馏。
成本账:小模型一万,大模型二十万
他的项目能成,是因为锚点选在 agentic 和 coding 这两个真实使用最密集的领域。应用公司训小模型几千到一万人民币以下,大模型十几万到二十万;部署侧十几并发一台 H200 几万块即可,用户量大了 serving 端才开始有坑。
踩过的坑与「现在做的人还不多」
他最早公开的微调模型是写武侠小说的,因为找不到合口味的小说而自己做。他建议重点搞千问系,架构主流、脚本齐全,别太相信 AI,要多查真实成功案例。他认为有能力做这件事的人已经不少,但多数人把它想得太复杂。
未来每家中大型公司都会有 AI 小团队
中大型公司组三四人的小团队即可,预算主要是工资加显卡。现在显卡和内存处在价格高点,供应上来后成本会大幅下降。主播追问为何没人做端到端 pipeline,嘉宾说所有公司都在想,Hugging Face Jobs 已在做但坑不少,inference 是主要障碍。
AI Lab 会变少,应用公司接管后训练
主播列举主权 AI、数据标注公司自选模型、应用公司自训模型等迹象。嘉宾认为 AI Lab 数量会减少但价值仍在,会往研究、预训练和平台服务走;中大型应用公司自建团队接管后训练,因为不愿分享数据。主播用推荐算法时代没有中立第三方公司作类比。
数据为什么值钱
主播提到「模型吃掉一切」的论调下应用公司遇冷,但近期判断在反转。嘉宾说 AI Lab 花钱买数据,是因为想看 AI 真正帮用户解决问题的过程;免费开放模型既宣传也收集数据,一台 B300 几十万到几百万的成本背后是数据回报。
为什么还是选择加入一家 AI Lab
嘉宾说自己判断仍会有 AI Lab 成为赢家,希望往 research 和预训练方向走,预训练需要上百甚至两百多张卡跑几个月,只有 AI Lab 能做。他同时提醒:如果 AI Lab 不再开源,对应用公司是毁灭性打击,有预算的中大型公司现在就该开始自建迭代能力。
从巨型机到人手一个模型
主播用计算机从巨型机到 PC 的演化类比 AI。嘉宾认为本地 AI 是必然趋势:调 API 数据对上游可见,中转站灰色且会卖数据,已有数据泄露被威胁的案例;写小说这类场景 token 成本可达几千几万。他预计 2027、2028 年 2TB 统一内存的电脑能本地跑接近当前主流的模型。
隐私是真需求吗:编辑的追问
编辑陈皮追问:如果用户最终要最强智能,本地模型离 SOTA 有距离,隐私会不会是伪需求?嘉宾承认自己本地使用率不高,但安全从业者和生物领域研究者对数据极敏感,后者常被前沿模型拒答,只能自部署中等模型。他举 Hugging Face 被攻击后用国产模型本地部署解决为例。
大多数人只看性价比
主播补充:SOTA 到什么程度才算够用,存在性价比拐点,像 4G 够用就不必上 5G。嘉宾承认很多人是盲目追求最强。主播判断最后豆包用户更多,隐私不是靠个人选择推动,而是应用公司与模型公司天然竞对,由苹果这类公司来推。节目在感谢与收尾中结束。
锐评国模与 Neo Lab,畅谈 RL 人生与 RLaaS | 对谈 Mind Lab 首席科学家骁腾
11 月 7 日 · 1 小时 03 分
少有的同时做过 Agent、多模态和具身的人 | 对谈前混元多模态 RL Infra 负责人淏楠
10 月 24 日 · 54 分钟
这个破业非创不可吗?|对谈 Articuler.ai 创始人 Jason
10 月 17 日 · 55 分钟
一个 Personal Agent 创业者的思考|对谈 Ambi 创始人子皓
10 月 13 日 · 1 小时 26 分
42章经 · 8 月 29 日 · 47 分钟
活动预告🥳:9 月 12 日,我们会请到雨鑫做一场线上活动,大家记得翻到 shownotes 末尾查看报名信息!
最近硅谷有了新热点:主权 AI 和 Personal Intelligence。简单来说,就是很多人开始相信,未来会有越来越多的应用公司和个人,训练自己的模型。
对绝大多数人来说,训练模型仍然是一件听起来遥不可及、门槛很高的事,但我们这期节目的嘉宾逯雨鑫却认为,它非常简单,简单到他此前没有 AI Lab 的经历,也不是 AI PhD,只用了 2 周和数百美元,就后训练出了两个登顶 Hugging Face Model Trending 榜首的小模型。
他具体是怎么做到的、摸索出了怎样的 Pipeline?过程中踩过哪些坑?以及无论对个人还是公司来说,训练模型最大的卡点都是数据,那么他是怎么攻克这个难题的?在蒸馏路线、数据来源上,又有哪些 secret sauce?
节目后半段,我们还进一步讨论了主权 AI、Personal Intelligence 和 Local AI 相关的各种问题,比如这些事情普及开来的门槛在哪里、未来 AI Lab 和应用公司的分工与价值会有什么变化等等。
就在一个月前,我们还在讲 AI 应用遭受的冷遇;但录完这期,我们好像又看到了应用的曙光。也许在不久的将来,越来越多的应用公司都会成为 Neo Lab,Local AI 也可能成为一个 PC 级别的机会。而拥抱模型训练和 Local AI,最好的时间可能就是现在。
希望雨鑫摸索出的实践路径,能给应用公司和个人带来一些启发。如果你还想了解更多,也欢迎报名 shownote 末尾的线上活动,来和雨鑫直接交流(尤其欢迎应用创业者!)
【人类博物馆】
导游:曲凯,42章经创始人
52 号珍藏:逯雨鑫,Mind Lab 研究员;以个人开发者身份、数百美元成本微调的模型两次登顶 Hugging Face 热度榜;focus 在 post-training(蒸馏、SFT)与数据工程,近期方向为 continued pre-training
【时光机】
Part 1 训模型的实操经验
非 PhD / AI Lab 背景,凭什么能训出榜一模型?
训这两个模型的成本具体有多少?
个人训模型的完整 Pipeline 和避坑经验
最大的难点和卡点:数据
合成数据效果并不好?
数据从哪来、具体要用多少、如何配比?
数据难以提前预估效果的原因:Capacity Gap
简评蒸馏的各种路线,以及到底什么叫「聪明地蒸」?
自己训、自己用,性价比真的更高吗?
坑最少的开源模型是?
Part 2 对主权 AI 的思考
自己训模型会成为应用公司的标配吗?
训模型可能会成为一件商品化的事情?
应用公司反而可能会成为 Neo Lab?
AI Lab 和应用公司之间的分工可能会有什么变化?
现在 AI Lab 砸钱买数据,就有点像移动互联网早期字节砸钱买用户
如果主权 AI 真的兴起,AI Lab 的价值会有什么变化?
Local AI 会不会成为 PC 级别的机会?
用户最终会不会还是希望用上 SOTA 级别的智能,而不是 Local AI?
【活动预告🥳】
9 月 12 日,我们会请到雨鑫做一场线上活动,感兴趣的朋友欢迎点击链接或扫描下面的二维码,一起来认识&交流!
【The gang that made this happen】
制作人:陈皮
剪辑:陈皮
片头:Mondo Bongo - Joe Strummer & The Mescaleros
片尾:Spacemen 3 - Set Me Free (Reprise)
说明里标出的时间点,点一下跳过去
AI 从整集转写里归纳的,不是节目方的宣传语
真实数据占六七成、五千条要人工审五百条——小模型微调的真实成本几乎全在数据审核上。
嘉宾亲历的细节:42B 底座量化后大部分时间在说粤语,以及小模型「没做完就宣布完成」的过度自信病症。
编辑追问隐私是不是伪需求,嘉宾坦承自己本地模型使用率并不高,没有把趋势说成 already here。
AI 读完整集转写后给出的推荐理由
一个没读博士、没进过大厂 AI Lab 的研究生,用一张 5090 和几百美元,做出了 Hugging Face 开源榜第一的模型。他把流程拆成五步,说清 95% 的时间其实花在审数据上,还讲了小模型「任务没做完就宣布完成」这种具体病症怎么治。后半段聊 AI Lab 会收缩、应用公司接管后训练,以及本地模型到底是不是真需求。
由 AI 从整集转写生成,是创作者说明之外的补充
研究员逯雨鑫在没有博士背景、没进过 AI Lab 的情况下,用一张 5090、几百美元和两周时间,做出了在 Hugging Face 开源模型榜登顶的微调模型。他在节目里完整拆解了流程:定目标、选底座、搭数据管线、选 SFT 而非 RL、迭代评测,并指出 95% 的时间花在数据上,合成数据必须人工审核,还要面对老师太强学生太弱的 Capacity Gap。后半段讨论产业走向:AI Lab 会收缩到前沿研究与预训练,中大型应用公司会自建三四人的小团队接管后训练,因为数据在应用侧;以及本地 AI 与隐私需求的真实边界。
点一章从那里开始播 · 与创作者标的时间点各自独立
一个研究生,做出了开源榜一的模型
五天、一张 5090、几百美元
五步流程:定目标、选底座、搭数据、选方法、迭代
95% 的时间都花在数据上
合成数据治不了所有的病
Capacity Gap:老师太强,学生太弱
什么叫好的蒸馏:看锚点,不看分数
成本账:小模型一万,大模型二十万
踩过的坑与「现在做的人还不多」
未来每家中大型公司都会有 AI 小团队
AI Lab 会变少,应用公司接管后训练
数据为什么值钱
为什么还是选择加入一家 AI Lab
从巨型机到人手一个模型
隐私是真需求吗:编辑的追问
大多数人只看性价比
节目里自然聊到的,不是广告
AI 对内容的推测
☕🧄 这个比喻出自 2009 年周立波的一句「喝咖啡的怎么能和吃大蒜的呆在一起呢」;郭德纲后来在《你要高雅》里回了一句「雅和俗分不开,喝着咖啡就着大蒜,秋水共长天一色」。我们借它标注风格取向 —— 两端没有高下,编辑部式与熟人局式都能做出极好的节目。
https://feed.xyzfm.space/evgg6xle9rdc复制概要、章节、提及与推广标注由 AI 生成,可能有误;内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
锐评国模与 Neo Lab,畅谈 RL 人生与 RLaaS | 对谈 Mind Lab 首席科学家骁腾
11 月 7 日 · 1 小时 03 分
少有的同时做过 Agent、多模态和具身的人 | 对谈前混元多模态 RL Infra 负责人淏楠
10 月 24 日 · 54 分钟
这个破业非创不可吗?|对谈 Articuler.ai 创始人 Jason
10 月 17 日 · 55 分钟