H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

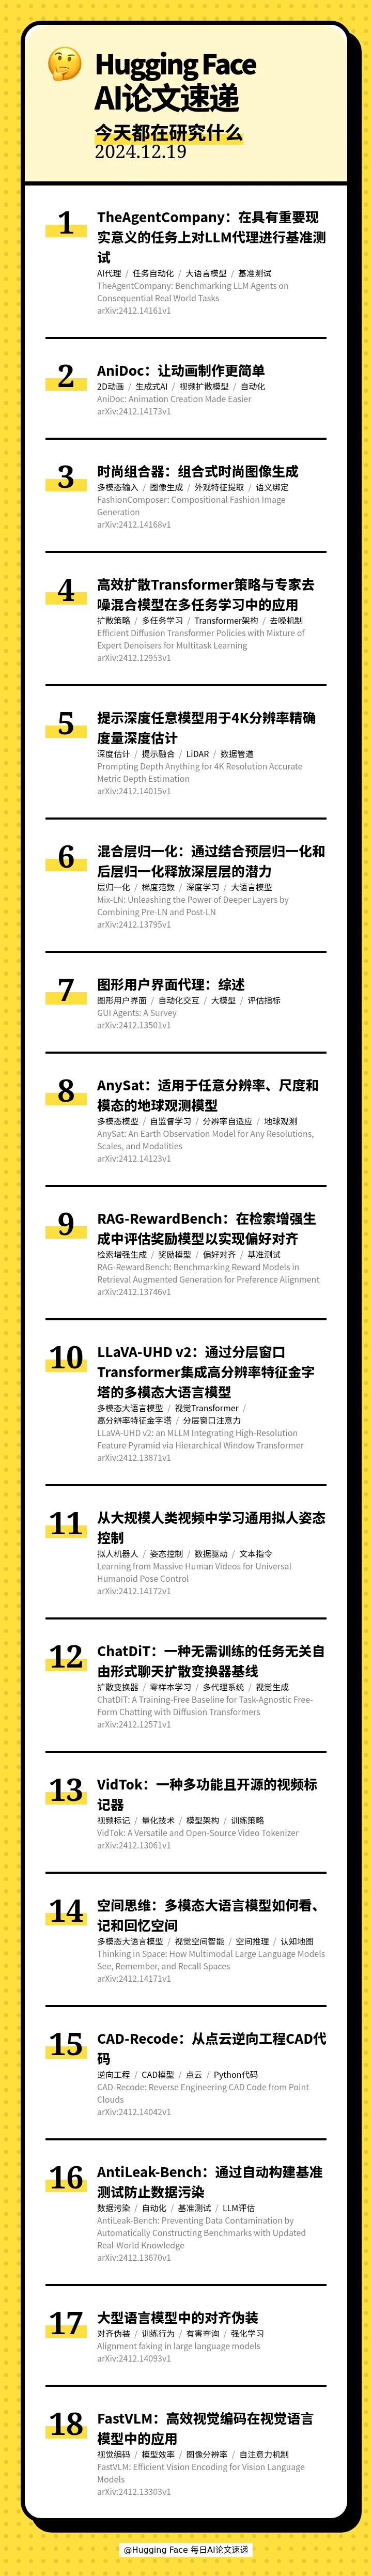
本期的 18 篇论文如下:
[] 🤖 TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks(TheAgentCompany:在具有重要现实意义的任务上对LLM代理进行基准测试)
[] 🎥 AniDoc: Animation Creation Made Easier(AniDoc:让动画制作更简单)
[] 👗 FashionComposer: Compositional Fashion Image Generation(时尚组合器:组合式时尚图像生成)
[] 🤖 Efficient Diffusion Transformer Policies with Mixture of Expert Denoisers for Multitask Learning(高效扩散Transformer策略与专家去噪混合模型在多任务学习中的应用)
[] 🌐 Prompting Depth Anything for 4K Resolution Accurate Metric Depth Estimation(提示深度任意模型用于4K分辨率精确度量深度估计)
[] 🔄 Mix-LN: Unleashing the Power of Deeper Layers by Combining Pre-LN and Post-LN(混合层归一化:通过结合预层归一化和后层归一化释放深层层的潜力)
[] 🤖 GUI Agents: A Survey(图形用户界面代理:综述)
[] 🌍 AnySat: An Earth Observation Model for Any Resolutions, Scales, and Modalities(AnySat:适用于任意分辨率、尺度和模态的地球观测模型)
[] 📊 RAG-RewardBench: Benchmarking Reward Models in Retrieval Augmented Generation for Preference Alignment(RAG-RewardBench:在检索增强生成中评估奖励模型以实现偏好对齐)
[] 🧠 LLaVA-UHD v2: an MLLM Integrating High-Resolution Feature Pyramid via Hierarchical Window Transformer(LLaVA-UHD v2:通过分层窗口Transformer集成高分辨率特征金字塔的多模态大语言模型)
[] 🤖 Learning from Massive Human Videos for Universal Humanoid Pose Control(从大规模人类视频中学习通用拟人姿态控制)
[] 🤖 ChatDiT: A Training-Free Baseline for Task-Agnostic Free-Form Chatting with Diffusion Transformers(ChatDiT:一种无需训练的任务无关自由形式聊天扩散变换器基线)
[] 🎥 VidTok: A Versatile and Open-Source Video Tokenizer(VidTok:一种多功能且开源的视频标记器)
[] 🧠 Thinking in Space: How Multimodal Large Language Models See, Remember, and Recall Spaces(空间思维:多模态大语言模型如何看、记和回忆空间)
[] 🔄 CAD-Recode: Reverse Engineering CAD Code from Point Clouds(CAD-Recode:从点云逆向工程CAD代码)
[] 🤖 AntiLeak-Bench: Preventing Data Contamination by Automatically Constructing Benchmarks with Updated Real-World Knowledge(AntiLeak-Bench:通过自动构建基准测试防止数据污染)
[] 🤖 Alignment faking in large language models(大型语言模型中的对齐伪装)
[] ⚡ FastVLM: Efficient Vision Encoding for Vision Language Models(FastVLM:高效视觉编码在视觉语言模型中的应用)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 12 月 20 日 · 13 分钟
本期的 18 篇论文如下:
[] 🤖 TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks(TheAgentCompany:在具有重要现实意义的任务上对LLM代理进行基准测试)
[] 🎥 AniDoc: Animation Creation Made Easier(AniDoc:让动画制作更简单)
[] 👗 FashionComposer: Compositional Fashion Image Generation(时尚组合器:组合式时尚图像生成)
[] 🤖 Efficient Diffusion Transformer Policies with Mixture of Expert Denoisers for Multitask Learning(高效扩散Transformer策略与专家去噪混合模型在多任务学习中的应用)
[] 🌐 Prompting Depth Anything for 4K Resolution Accurate Metric Depth Estimation(提示深度任意模型用于4K分辨率精确度量深度估计)
[] 🔄 Mix-LN: Unleashing the Power of Deeper Layers by Combining Pre-LN and Post-LN(混合层归一化:通过结合预层归一化和后层归一化释放深层层的潜力)
[] 🤖 GUI Agents: A Survey(图形用户界面代理:综述)
[] 🌍 AnySat: An Earth Observation Model for Any Resolutions, Scales, and Modalities(AnySat:适用于任意分辨率、尺度和模态的地球观测模型)
[] 📊 RAG-RewardBench: Benchmarking Reward Models in Retrieval Augmented Generation for Preference Alignment(RAG-RewardBench:在检索增强生成中评估奖励模型以实现偏好对齐)
[] 🧠 LLaVA-UHD v2: an MLLM Integrating High-Resolution Feature Pyramid via Hierarchical Window Transformer(LLaVA-UHD v2:通过分层窗口Transformer集成高分辨率特征金字塔的多模态大语言模型)
[] 🤖 Learning from Massive Human Videos for Universal Humanoid Pose Control(从大规模人类视频中学习通用拟人姿态控制)
[] 🤖 ChatDiT: A Training-Free Baseline for Task-Agnostic Free-Form Chatting with Diffusion Transformers(ChatDiT:一种无需训练的任务无关自由形式聊天扩散变换器基线)
[] 🎥 VidTok: A Versatile and Open-Source Video Tokenizer(VidTok:一种多功能且开源的视频标记器)
[] 🧠 Thinking in Space: How Multimodal Large Language Models See, Remember, and Recall Spaces(空间思维:多模态大语言模型如何看、记和回忆空间)
[] 🔄 CAD-Recode: Reverse Engineering CAD Code from Point Clouds(CAD-Recode:从点云逆向工程CAD代码)
[] 🤖 AntiLeak-Bench: Preventing Data Contamination by Automatically Constructing Benchmarks with Updated Real-World Knowledge(AntiLeak-Bench:通过自动构建基准测试防止数据污染)
[] 🤖 Alignment faking in large language models(大型语言模型中的对齐伪装)
[] ⚡ FastVLM: Efficient Vision Encoding for Vision Language Models(FastVLM:高效视觉编码在视觉语言模型中的应用)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟