H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
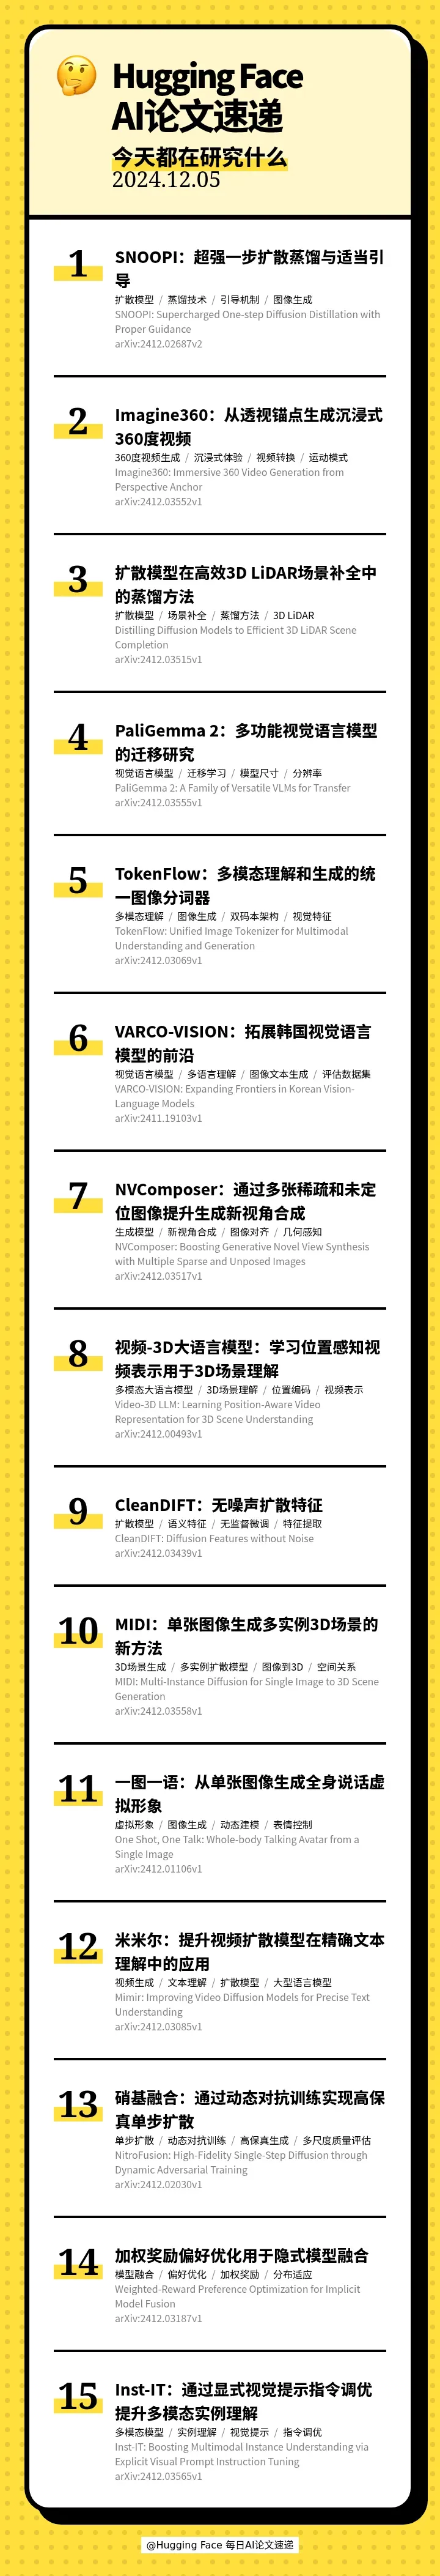
[] 🚀 SNOOPI: Supercharged One-step Diffusion Distillation with Proper Guidance(SNOOPI:超强一步扩散蒸馏与适当引导)
[] 🎥 Imagine360: Immersive 360 Video Generation from Perspective Anchor(Imagine360:从透视锚点生成沉浸式360度视频)
[] 🚗 Distilling Diffusion Models to Efficient 3D LiDAR Scene Completion(扩散模型在高效3D LiDAR场景补全中的蒸馏方法)
[] 🔄 PaliGemma 2: A Family of Versatile VLMs for Transfer(PaliGemma 2:多功能视觉语言模型的迁移研究)
[] 🌊 TokenFlow: Unified Image Tokenizer for Multimodal Understanding and Generation(TokenFlow:多模态理解和生成的统一图像分词器)
[] 🌐 VARCO-VISION: Expanding Frontiers in Korean Vision-Language Models(VARCO-VISION:拓展韩国视觉语言模型的前沿)
[] 🌐 NVComposer: Boosting Generative Novel View Synthesis with Multiple Sparse and Unposed Images(NVComposer:通过多张稀疏和未定位图像提升生成新视角合成)
[] 🎥 Video-3D LLM: Learning Position-Aware Video Representation for 3D Scene Understanding(视频-3D大语言模型:学习位置感知视频表示用于3D场景理解)
[] 🔍 CleanDIFT: Diffusion Features without Noise(CleanDIFT:无噪声扩散特征)
[] 🎨 MIDI: Multi-Instance Diffusion for Single Image to 3D Scene Generation(MIDI:单张图像生成多实例3D场景的新方法)
[] 🎥 One Shot, One Talk: Whole-body Talking Avatar from a Single Image(一图一语:从单张图像生成全身说话虚拟形象)
[] 📹 Mimir: Improving Video Diffusion Models for Precise Text Understanding(米米尔:提升视频扩散模型在精确文本理解中的应用)
[] 🎨 NitroFusion: High-Fidelity Single-Step Diffusion through Dynamic Adversarial Training(硝基融合:通过动态对抗训练实现高保真单步扩散)
[] 🧩 Weighted-Reward Preference Optimization for Implicit Model Fusion(加权奖励偏好优化用于隐式模型融合)
[] 🔍 Inst-IT: Boosting Multimodal Instance Understanding via Explicit Visual Prompt Instruction Tuning(Inst-IT:通过显式视觉提示指令调优提升多模态实例理解)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 12 月 6 日 · 11 分钟
本期的 15 篇论文如下:
[] 🚀 SNOOPI: Supercharged One-step Diffusion Distillation with Proper Guidance(SNOOPI:超强一步扩散蒸馏与适当引导)
[] 🎥 Imagine360: Immersive 360 Video Generation from Perspective Anchor(Imagine360:从透视锚点生成沉浸式360度视频)
[] 🚗 Distilling Diffusion Models to Efficient 3D LiDAR Scene Completion(扩散模型在高效3D LiDAR场景补全中的蒸馏方法)
[] 🔄 PaliGemma 2: A Family of Versatile VLMs for Transfer(PaliGemma 2:多功能视觉语言模型的迁移研究)
[] 🌊 TokenFlow: Unified Image Tokenizer for Multimodal Understanding and Generation(TokenFlow:多模态理解和生成的统一图像分词器)
[] 🌐 VARCO-VISION: Expanding Frontiers in Korean Vision-Language Models(VARCO-VISION:拓展韩国视觉语言模型的前沿)
[] 🌐 NVComposer: Boosting Generative Novel View Synthesis with Multiple Sparse and Unposed Images(NVComposer:通过多张稀疏和未定位图像提升生成新视角合成)
[] 🎥 Video-3D LLM: Learning Position-Aware Video Representation for 3D Scene Understanding(视频-3D大语言模型:学习位置感知视频表示用于3D场景理解)
[] 🔍 CleanDIFT: Diffusion Features without Noise(CleanDIFT:无噪声扩散特征)
[] 🎨 MIDI: Multi-Instance Diffusion for Single Image to 3D Scene Generation(MIDI:单张图像生成多实例3D场景的新方法)
[] 🎥 One Shot, One Talk: Whole-body Talking Avatar from a Single Image(一图一语:从单张图像生成全身说话虚拟形象)
[] 📹 Mimir: Improving Video Diffusion Models for Precise Text Understanding(米米尔:提升视频扩散模型在精确文本理解中的应用)
[] 🎨 NitroFusion: High-Fidelity Single-Step Diffusion through Dynamic Adversarial Training(硝基融合:通过动态对抗训练实现高保真单步扩散)
[] 🧩 Weighted-Reward Preference Optimization for Implicit Model Fusion(加权奖励偏好优化用于隐式模型融合)
[] 🔍 Inst-IT: Boosting Multimodal Instance Understanding via Explicit Visual Prompt Instruction Tuning(Inst-IT:通过显式视觉提示指令调优提升多模态实例理解)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟