H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

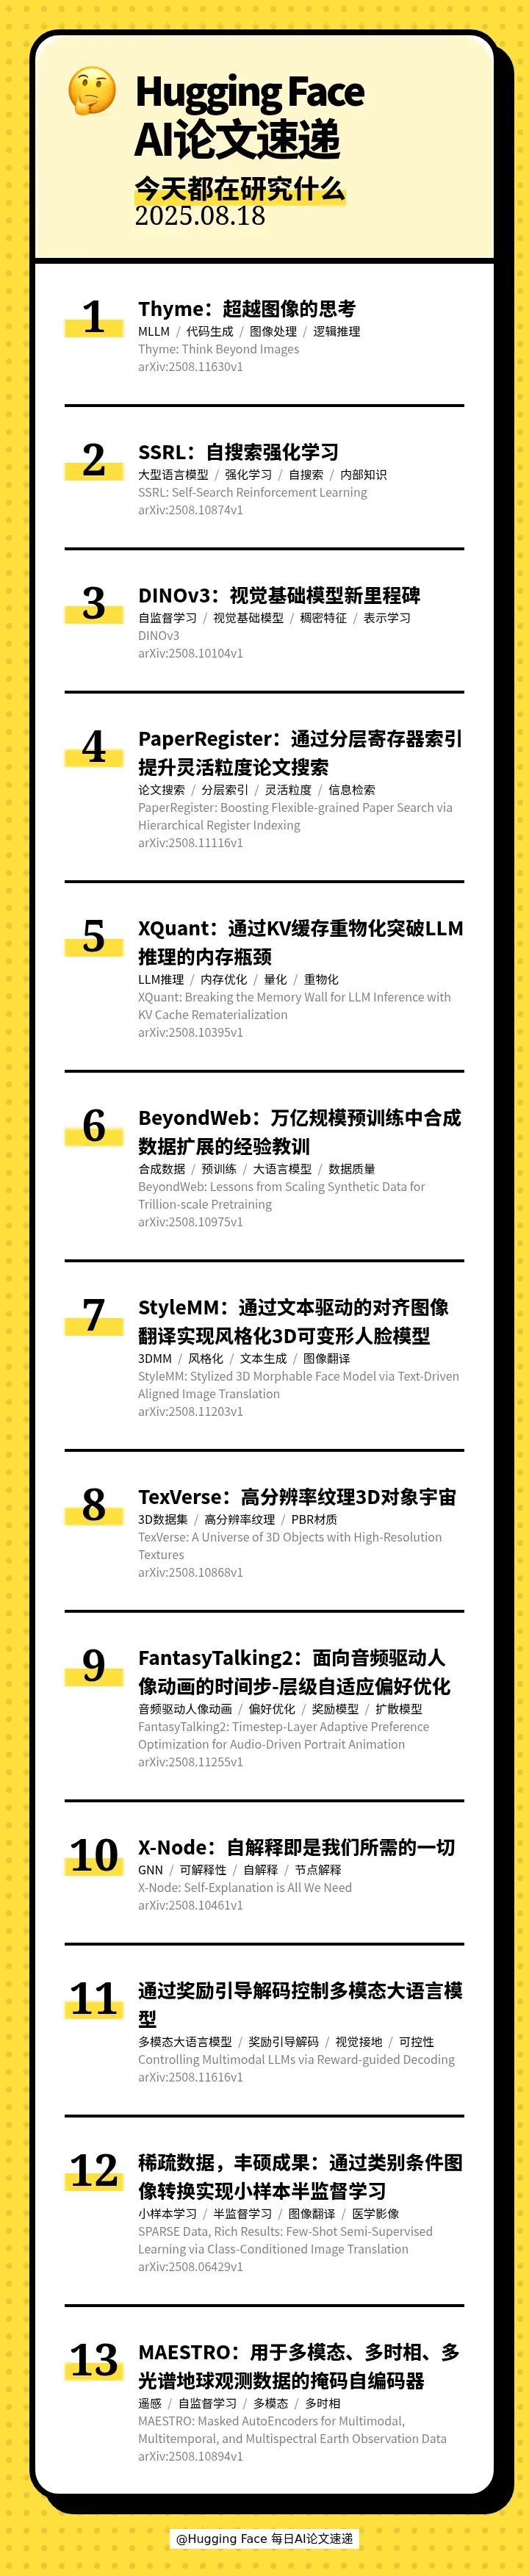
本期的 13 篇论文如下:
[] 💡 Thyme: Think Beyond Images(Thyme:超越图像的思考)
[] 🧠 SSRL: Self-Search Reinforcement Learning(SSRL:自搜索强化学习)
[] 🚀 DINOv3(DINOv3:视觉基础模型新里程碑)
[] 🔍 PaperRegister: Boosting Flexible-grained Paper Search via Hierarchical Register Indexing(PaperRegister:通过分层寄存器索引提升灵活粒度论文搜索)
[] 🚀 XQuant: Breaking the Memory Wall for LLM Inference with KV Cache Rematerialization(XQuant:通过KV缓存重物化突破LLM推理的内存瓶颈)
[] 🚀 BeyondWeb: Lessons from Scaling Synthetic Data for Trillion-scale Pretraining(BeyondWeb:万亿规模预训练中合成数据扩展的经验教训)
[] 🎨 StyleMM: Stylized 3D Morphable Face Model via Text-Driven Aligned Image Translation(StyleMM:通过文本驱动的对齐图像翻译实现风格化3D可变形人脸模型)
[] 🌌 TexVerse: A Universe of 3D Objects with High-Resolution Textures(TexVerse:高分辨率纹理3D对象宇宙)
[] 🗣 FantasyTalking2: Timestep-Layer Adaptive Preference Optimization for Audio-Driven Portrait Animation(FantasyTalking2:面向音频驱动人像动画的时间步-层级自适应偏好优化)
[] 💡 X-Node: Self-Explanation is All We Need(X-Node:自解释即是我们所需的一切)
[] ⚙ Controlling Multimodal LLMs via Reward-guided Decoding(通过奖励引导解码控制多模态大语言模型)
[] ✨ SPARSE Data, Rich Results: Few-Shot Semi-Supervised Learning via Class-Conditioned Image Translation(稀疏数据,丰硕成果:通过类别条件图像转换实现小样本半监督学习)
[] 🌍 MAESTRO: Masked AutoEncoders for Multimodal, Multitemporal, and Multispectral Earth Observation Data(MAESTRO:用于多模态、多时相、多光谱地球观测数据的掩码自编码器)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 8 月 19 日 · 7 分钟
本期的 13 篇论文如下:
[] 💡 Thyme: Think Beyond Images(Thyme:超越图像的思考)
[] 🧠 SSRL: Self-Search Reinforcement Learning(SSRL:自搜索强化学习)
[] 🚀 DINOv3(DINOv3:视觉基础模型新里程碑)
[] 🔍 PaperRegister: Boosting Flexible-grained Paper Search via Hierarchical Register Indexing(PaperRegister:通过分层寄存器索引提升灵活粒度论文搜索)
[] 🚀 XQuant: Breaking the Memory Wall for LLM Inference with KV Cache Rematerialization(XQuant:通过KV缓存重物化突破LLM推理的内存瓶颈)
[] 🚀 BeyondWeb: Lessons from Scaling Synthetic Data for Trillion-scale Pretraining(BeyondWeb:万亿规模预训练中合成数据扩展的经验教训)
[] 🎨 StyleMM: Stylized 3D Morphable Face Model via Text-Driven Aligned Image Translation(StyleMM:通过文本驱动的对齐图像翻译实现风格化3D可变形人脸模型)
[] 🌌 TexVerse: A Universe of 3D Objects with High-Resolution Textures(TexVerse:高分辨率纹理3D对象宇宙)
[] 🗣 FantasyTalking2: Timestep-Layer Adaptive Preference Optimization for Audio-Driven Portrait Animation(FantasyTalking2:面向音频驱动人像动画的时间步-层级自适应偏好优化)
[] 💡 X-Node: Self-Explanation is All We Need(X-Node:自解释即是我们所需的一切)
[] ⚙ Controlling Multimodal LLMs via Reward-guided Decoding(通过奖励引导解码控制多模态大语言模型)
[] ✨ SPARSE Data, Rich Results: Few-Shot Semi-Supervised Learning via Class-Conditioned Image Translation(稀疏数据,丰硕成果:通过类别条件图像转换实现小样本半监督学习)
[] 🌍 MAESTRO: Masked AutoEncoders for Multimodal, Multitemporal, and Multispectral Earth Observation Data(MAESTRO:用于多模态、多时相、多光谱地球观测数据的掩码自编码器)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟