H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

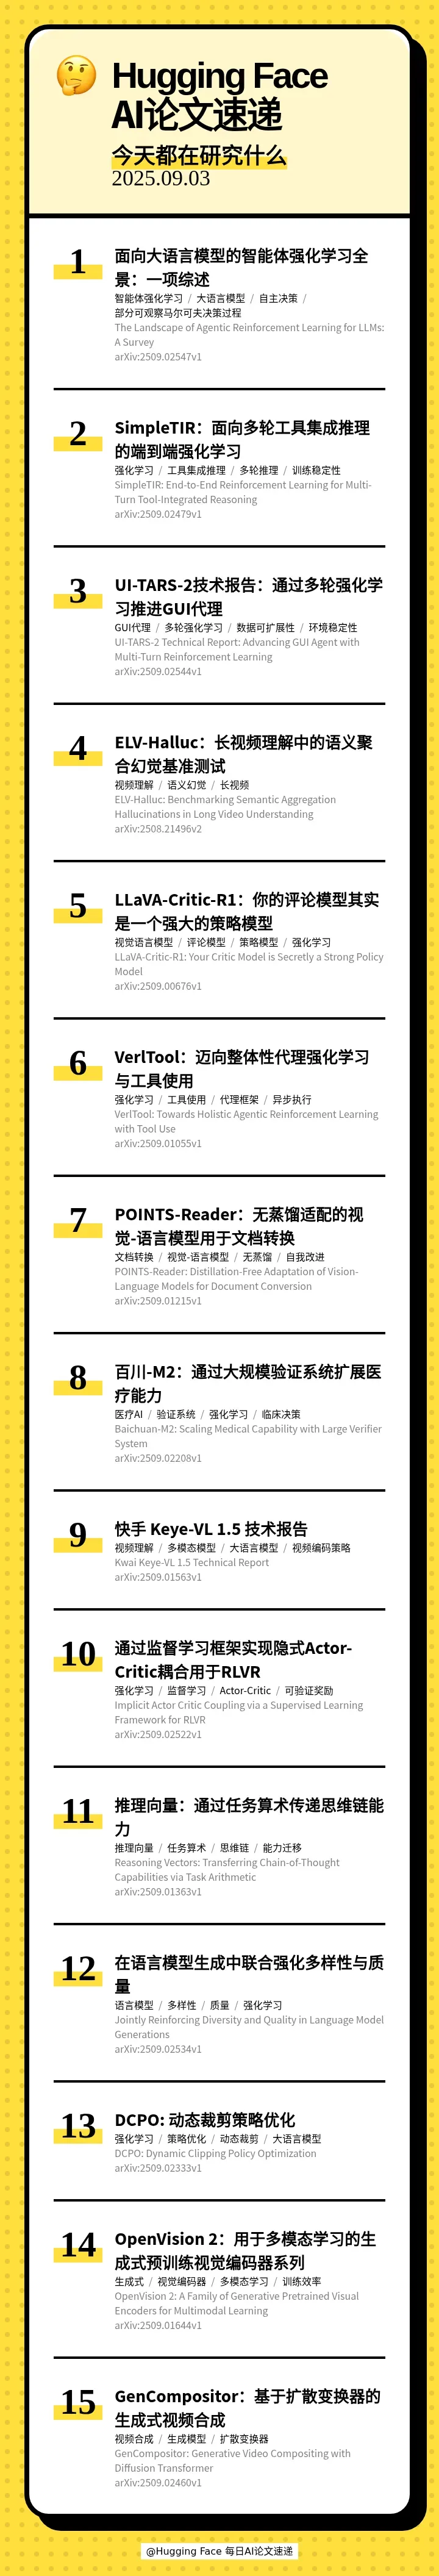
本期的 15 篇论文如下:
[] 🤖 The Landscape of Agentic Reinforcement Learning for LLMs: A Survey(面向大语言模型的智能体强化学习全景:一项综述)
[] 🚀 SimpleTIR: End-to-End Reinforcement Learning for Multi-Turn Tool-Integrated Reasoning(SimpleTIR:面向多轮工具集成推理的端到端强化学习)
[] 🤖 UI-TARS-2 Technical Report: Advancing GUI Agent with Multi-Turn Reinforcement Learning(UI-TARS-2技术报告:通过多轮强化学习推进GUI代理)
[] 🎥 ELV-Halluc: Benchmarking Semantic Aggregation Hallucinations in Long Video Understanding(ELV-Halluc:长视频理解中的语义聚合幻觉基准测试)
[] 🔄 LLaVA-Critic-R1: Your Critic Model is Secretly a Strong Policy Model(LLaVA-Critic-R1:你的评论模型其实是一个强大的策略模型)
[] 🔧 VerlTool: Towards Holistic Agentic Reinforcement Learning with Tool Use(VerlTool:迈向整体性代理强化学习与工具使用)
[] 📄 POINTS-Reader: Distillation-Free Adaptation of Vision-Language Models for Document Conversion(POINTS-Reader:无蒸馏适配的视觉-语言模型用于文档转换)
[] 🩺 Baichuan-M2: Scaling Medical Capability with Large Verifier System(百川-M2:通过大规模验证系统扩展医疗能力)
[] 🎥 Kwai Keye-VL 1.5 Technical Report(快手 Keye-VL 1.5 技术报告)
[] 🤖 Implicit Actor Critic Coupling via a Supervised Learning Framework for RLVR(通过监督学习框架实现隐式Actor-Critic耦合用于RLVR)
[] 🧠 Reasoning Vectors: Transferring Chain-of-Thought Capabilities via Task Arithmetic(推理向量:通过任务算术传递思维链能力)
[] 🔄 Jointly Reinforcing Diversity and Quality in Language Model Generations(在语言模型生成中联合强化多样性与质量)
[] 🚀 DCPO: Dynamic Clipping Policy Optimization(DCPO: 动态裁剪策略优化)
[] 🚀 OpenVision 2: A Family of Generative Pretrained Visual Encoders for Multimodal Learning(OpenVision 2:用于多模态学习的生成式预训练视觉编码器系列)
[] 🎬 GenCompositor: Generative Video Compositing with Diffusion Transformer(GenCompositor:基于扩散变换器的生成式视频合成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 9 月 4 日 · 7 分钟
本期的 15 篇论文如下:
[] 🤖 The Landscape of Agentic Reinforcement Learning for LLMs: A Survey(面向大语言模型的智能体强化学习全景:一项综述)
[] 🚀 SimpleTIR: End-to-End Reinforcement Learning for Multi-Turn Tool-Integrated Reasoning(SimpleTIR:面向多轮工具集成推理的端到端强化学习)
[] 🤖 UI-TARS-2 Technical Report: Advancing GUI Agent with Multi-Turn Reinforcement Learning(UI-TARS-2技术报告:通过多轮强化学习推进GUI代理)
[] 🎥 ELV-Halluc: Benchmarking Semantic Aggregation Hallucinations in Long Video Understanding(ELV-Halluc:长视频理解中的语义聚合幻觉基准测试)
[] 🔄 LLaVA-Critic-R1: Your Critic Model is Secretly a Strong Policy Model(LLaVA-Critic-R1:你的评论模型其实是一个强大的策略模型)
[] 🔧 VerlTool: Towards Holistic Agentic Reinforcement Learning with Tool Use(VerlTool:迈向整体性代理强化学习与工具使用)
[] 📄 POINTS-Reader: Distillation-Free Adaptation of Vision-Language Models for Document Conversion(POINTS-Reader:无蒸馏适配的视觉-语言模型用于文档转换)
[] 🩺 Baichuan-M2: Scaling Medical Capability with Large Verifier System(百川-M2:通过大规模验证系统扩展医疗能力)
[] 🎥 Kwai Keye-VL 1.5 Technical Report(快手 Keye-VL 1.5 技术报告)
[] 🤖 Implicit Actor Critic Coupling via a Supervised Learning Framework for RLVR(通过监督学习框架实现隐式Actor-Critic耦合用于RLVR)
[] 🧠 Reasoning Vectors: Transferring Chain-of-Thought Capabilities via Task Arithmetic(推理向量:通过任务算术传递思维链能力)
[] 🔄 Jointly Reinforcing Diversity and Quality in Language Model Generations(在语言模型生成中联合强化多样性与质量)
[] 🚀 DCPO: Dynamic Clipping Policy Optimization(DCPO: 动态裁剪策略优化)
[] 🚀 OpenVision 2: A Family of Generative Pretrained Visual Encoders for Multimodal Learning(OpenVision 2:用于多模态学习的生成式预训练视觉编码器系列)
[] 🎬 GenCompositor: Generative Video Compositing with Diffusion Transformer(GenCompositor:基于扩散变换器的生成式视频合成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟