H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

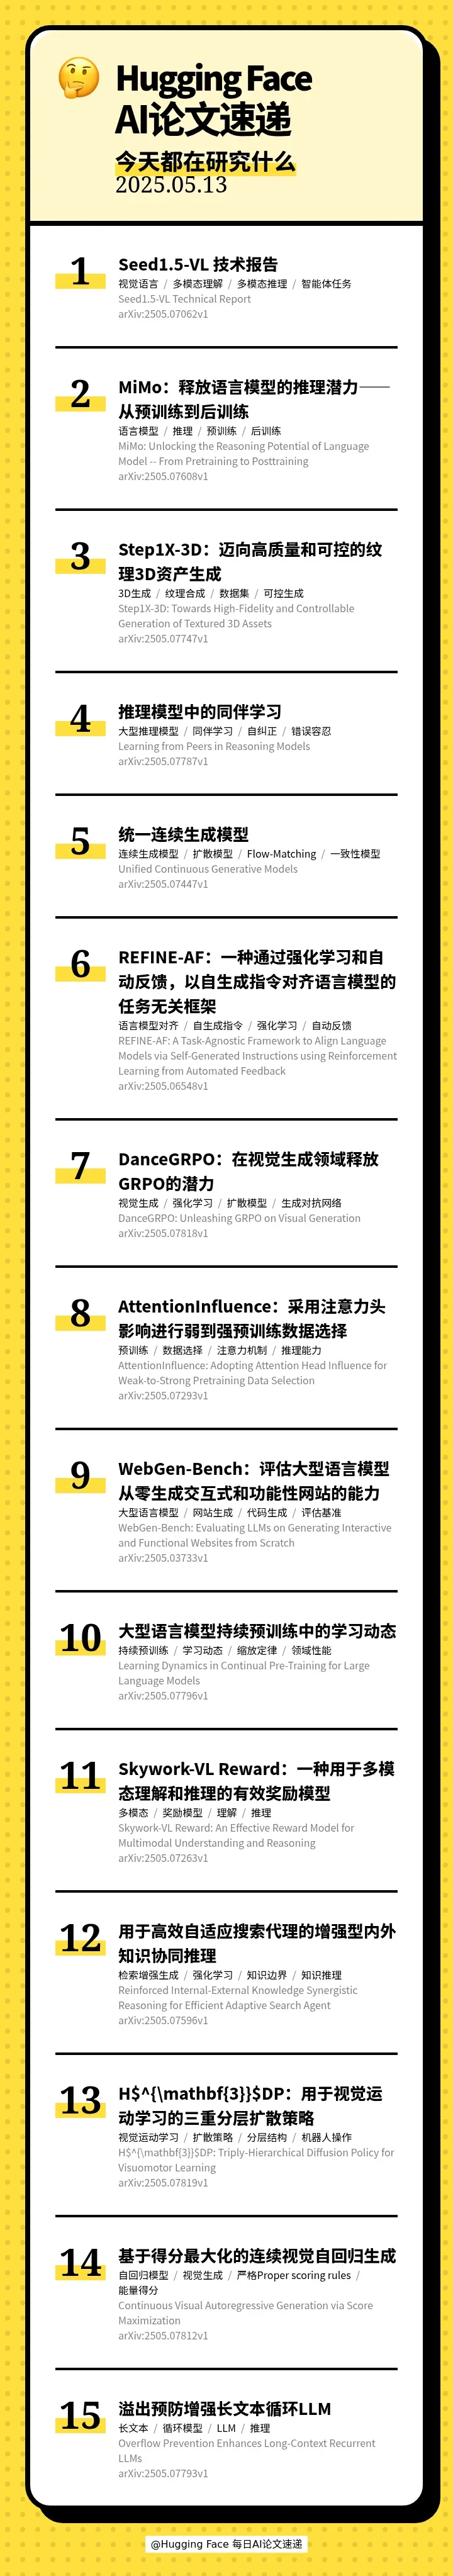
本期的 15 篇论文如下:
[] 💡 Seed1.5-VL Technical Report(Seed1.5-VL 技术报告)
[] 🧠 MiMo: Unlocking the Reasoning Potential of Language Model -- From Pretraining to Posttraining(MiMo:释放语言模型的推理潜力——从预训练到后训练)
[] 🖼 Step1X-3D: Towards High-Fidelity and Controllable Generation of Textured 3D Assets(Step1X-3D:迈向高质量和可控的纹理3D资产生成)
[] 🤝 Learning from Peers in Reasoning Models(推理模型中的同伴学习)
[] 🎨 Unified Continuous Generative Models(统一连续生成模型)
[] 🤖 REFINE-AF: A Task-Agnostic Framework to Align Language Models via Self-Generated Instructions using Reinforcement Learning from Automated Feedback(REFINE-AF:一种通过强化学习和自动反馈,以自生成指令对齐语言模型的任务无关框架)
[] 💃 DanceGRPO: Unleashing GRPO on Visual Generation(DanceGRPO:在视觉生成领域释放GRPO的潜力)
[] 🧠 AttentionInfluence: Adopting Attention Head Influence for Weak-to-Strong Pretraining Data Selection(AttentionInfluence:采用注意力头影响进行弱到强预训练数据选择)
[] 🌐 WebGen-Bench: Evaluating LLMs on Generating Interactive and Functional Websites from Scratch(WebGen-Bench:评估大型语言模型从零生成交互式和功能性网站的能力)
[] 📈 Learning Dynamics in Continual Pre-Training for Large Language Models(大型语言模型持续预训练中的学习动态)
[] 🏆 Skywork-VL Reward: An Effective Reward Model for Multimodal Understanding and Reasoning(Skywork-VL Reward:一种用于多模态理解和推理的有效奖励模型)
[] 🧠 Reinforced Internal-External Knowledge Synergistic Reasoning for Efficient Adaptive Search Agent(用于高效自适应搜索代理的增强型内外知识协同推理)
[] 🤖 H$^{\mathbf{3}}$DP: Triply-Hierarchical Diffusion Policy for Visuomotor Learning(H$^{\mathbf{3}}$DP:用于视觉运动学习的三重分层扩散策略)
[] 🎨 Continuous Visual Autoregressive Generation via Score Maximization(基于得分最大化的连续视觉自回归生成)
[] 🧠 Overflow Prevention Enhances Long-Context Recurrent LLMs(溢出预防增强长文本循环LLM)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 5 月 14 日 · 12 分钟
本期的 15 篇论文如下:
[] 💡 Seed1.5-VL Technical Report(Seed1.5-VL 技术报告)
[] 🧠 MiMo: Unlocking the Reasoning Potential of Language Model -- From Pretraining to Posttraining(MiMo:释放语言模型的推理潜力——从预训练到后训练)
[] 🖼 Step1X-3D: Towards High-Fidelity and Controllable Generation of Textured 3D Assets(Step1X-3D:迈向高质量和可控的纹理3D资产生成)
[] 🤝 Learning from Peers in Reasoning Models(推理模型中的同伴学习)
[] 🎨 Unified Continuous Generative Models(统一连续生成模型)
[] 🤖 REFINE-AF: A Task-Agnostic Framework to Align Language Models via Self-Generated Instructions using Reinforcement Learning from Automated Feedback(REFINE-AF:一种通过强化学习和自动反馈,以自生成指令对齐语言模型的任务无关框架)
[] 💃 DanceGRPO: Unleashing GRPO on Visual Generation(DanceGRPO:在视觉生成领域释放GRPO的潜力)
[] 🧠 AttentionInfluence: Adopting Attention Head Influence for Weak-to-Strong Pretraining Data Selection(AttentionInfluence:采用注意力头影响进行弱到强预训练数据选择)
[] 🌐 WebGen-Bench: Evaluating LLMs on Generating Interactive and Functional Websites from Scratch(WebGen-Bench:评估大型语言模型从零生成交互式和功能性网站的能力)
[] 📈 Learning Dynamics in Continual Pre-Training for Large Language Models(大型语言模型持续预训练中的学习动态)
[] 🏆 Skywork-VL Reward: An Effective Reward Model for Multimodal Understanding and Reasoning(Skywork-VL Reward:一种用于多模态理解和推理的有效奖励模型)
[] 🧠 Reinforced Internal-External Knowledge Synergistic Reasoning for Efficient Adaptive Search Agent(用于高效自适应搜索代理的增强型内外知识协同推理)
[] 🤖 H$^{\mathbf{3}}$DP: Triply-Hierarchical Diffusion Policy for Visuomotor Learning(H$^{\mathbf{3}}$DP:用于视觉运动学习的三重分层扩散策略)
[] 🎨 Continuous Visual Autoregressive Generation via Score Maximization(基于得分最大化的连续视觉自回归生成)
[] 🧠 Overflow Prevention Enhances Long-Context Recurrent LLMs(溢出预防增强长文本循环LLM)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟