H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

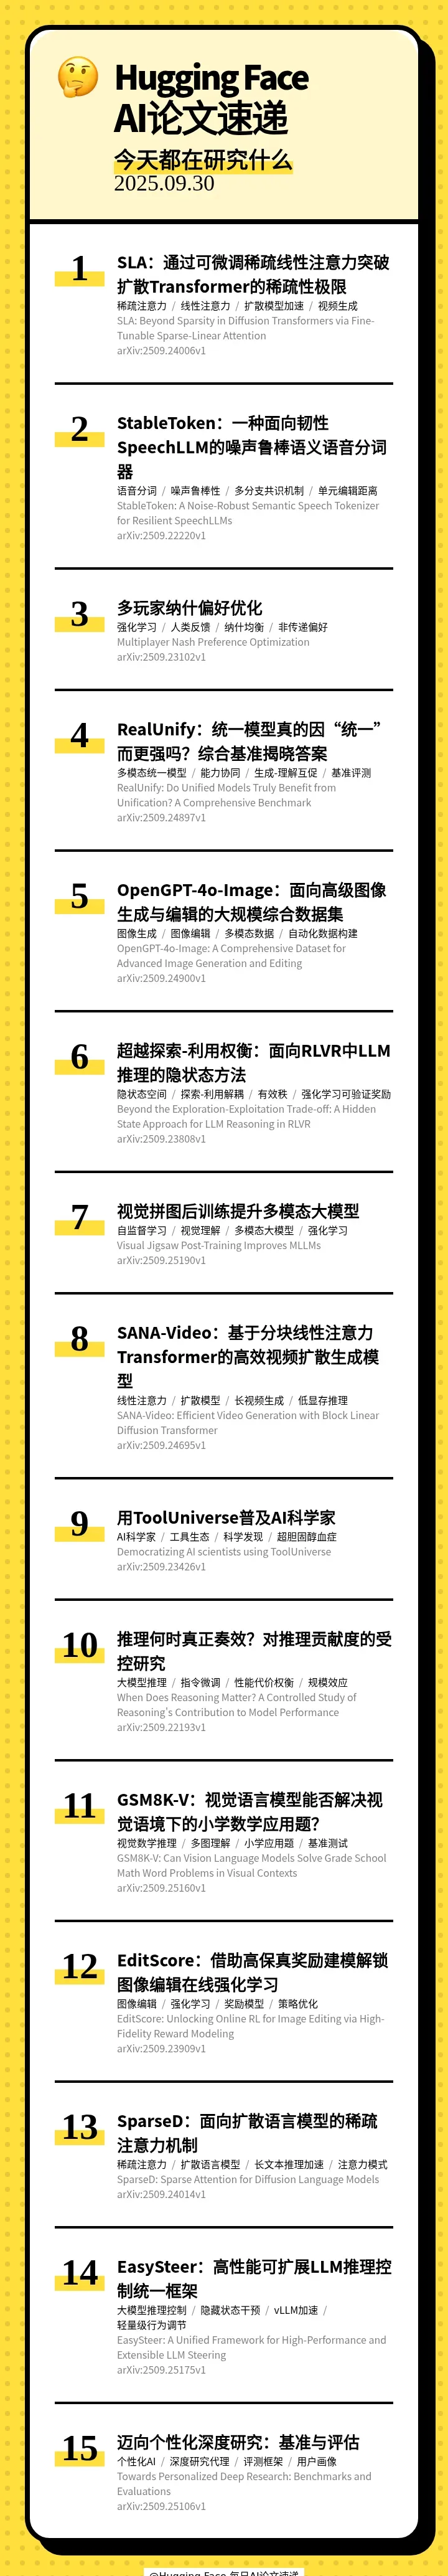
本期的 15 篇论文如下:
[] ⚡ SLA: Beyond Sparsity in Diffusion Transformers via Fine-Tunable Sparse-Linear Attention(SLA:通过可微调稀疏线性注意力突破扩散Transformer的稀疏性极限)
[] 🗣 StableToken: A Noise-Robust Semantic Speech Tokenizer for Resilient SpeechLLMs(StableToken:一种面向韧性SpeechLLM的噪声鲁棒语义语音分词器)
[] 🎮 Multiplayer Nash Preference Optimization(多玩家纳什偏好优化)
[] 🔗 RealUnify: Do Unified Models Truly Benefit from Unification? A Comprehensive Benchmark(RealUnify:统一模型真的因“统一”而更强吗?综合基准揭晓答案)
[] 🎨 OpenGPT-4o-Image: A Comprehensive Dataset for Advanced Image Generation and Editing(OpenGPT-4o-Image:面向高级图像生成与编辑的大规模综合数据集)
[] 🧠 Beyond the Exploration-Exploitation Trade-off: A Hidden State Approach for LLM Reasoning in RLVR(超越探索-利用权衡:面向RLVR中LLM推理的隐状态方法)
[] 🧩 Visual Jigsaw Post-Training Improves MLLMs(视觉拼图后训练提升多模态大模型)
[] 🎬 SANA-Video: Efficient Video Generation with Block Linear Diffusion Transformer(SANA-Video:基于分块线性注意力Transformer的高效视频扩散生成模型)
[] 🔬 Democratizing AI scientists using ToolUniverse(用ToolUniverse普及AI科学家)
[] 🧠 When Does Reasoning Matter? A Controlled Study of Reasoning's Contribution to Model Performance(推理何时真正奏效?对推理贡献度的受控研究)
[] 📊 GSM8K-V: Can Vision Language Models Solve Grade School Math Word Problems in Visual Contexts(GSM8K-V:视觉语言模型能否解决视觉语境下的小学数学应用题?)
[] 🖼 EditScore: Unlocking Online RL for Image Editing via High-Fidelity Reward Modeling(EditScore:借助高保真奖励建模解锁图像编辑在线强化学习)
[] 🚀 SparseD: Sparse Attention for Diffusion Language Models(SparseD:面向扩散语言模型的稀疏注意力机制)
[] 🎛 EasySteer: A Unified Framework for High-Performance and Extensible LLM Steering(EasySteer:高性能可扩展LLM推理控制统一框架)
[] 🧠 Towards Personalized Deep Research: Benchmarks and Evaluations(迈向个性化深度研究:基准与评估)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 1 日 · 12 分钟
本期的 15 篇论文如下:
[] ⚡ SLA: Beyond Sparsity in Diffusion Transformers via Fine-Tunable Sparse-Linear Attention(SLA:通过可微调稀疏线性注意力突破扩散Transformer的稀疏性极限)
[] 🗣 StableToken: A Noise-Robust Semantic Speech Tokenizer for Resilient SpeechLLMs(StableToken:一种面向韧性SpeechLLM的噪声鲁棒语义语音分词器)
[] 🎮 Multiplayer Nash Preference Optimization(多玩家纳什偏好优化)
[] 🔗 RealUnify: Do Unified Models Truly Benefit from Unification? A Comprehensive Benchmark(RealUnify:统一模型真的因“统一”而更强吗?综合基准揭晓答案)
[] 🎨 OpenGPT-4o-Image: A Comprehensive Dataset for Advanced Image Generation and Editing(OpenGPT-4o-Image:面向高级图像生成与编辑的大规模综合数据集)
[] 🧠 Beyond the Exploration-Exploitation Trade-off: A Hidden State Approach for LLM Reasoning in RLVR(超越探索-利用权衡:面向RLVR中LLM推理的隐状态方法)
[] 🧩 Visual Jigsaw Post-Training Improves MLLMs(视觉拼图后训练提升多模态大模型)
[] 🎬 SANA-Video: Efficient Video Generation with Block Linear Diffusion Transformer(SANA-Video:基于分块线性注意力Transformer的高效视频扩散生成模型)
[] 🔬 Democratizing AI scientists using ToolUniverse(用ToolUniverse普及AI科学家)
[] 🧠 When Does Reasoning Matter? A Controlled Study of Reasoning's Contribution to Model Performance(推理何时真正奏效?对推理贡献度的受控研究)
[] 📊 GSM8K-V: Can Vision Language Models Solve Grade School Math Word Problems in Visual Contexts(GSM8K-V:视觉语言模型能否解决视觉语境下的小学数学应用题?)
[] 🖼 EditScore: Unlocking Online RL for Image Editing via High-Fidelity Reward Modeling(EditScore:借助高保真奖励建模解锁图像编辑在线强化学习)
[] 🚀 SparseD: Sparse Attention for Diffusion Language Models(SparseD:面向扩散语言模型的稀疏注意力机制)
[] 🎛 EasySteer: A Unified Framework for High-Performance and Extensible LLM Steering(EasySteer:高性能可扩展LLM推理控制统一框架)
[] 🧠 Towards Personalized Deep Research: Benchmarks and Evaluations(迈向个性化深度研究:基准与评估)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟