H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

【赞助商】
通勤路上就听AI每周谈。AI每周谈,每周带你回顾上周AI大事
传送门 🔗https://www.xiaoyuzhoufm.com/podcast/688a34636f5a275f1cba40fd
【目录】
本期的 15 篇论文如下:
[] 🧪 Omni-WorldBench: Towards a Comprehensive Interaction-Centric Evaluation for World Models(Omni-WorldBench:迈向面向世界模型的全面交互中心化评估)
[] 🚀 Speed by Simplicity: A Single-Stream Architecture for Fast Audio-Video Generative Foundation Model(速度源于简洁:用于快速音视频生成基础模型的单流架构)
[] 🧠 LongCat-Flash-Prover: Advancing Native Formal Reasoning via Agentic Tool-Integrated Reinforcement Learning(LongCat-Flash-Prover:通过智能体工具集成强化学习推进原生形式推理)
[] 🔍 VideoDetective: Clue Hunting via both Extrinsic Query and Intrinsic Relevance for Long Video Understanding(VideoDetective:基于外部查询与内部相关性的线索搜寻用于长视频理解)
[] 🧠 SpatialBoost: Enhancing Visual Representation through Language-Guided Reasoning(SpatialBoost:通过语言引导推理增强视觉表征)
[] 🎯 F4Splat: Feed-Forward Predictive Densification for Feed-Forward 3D Gaussian Splatting(F4Splat:用于前馈3D高斯泼溅的前馈预测性致密化)
[] 🎬 Manifold-Aware Exploration for Reinforcement Learning in Video Generation(面向视频生成的强化学习中的流形感知探索)
[] ⚖ mSFT: Addressing Dataset Mixtures Overfiting Heterogeneously in Multi-task SFT(mSFT:解决多任务监督微调中数据集混合的异质过拟合问题)
[] 🧠 Group3D: MLLM-Driven Semantic Grouping for Open-Vocabulary 3D Object Detection(Group3D:基于多模态大语言模型的语义分组开放词汇3D物体检测)
[] 🔄 Repurposing Geometric Foundation Models for Multi-view Diffusion(几何基础模型在多视角扩散中的再利用)
[] 🤖 RoboAlign: Learning Test-Time Reasoning for Language-Action Alignment in Vision-Language-Action Models(RoboAlign:学习视觉-语言-动作模型中语言-动作对齐的测试时推理)
[] 🔍 OpenResearcher: A Fully Open Pipeline for Long-Horizon Deep Research Trajectory Synthesis(OpenResearcher:一个完全开源的深度研究长程轨迹合成流程)
[] 💭 BubbleRAG: Evidence-Driven Retrieval-Augmented Generation for Black-Box Knowledge Graphs(BubbleRAG:面向黑盒知识图谱的证据驱动检索增强生成)
[] ⚖ SEM: Sparse Embedding Modulation for Post-Hoc Debiasing of Vision-Language Models(SEM:用于视觉语言模型事后去偏的稀疏嵌入调制)
[] 🧭 On the Direction of RLVR Updates for LLM Reasoning: Identification and Exploitation(论RLVR更新方向对LLM推理的影响:识别与利用)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 3 月 25 日 · 13 分钟
【赞助商】
通勤路上就听AI每周谈。AI每周谈,每周带你回顾上周AI大事
传送门 🔗https://www.xiaoyuzhoufm.com/podcast/688a34636f5a275f1cba40fd
【目录】
本期的 15 篇论文如下:
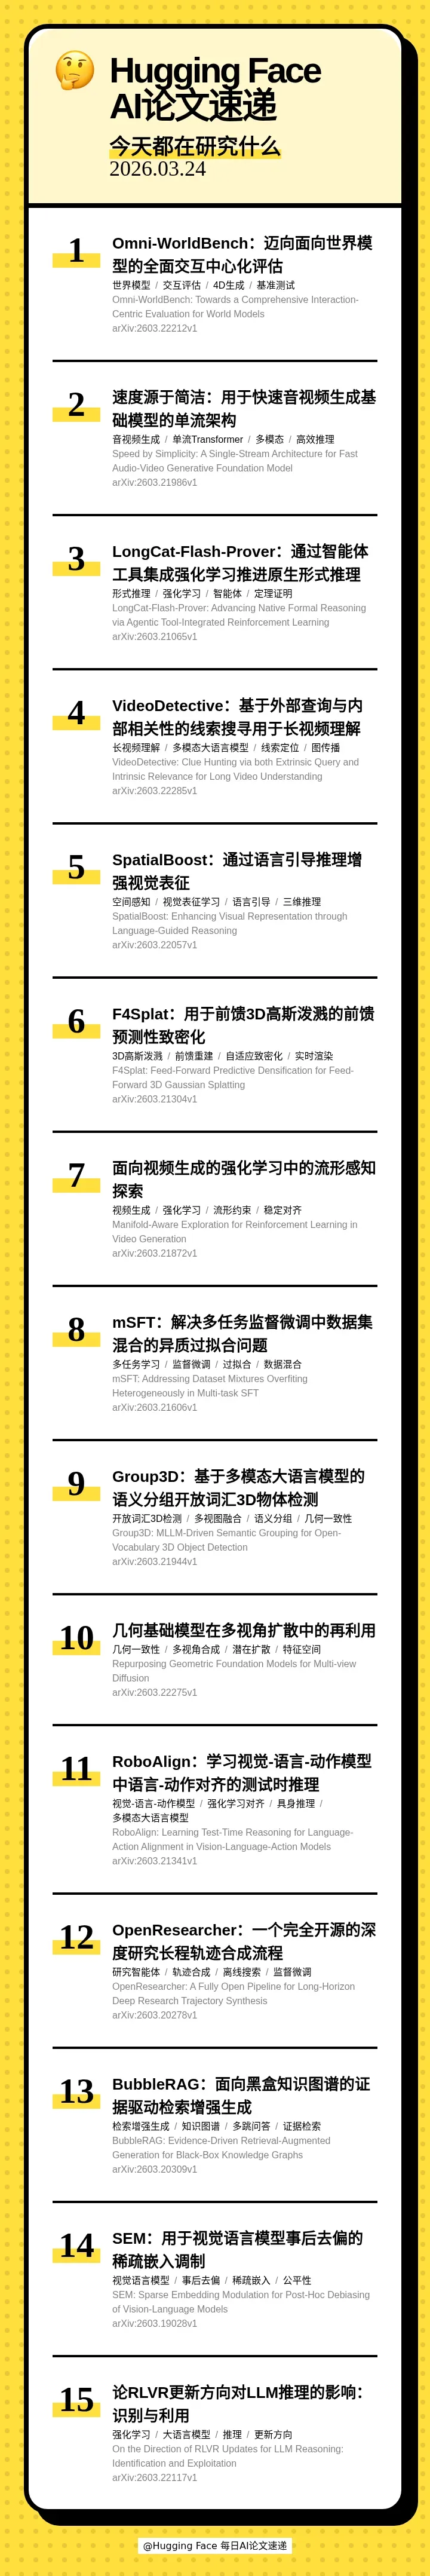
[] 🧪 Omni-WorldBench: Towards a Comprehensive Interaction-Centric Evaluation for World Models(Omni-WorldBench:迈向面向世界模型的全面交互中心化评估)
[] 🚀 Speed by Simplicity: A Single-Stream Architecture for Fast Audio-Video Generative Foundation Model(速度源于简洁:用于快速音视频生成基础模型的单流架构)
[] 🧠 LongCat-Flash-Prover: Advancing Native Formal Reasoning via Agentic Tool-Integrated Reinforcement Learning(LongCat-Flash-Prover:通过智能体工具集成强化学习推进原生形式推理)
[] 🔍 VideoDetective: Clue Hunting via both Extrinsic Query and Intrinsic Relevance for Long Video Understanding(VideoDetective:基于外部查询与内部相关性的线索搜寻用于长视频理解)
[] 🧠 SpatialBoost: Enhancing Visual Representation through Language-Guided Reasoning(SpatialBoost:通过语言引导推理增强视觉表征)
[] 🎯 F4Splat: Feed-Forward Predictive Densification for Feed-Forward 3D Gaussian Splatting(F4Splat:用于前馈3D高斯泼溅的前馈预测性致密化)
[] 🎬 Manifold-Aware Exploration for Reinforcement Learning in Video Generation(面向视频生成的强化学习中的流形感知探索)
[] ⚖ mSFT: Addressing Dataset Mixtures Overfiting Heterogeneously in Multi-task SFT(mSFT:解决多任务监督微调中数据集混合的异质过拟合问题)
[] 🧠 Group3D: MLLM-Driven Semantic Grouping for Open-Vocabulary 3D Object Detection(Group3D:基于多模态大语言模型的语义分组开放词汇3D物体检测)
[] 🔄 Repurposing Geometric Foundation Models for Multi-view Diffusion(几何基础模型在多视角扩散中的再利用)
[] 🤖 RoboAlign: Learning Test-Time Reasoning for Language-Action Alignment in Vision-Language-Action Models(RoboAlign:学习视觉-语言-动作模型中语言-动作对齐的测试时推理)
[] 🔍 OpenResearcher: A Fully Open Pipeline for Long-Horizon Deep Research Trajectory Synthesis(OpenResearcher:一个完全开源的深度研究长程轨迹合成流程)
[] 💭 BubbleRAG: Evidence-Driven Retrieval-Augmented Generation for Black-Box Knowledge Graphs(BubbleRAG:面向黑盒知识图谱的证据驱动检索增强生成)
[] ⚖ SEM: Sparse Embedding Modulation for Post-Hoc Debiasing of Vision-Language Models(SEM:用于视觉语言模型事后去偏的稀疏嵌入调制)
[] 🧭 On the Direction of RLVR Updates for LLM Reasoning: Identification and Exploitation(论RLVR更新方向对LLM推理的影响:识别与利用)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟