H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
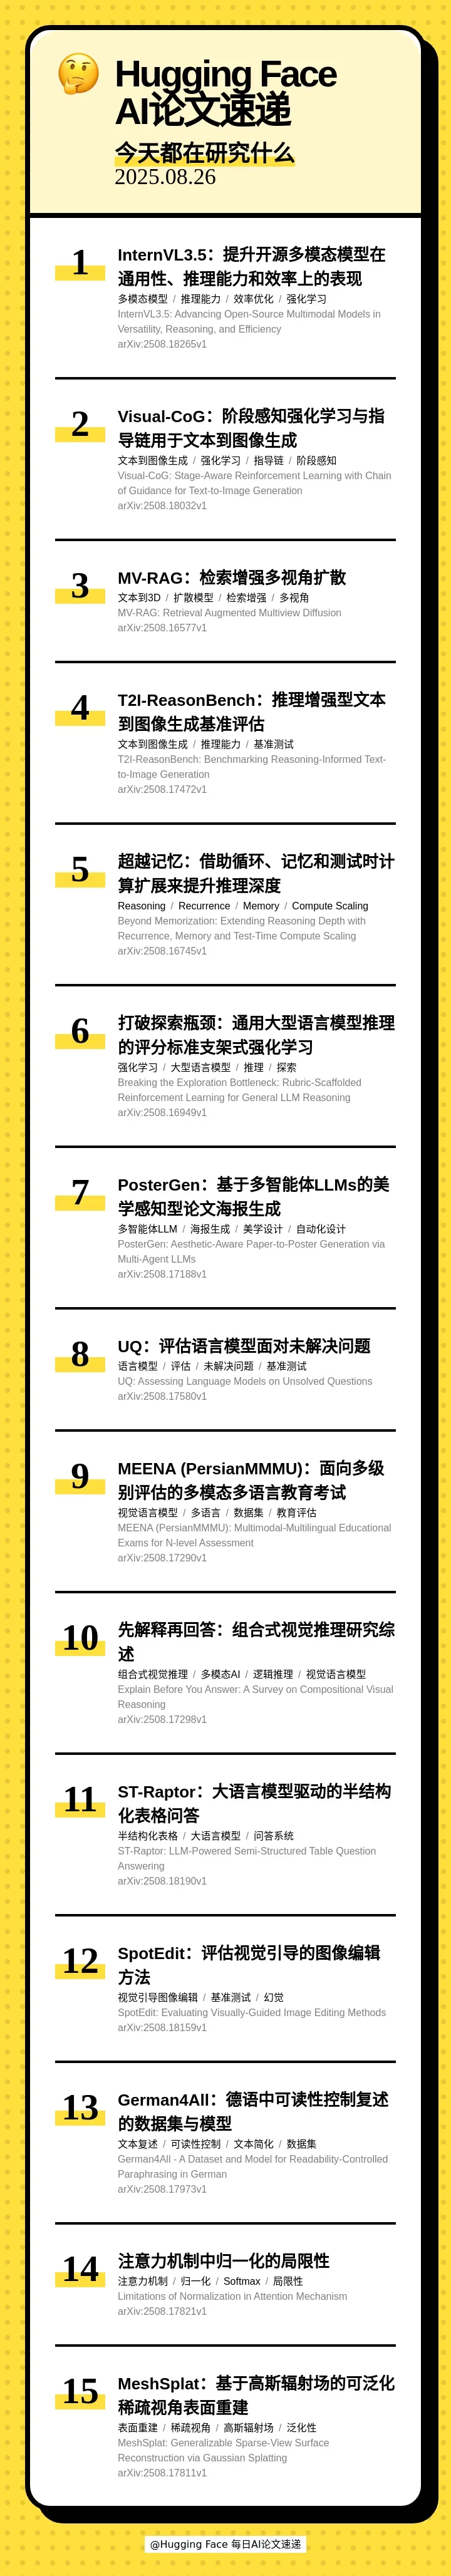
[] 🚀 InternVL3.5: Advancing Open-Source Multimodal Models in Versatility, Reasoning, and Efficiency(InternVL3.5:提升开源多模态模型在通用性、推理能力和效率上的表现)
[] 🧠 Visual-CoG: Stage-Aware Reinforcement Learning with Chain of Guidance for Text-to-Image Generation(Visual-CoG:阶段感知强化学习与指导链用于文本到图像生成)
[] 🎨 MV-RAG: Retrieval Augmented Multiview Diffusion(MV-RAG:检索增强多视角扩散)
[] 🧠 T2I-ReasonBench: Benchmarking Reasoning-Informed Text-to-Image Generation(T2I-ReasonBench:推理增强型文本到图像生成基准评估)
[] 🤔 Beyond Memorization: Extending Reasoning Depth with Recurrence, Memory and Test-Time Compute Scaling(超越记忆:借助循环、记忆和测试时计算扩展来提升推理深度)
[] 🚀 Breaking the Exploration Bottleneck: Rubric-Scaffolded Reinforcement Learning for General LLM Reasoning(打破探索瓶颈:通用大型语言模型推理的评分标准支架式强化学习)
[] 🎨 PosterGen: Aesthetic-Aware Paper-to-Poster Generation via Multi-Agent LLMs(PosterGen:基于多智能体LLMs的美学感知型论文海报生成)
[] 🤔 UQ: Assessing Language Models on Unsolved Questions(UQ:评估语言模型面对未解决问题)
[] 📚 MEENA (PersianMMMU): Multimodal-Multilingual Educational Exams for N-level Assessment(MEENA (PersianMMMU):面向多级别评估的多模态多语言教育考试)
[] 🗺 Explain Before You Answer: A Survey on Compositional Visual Reasoning(先解释再回答:组合式视觉推理研究综述)
[] 📊 ST-Raptor: LLM-Powered Semi-Structured Table Question Answering(ST-Raptor:大语言模型驱动的半结构化表格问答)
[] 🔍 SpotEdit: Evaluating Visually-Guided Image Editing Methods(SpotEdit:评估视觉引导的图像编辑方法)
[] 📖 German4All - A Dataset and Model for Readability-Controlled Paraphrasing in German(German4All:德语中可读性控制复述的数据集与模型)
[] 📉 Limitations of Normalization in Attention Mechanism(注意力机制中归一化的局限性)
[] 🌐 MeshSplat: Generalizable Sparse-View Surface Reconstruction via Gaussian Splatting(MeshSplat:基于高斯辐射场的可泛化稀疏视角表面重建)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 8 月 27 日 · 7 分钟
本期的 15 篇论文如下:
[] 🚀 InternVL3.5: Advancing Open-Source Multimodal Models in Versatility, Reasoning, and Efficiency(InternVL3.5:提升开源多模态模型在通用性、推理能力和效率上的表现)
[] 🧠 Visual-CoG: Stage-Aware Reinforcement Learning with Chain of Guidance for Text-to-Image Generation(Visual-CoG:阶段感知强化学习与指导链用于文本到图像生成)
[] 🎨 MV-RAG: Retrieval Augmented Multiview Diffusion(MV-RAG:检索增强多视角扩散)
[] 🧠 T2I-ReasonBench: Benchmarking Reasoning-Informed Text-to-Image Generation(T2I-ReasonBench:推理增强型文本到图像生成基准评估)
[] 🤔 Beyond Memorization: Extending Reasoning Depth with Recurrence, Memory and Test-Time Compute Scaling(超越记忆:借助循环、记忆和测试时计算扩展来提升推理深度)
[] 🚀 Breaking the Exploration Bottleneck: Rubric-Scaffolded Reinforcement Learning for General LLM Reasoning(打破探索瓶颈:通用大型语言模型推理的评分标准支架式强化学习)
[] 🎨 PosterGen: Aesthetic-Aware Paper-to-Poster Generation via Multi-Agent LLMs(PosterGen:基于多智能体LLMs的美学感知型论文海报生成)
[] 🤔 UQ: Assessing Language Models on Unsolved Questions(UQ:评估语言模型面对未解决问题)
[] 📚 MEENA (PersianMMMU): Multimodal-Multilingual Educational Exams for N-level Assessment(MEENA (PersianMMMU):面向多级别评估的多模态多语言教育考试)
[] 🗺 Explain Before You Answer: A Survey on Compositional Visual Reasoning(先解释再回答:组合式视觉推理研究综述)
[] 📊 ST-Raptor: LLM-Powered Semi-Structured Table Question Answering(ST-Raptor:大语言模型驱动的半结构化表格问答)
[] 🔍 SpotEdit: Evaluating Visually-Guided Image Editing Methods(SpotEdit:评估视觉引导的图像编辑方法)
[] 📖 German4All - A Dataset and Model for Readability-Controlled Paraphrasing in German(German4All:德语中可读性控制复述的数据集与模型)
[] 📉 Limitations of Normalization in Attention Mechanism(注意力机制中归一化的局限性)
[] 🌐 MeshSplat: Generalizable Sparse-View Surface Reconstruction via Gaussian Splatting(MeshSplat:基于高斯辐射场的可泛化稀疏视角表面重建)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟