H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
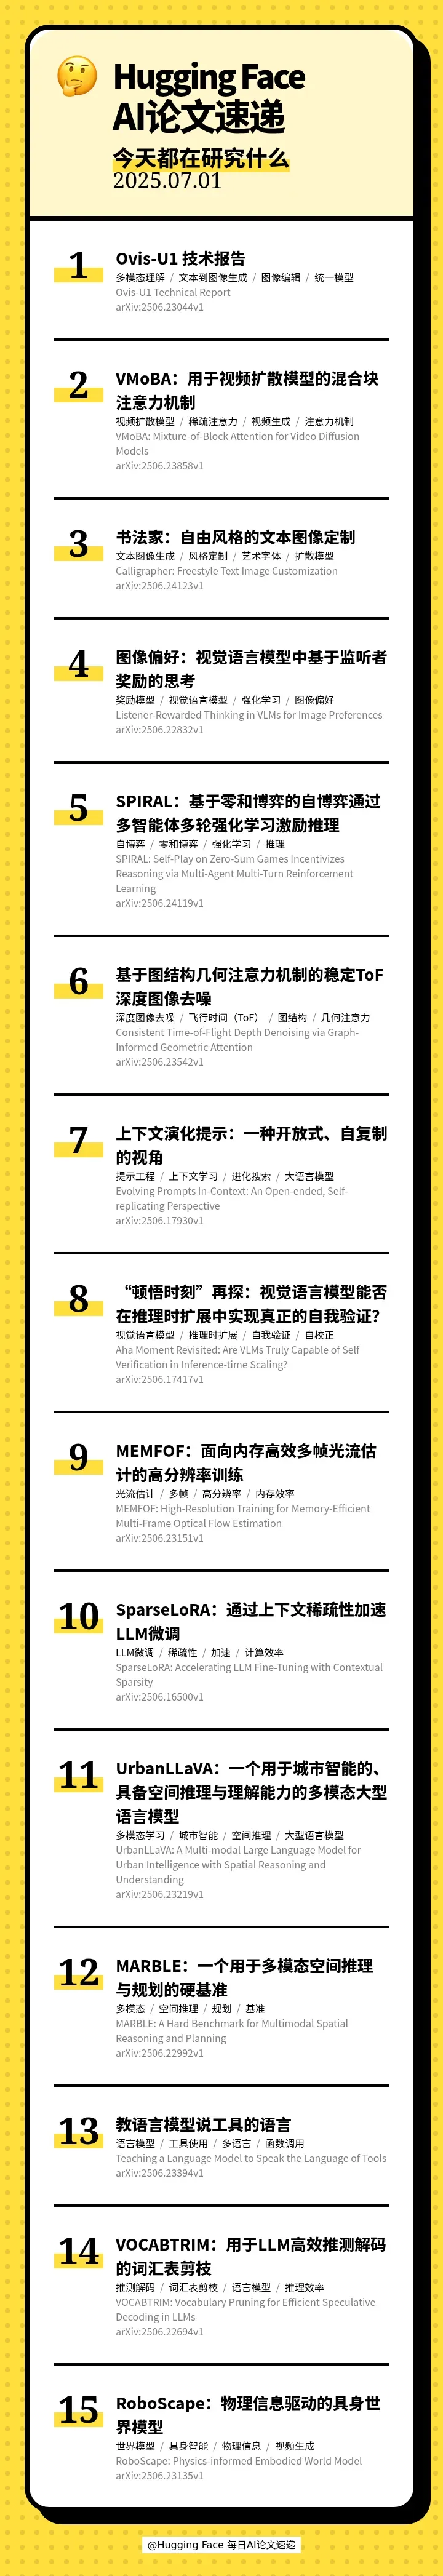
[] 🖼 Ovis-U1 Technical Report(Ovis-U1 技术报告)
[] 🎬 VMoBA: Mixture-of-Block Attention for Video Diffusion Models(VMoBA:用于视频扩散模型的混合块注意力机制)
[] ✍ Calligrapher: Freestyle Text Image Customization(书法家:自由风格的文本图像定制)
[] 🖼 Listener-Rewarded Thinking in VLMs for Image Preferences(图像偏好:视觉语言模型中基于监听者奖励的思考)
[] 🧠 SPIRAL: Self-Play on Zero-Sum Games Incentivizes Reasoning via Multi-Agent Multi-Turn Reinforcement Learning(SPIRAL:基于零和博弈的自博弈通过多智能体多轮强化学习激励推理)
[] 📸 Consistent Time-of-Flight Depth Denoising via Graph-Informed Geometric Attention(基于图结构几何注意力机制的稳定ToF深度图像去噪)
[] 🧬 Evolving Prompts In-Context: An Open-ended, Self-replicating Perspective(上下文演化提示:一种开放式、自复制的视角)
[] 🤔 Aha Moment Revisited: Are VLMs Truly Capable of Self Verification in Inference-time Scaling?(“顿悟时刻”再探:视觉语言模型能否在推理时扩展中实现真正的自我验证?)
[] 💾 MEMFOF: High-Resolution Training for Memory-Efficient Multi-Frame Optical Flow Estimation(MEMFOF:面向内存高效多帧光流估计的高分辨率训练)
[] 🚀 SparseLoRA: Accelerating LLM Fine-Tuning with Contextual Sparsity(SparseLoRA:通过上下文稀疏性加速LLM微调)
[] 🏙 UrbanLLaVA: A Multi-modal Large Language Model for Urban Intelligence with Spatial Reasoning and Understanding(UrbanLLaVA:一个用于城市智能的、具备空间推理与理解能力的多模态大型语言模型)
[] 🧠 MARBLE: A Hard Benchmark for Multimodal Spatial Reasoning and Planning(MARBLE:一个用于多模态空间推理与规划的硬基准)
[] 🧰 Teaching a Language Model to Speak the Language of Tools(教语言模型说工具的语言)
[] ✂ VOCABTRIM: Vocabulary Pruning for Efficient Speculative Decoding in LLMs(VOCABTRIM:用于LLM高效推测解码的词汇表剪枝)
[] 🤖 RoboScape: Physics-informed Embodied World Model(RoboScape:物理信息驱动的具身世界模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 7 月 2 日 · 11 分钟
本期的 15 篇论文如下:
[] 🖼 Ovis-U1 Technical Report(Ovis-U1 技术报告)
[] 🎬 VMoBA: Mixture-of-Block Attention for Video Diffusion Models(VMoBA:用于视频扩散模型的混合块注意力机制)
[] ✍ Calligrapher: Freestyle Text Image Customization(书法家:自由风格的文本图像定制)
[] 🖼 Listener-Rewarded Thinking in VLMs for Image Preferences(图像偏好:视觉语言模型中基于监听者奖励的思考)
[] 🧠 SPIRAL: Self-Play on Zero-Sum Games Incentivizes Reasoning via Multi-Agent Multi-Turn Reinforcement Learning(SPIRAL:基于零和博弈的自博弈通过多智能体多轮强化学习激励推理)
[] 📸 Consistent Time-of-Flight Depth Denoising via Graph-Informed Geometric Attention(基于图结构几何注意力机制的稳定ToF深度图像去噪)
[] 🧬 Evolving Prompts In-Context: An Open-ended, Self-replicating Perspective(上下文演化提示:一种开放式、自复制的视角)
[] 🤔 Aha Moment Revisited: Are VLMs Truly Capable of Self Verification in Inference-time Scaling?(“顿悟时刻”再探:视觉语言模型能否在推理时扩展中实现真正的自我验证?)
[] 💾 MEMFOF: High-Resolution Training for Memory-Efficient Multi-Frame Optical Flow Estimation(MEMFOF:面向内存高效多帧光流估计的高分辨率训练)
[] 🚀 SparseLoRA: Accelerating LLM Fine-Tuning with Contextual Sparsity(SparseLoRA:通过上下文稀疏性加速LLM微调)
[] 🏙 UrbanLLaVA: A Multi-modal Large Language Model for Urban Intelligence with Spatial Reasoning and Understanding(UrbanLLaVA:一个用于城市智能的、具备空间推理与理解能力的多模态大型语言模型)
[] 🧠 MARBLE: A Hard Benchmark for Multimodal Spatial Reasoning and Planning(MARBLE:一个用于多模态空间推理与规划的硬基准)
[] 🧰 Teaching a Language Model to Speak the Language of Tools(教语言模型说工具的语言)
[] ✂ VOCABTRIM: Vocabulary Pruning for Efficient Speculative Decoding in LLMs(VOCABTRIM:用于LLM高效推测解码的词汇表剪枝)
[] 🤖 RoboScape: Physics-informed Embodied World Model(RoboScape:物理信息驱动的具身世界模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟