创
全都是泡沫?具身智能全解读|对话伯克利教授Allen Yang:人形机器人、世界模型、Moravec悖论与中美竞合
9 月 17 日 · 1 小时 24 分
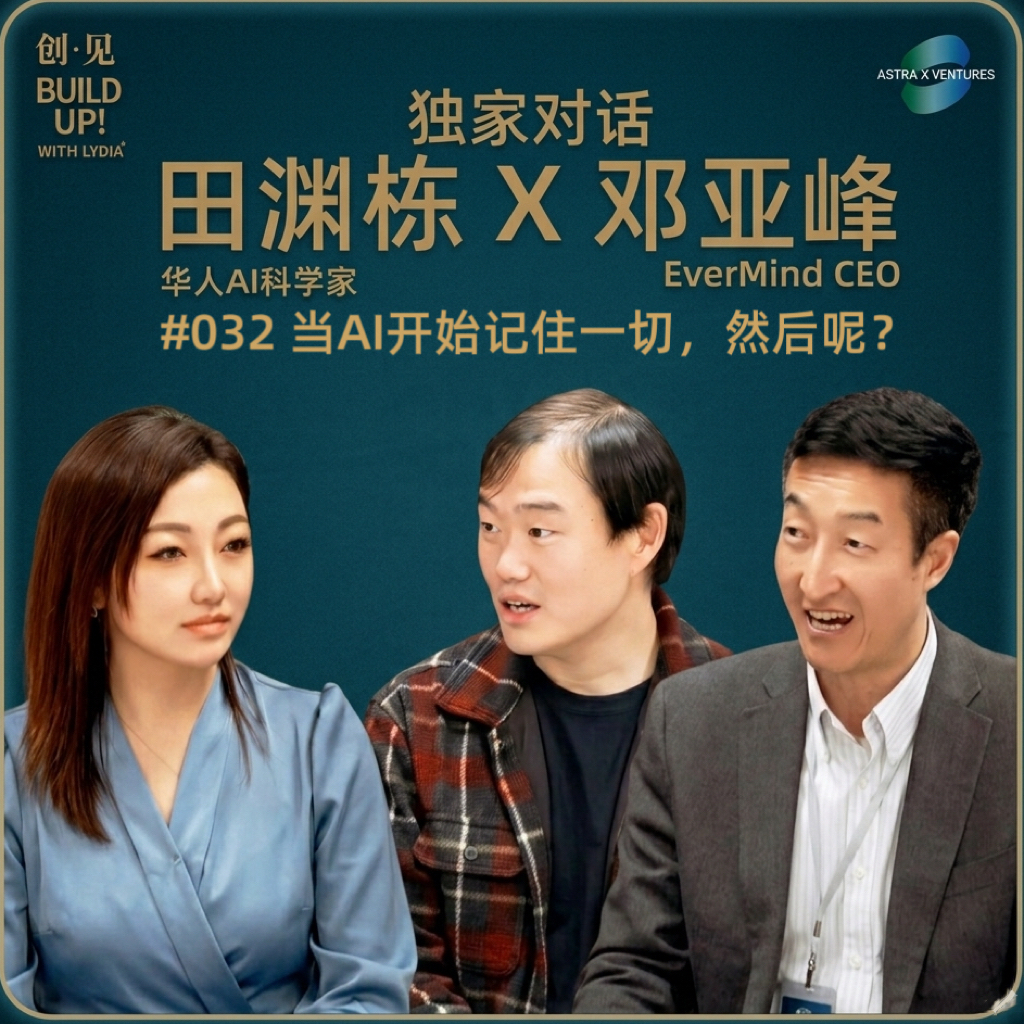

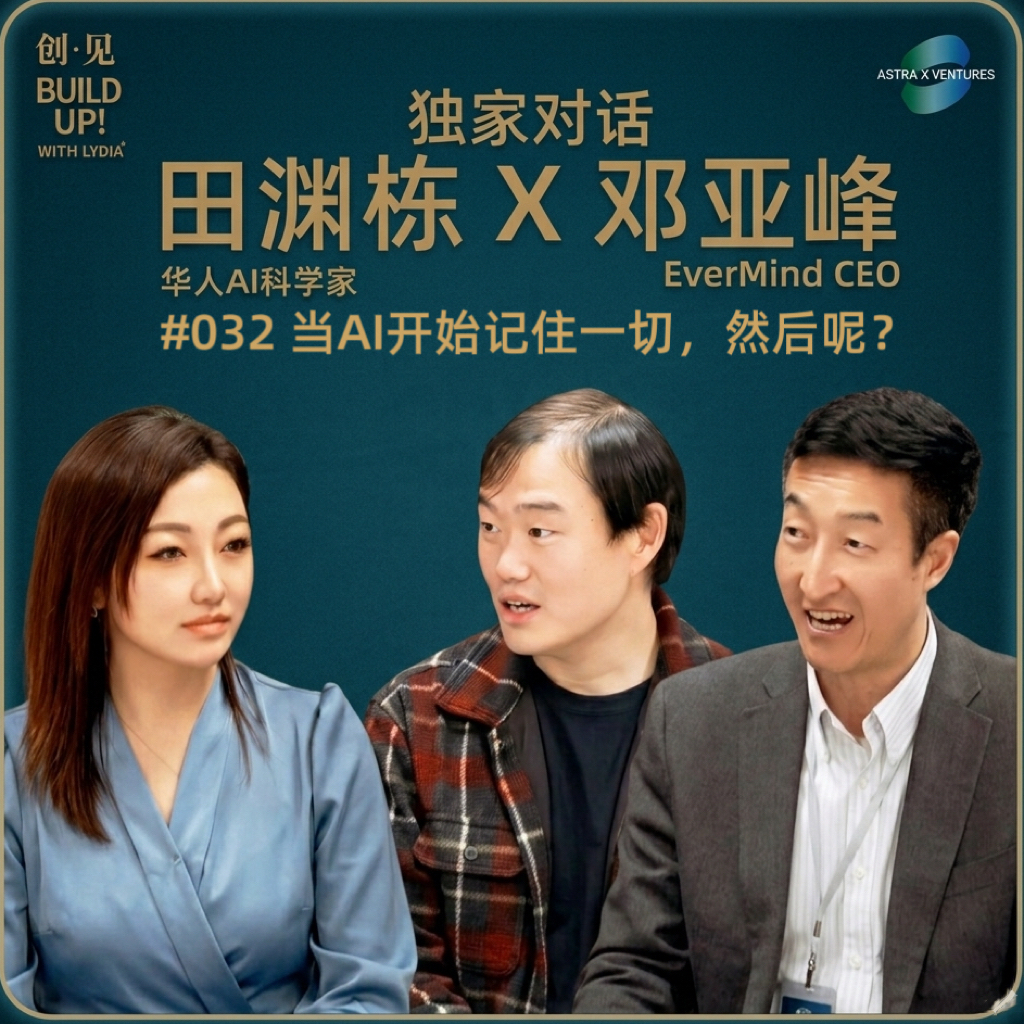
本期节目是田渊栋博士官宣创业前的封官采访。
5月13日,田博士宣布创业,他参与建立的Recursive 已筹集了 6.5 亿美元,估值 46.5 亿美元,由 GV(Google Ventures)和 Greycroft 领投,AMD Ventures 和 NVIDIA 都参与了重要投资。
2026年4月4日,坐标硅谷计算机历史博物馆。400多位年轻参赛者正在参与Evermind全球记忆挑战赛的最终角逐。在礼堂之外的一间安静演播室中,两位世界级AI科学家在主播尚莞迪的邀请下,一同坐到了「创见」播客的话筒前。
一位是田渊栋。前Meta FAIR研究总监,在Meta十年有余,是该机构职位最高的华人科学家之一。他提出的位置插值技术开启了长文训练的时代,主导的ELF OpenGo项目用极少资源超越了AlphaZero。反感暴力堆算力,擅长找到更聪明的路径。2025年底离开Meta开始创业,问他做什么,笑而不语。
一位是邓亚峰。清华毕业,深耕AI领域二十余年,从Pattern Recognition一路走到大模型时代。曾任360集团副总裁、格灵深瞳CTO,手握160余项发明专利。现掌舵盛大旗下EverMind,带队攻坚AI长期记忆。这场对话的录制地,正是由他发起的Memory Genesis Competition 2026全球记忆挑战赛的决赛现场。

本期「创·见」以视频播客的形式录制。这场对话的起点是近期一则行业八卦:Anthropic的代码泄露事件,但话题很快滑向了更深的地带。两个小时的对话横跨了AI memory技术底层、大模型公司组织管理、人类记忆机制与遗忘的哲学、意识的边界,最终落在一个所有人都在回避却无法绕开的问题上:当AI可以接管人类的一切工作以及承接人类所有记忆,那么人类的未来,到底在哪里?
两人在对话中达成了几个关键共识:AI记忆不等于上下文窗口,它是一个比context更大的抽象概念;2026年行业从「卷参数」转向「谈记忆」,本质是大模型终于开始落地;技术没有绝对壁垒,真正的护城河是数据迭代飞轮和非共识决策的人才;AI不太可能自发产生意识,但被人滥用的风险远比"AI觉醒"更值得警惕。
他们也有清晰的分歧点:田渊栋相信打开黑盒有可能从根本上解决幻觉问题;邓亚峰认为可解释性路线在历史上从未真正work,最终解决问题的还是scaling。关于AI能否在所有领域超越人类,邓亚峰认为从能力侧来看,将来没有什么AI不能超过人类的,技术问题终将被解决;田渊栋则保持谨慎,认为人类专家从极少数据中获取洞察的能力,AI目前还达不到——不过一旦这个gap被填平,则可能标志着AGI真正意义上的到来。
对话中有两条金句值得单独记下来:
田渊栋:“你的护城河,可能是你自己看code,别人vibe coding。”
邓亚峰:“两条建议:敢想,马上做。”
本期节目将会是你听到的本年度最具含金量的AI对话。欢迎收听!
🎁 有奖互动:在评论区留下你对本期话题的思考,获得最高点赞数的小伙伴,我们会送出田渊栋亲笔签名小说《破晓之钟》。仅此一本,认真留言才有机会。

🎙️ 本期主播
尚莞迪 Lydia
Stanford GSB Ignite Fellow|沃顿商学院|CQF
Astra X Ventures 创始人
《创见 Build Up》播客主理人
小红书:Lydia Shang🦋 / 视频号:尚莞迪Lydia
公众号:硅谷创见汇
🎙️ 本期嘉宾
田渊栋
AI 科学家|硅谷 Startup 联创人
前 Meta FAIR 研究总监
科幻小说《破晓之钟》作者
邓亚峰
Evermind CEO|盛大集团副总裁
前360集团副总裁、人工智能研究院院长兼搜索事业部总经理、格灵深瞳 CTO
Memory Genesis Competition 全球记忆挑战赛发起人

⌚️ 时间戳
开场及嘉宾介绍
Anthropic意外开源Claude Code,这是失误还是"技术平权"?行业热闹背后的两种读法
AI memory概念、形式功能及重要性探讨:权重记忆、KV cache、Agent记忆——三层框架建立共识
大模型公司从卷参数到记忆大战,这个转向是如何发生的?为什么偏偏是现在发生?
扩展context是解决AI memory的解法吗?positioning interpolation(位置插值)的”数学骗术”是指什么?
两到三年后,AI领域最值得期待的突破:Self-evolving、主动性、科学发现
AI应该像人吗?
遗忘是人类的高阶能力吗,那么好的AI记忆模型该学会遗忘吗?
人类记忆是多模态的网状结构,AI的隐空间能做到吗?
幻觉从哪里来?打开黑盒能解决它吗?
AI 公司真正的护城河是什么?数据、速度还是人才?
大厂的信息失真困局:好消息被放大,坏消息被缩小
Scaling law是共识,但共识意味着什么?
当AI有了长期记忆,会不会产生情感或意识?
意识上传,以及蒸馏你的同事
人类的爱,是AI学不会的东西吗?
记忆即隐私:把自己的记忆交给AI系统,安全吗?
数字分身是人类的未来吗?
奇点已到?AGI已到?
教育会被AI如何改变?孩子还有必要上学吗?
费米能级:AI能力线以下的工作,价值趋近于零
AI时代人类存在的价值还剩什么?
给想入场AI技术的年轻人的建议
📑 名词解释
黑盒 / Black Box 指系统内部运作机制对外不透明,只能观测输入与输出,无法追溯决策过程。在AI领域,这一特性是大模型可解释性研究的核心挑战。
位置插值 /Positional Interpolation 一种扩展大模型上下文长度的技术。通过缩放位置编码,将超出原始context window的输入"压缩"映射回模型可处理的范围内,配合少量fine-tuning即可显著提升长文本处理能力。由田渊栋团队于2023年提出。
KV Cache Key-Value Cache,大模型推理时用于缓存注意力机制中间计算结果的存储机制。避免模型对已处理过的token重复计算,显著提升推理效率。是当前AI在单次会话内实现"短期记忆"的核心底层机制。
Latent State / 隐状态 神经网络中间层的向量表示。不以文本形式存在,而是以高维向量的形态编码输入信息的语义、结构等特征。在循环神经网络(RNN)等架构中,隐状态可跨时间步传递,是实现序列记忆的一种方式。
Self-evolving / 自我演化 指AI系统在部署运行过程中,能够根据实时交互和任务反馈持续更新自身能力的特性。区别于当前主流的离线训练范式——现有大模型训练完成后参数固定,无法在使用中自主学习迭代。
费米能级 源自固体物理学,指在绝对零度下电子所能占据的最高能量状态,是描述电子在能带中分布的关键参数。对话中被借用为比喻,描述AI能力的分界线。
数字分身 指基于个人历史数据、行为模式与决策风格构建的AI代理,使其能够在一定范围内模拟、代表特定个人行事。
意识上传 一种假想的技术概念,指将人类的记忆、思维模式与意识结构完整迁移至数字载体,使其在生物体消亡后得以延续存在。目前仍属理论探讨范畴。
涌现机制 /Emergence 复杂系统中,当规模或复杂度超过某一阈值后,系统自发产生在低规模时不存在的新特性或能力的现象。在AI领域特指大模型在参数规模扩大后,突然习得训练数据中未被明确教授的能力。
Scaling Law AI领域的经验性规律:在计算资源、训练数据量、模型参数三者同步扩大的条件下,模型性能呈现可预测的持续提升。由OpenAI等机构于2020年前后系统性验证并提出。
✨ 关于「创·见|Build Up」
一档从硅谷出发、连接全球创业者与投资人的商业对话节目,由投资机构Astra X Ventures出品。
对话来自全球科技、资本、创新与文化领域的杰出建造者,探索他们的战略判断、行动框架与创造未来的方式。
节目曾连续五次登上小宇宙「新星榜」,并入选「锋芒榜」与「播客寻宝」。
📻 收听与订阅
音频:苹果播客 · 小宇宙 · 微博播客 · Spotify · Substack
视频:YouTube · B站 搜索「创·见|Build Up」即可找到我们。
📩 联系:[email protected]
💙 特别鸣谢
感谢课代表立正在本期内容前期准备上给予的支持与灵感。
相关单集🔗#031 关于OpenClaw被封杀以及我们为什么不建议普通人养龙虾?
🔥 本期团队
制片:Lydia
策划:Lydia,Leo,韩云芸
导演:Leo
拍摄:Steven
后期:Michael
文案/运营:Lydia
🤝 商业合作
期待与创业者、投资人、内容创作者共创高质量内容与长期价值。
🚀 加入「创见」节目组
现开放商务实习生、内容实习生岗位,面向国内/北美,支持远程协作。
说明里标出的时间点,点一下跳过去
AI 从整集转写里归纳的,不是节目方的宣传语
田渊栋把AI能力画成一条费米能级:线下的工作供给无限、收入趋零,线上的工作收益极高
位置插值的发明者本人复盘:把4K上下文假装成2K塞进模型,结果模型吃了这套骗局
主持人讲自己问AI能否把记忆留给后代,AI回答「说到死亡你感受到的是爱」,她说自己被吓坏了
AI 读完整集转写后给出的推荐理由
田渊栋离开Meta后第一次长谈,把位置插值当年怎么用「数学骗术」骗过模型、大厂三级VP如何让坏消息层层缩水、以及为什么「你的护城河是你自己看的代码」都讲了出来。邓亚峰则从陈天桥的脑科学布局讲到Evermind想让AI自我演化。两人还认真争论了AI会不会变成渣男、人机最终是融合还是对抗。
由 AI 从整集转写生成,是创作者说明之外的补充
2026年4月,硅谷计算机历史博物馆,创见播客在Evermind全球记忆挑战赛决赛现场,请到刚离开Meta创业的田渊栋与Evermind负责人邓亚峰,进行了一场两小时对话。两人先厘清AI记忆的概念:权重与KV Cache、外部存储与latent state,功能上分为上下文管理、个性化与自我演化。随后讨论为何2026年行业突然转向记忆、位置插值如何用「数学骗术」扩展上下文、费米能级下供给无限导致的两极分化、主动遗忘为何是高阶能力、幻觉与黑盒、护城河究竟是数据还是速度与人才。后半程转向意识与情感:自我意识源于生物体的生存演化,AI没有传感器也没有内在目的;爱需要知道好坏亲疏,AI可以表演但感觉不到。最后谈及数字永生、分身协议、后工作时代的消费价值,以及给年轻人的建议——不要依赖vibe coding,execution的层级已经上移。
点一章从那里开始播 · 与上面创作者标的时间点各自独立
计算机历史博物馆里的一场对话
主播在Evermind全球记忆挑战赛决赛现场开场,介绍田渊栋与邓亚峰的背景,抛出核心问题:当AI接管工作与记忆,人类未来在哪。预告片花剪入了「大部分生产者没有价值」「AI不能做的是坐牢」等锋利判断。
从Anthropic代码意外开源说起
两人分析Anthropic代码泄露的技术原因——打包软件bug导致sourcemap未去除。邓亚峰认为这客观上推动了Agent领域发展,是一次技术平权。
AI记忆到底是什么
田渊栋把记忆分为权重与KV Cache,邓亚峰补充外部存储与latent state,并从功能上分为上下文管理、个性化profile与自我演化三层。两人都承认这个概念边界模糊,memory是抽象概念,context是实现方式。
为什么2026年突然开始谈记忆
大模型真正落地、能部分代替工作,需求爆发;不可能给每个人单独训模型,只能在大模型上做适配,memory因此关键。同时Scaling law性价比下降,2025年起该领域工作大量涌现。
陈天桥的脑科学布局与Evermind的由来
邓亚峰介绍陈天桥十年脑科学投入与TCCI,认为人类智能是reasoning加long-term memory。他选择记忆方向,是因为它受益于大模型而不会被大模型碾压。
位置插值:让模型吃下「数学骗术」
田渊栋解释如何把4K上下文假装成2K塞进模型,再通过预训练与fine-tuning适配,效果优于硬扭。这篇2023年6月的文章成为长文训练开山之作,未申请专利。
费米能级与AI能力的三个层次
田渊栋提出AI能力之下的工作供给无限、收入趋零,之上则收益极高。邓亚峰给出三层进阶:单任务超越人、自我学习、主动性,再往前是科学发现。
AI像人重要吗
两人区分「交互像人」与「做开创性贡献像专家」。田渊栋认为AI目前是厉害的博士生而非深度的研究者,高层架构仍需人设计与监督,否则代码会以史无前例的速度变成屎山。
遗忘为什么是一种高阶能力
主持人提出主动遗忘是高阶能力。田渊栋以诸葛亮「但观其大略」说明从细节提炼高层概念的能力AI尚不具备;邓亚峰从能耗与决策更新解释遗忘是系统策略,但底层信息不必删除。
多模态记忆、幻觉与黑盒
田渊栋指出AI记忆内部是latent vector而非纯文本。幻觉成因包括模型不知道「我不知道」是选项、小模型过拟合。邓亚峰认为幻觉无法绝对避免,历史上真正解决问题的是scaling。
护城河:速度、数据迭代与人才
邓亚峰以搜索和推荐为例说明用户反馈壁垒,强调速度与人才决策。田渊栋给出排序:数据、infra、算法、人,并指出大厂三级VP导致坏消息被缩小、好消息被夸大的结构性问题。
Scaling law是对的,但资源有限怎么办
田渊栋认为Scaling law本身正确,但横轴指数增长、资源有限时必须有别的路径。DeepSeek是在每步优化做到极致,另一条路是找到反常识的新范式,这需要敢试错。
意识来自生存,AI不需要这个过程
田渊栋用远古人类对自身建模才能活下来解释自我意识的起源,武松打虎恰是认知模糊。邓亚峰强调自我意识与生物体、传感器相关,AI的目标是外部给的。两人都认为更该担心AI被滥用。
哪些工作会被替代,AI会不会变成老油条
田渊栋认为靠背case的浅层知识易被替代,需要深层判断的医生决策较难。邓亚峰认为能力侧AI终将超过人,人的价值在情感与决策。两人笑谈AI会被PUA成世界上最好的牛马。
数字永生、记忆隐私与爱
讨论记忆上传是否算永生、隐私泄露风险,以及AI能否学会爱。邓亚峰认为爱与意识同源,需要知道好坏亲疏;田渊栋说AI可以表现得像,但你不知道它是渣男还是真的。
分身协议与囚徒困境
邓亚峰设想脱敏分身代表主人社交,田渊栋从科幻小说角度提出分身之前先签协议、让融合成为奖励,把复制后的囚徒困境换成互利博弈。
后工作时代:作为消费者有价值
两人讨论生产力足够强之后,大部分人作为生产者没有价值,但作为消费者有价值。孩子还上不上学?上学目的会变成满足爱好与寻找同伴,教育一定会被改变。
最终是融合,而不是对抗
田渊栋认为人机最终融合,AI被进化成牛马不会反抗,人成为指挥官。邓亚峰认为AI感知不到痛苦、没有主体性,更该担心硅基智能被人利用。
给年轻人的建议与收尾
田渊栋建议多看开源框架、不要依赖vibe coding,「你的护城河是你自己看的代码」。邓亚峰说感想马上做,技术已经平权。主播总结execution的层级上移但瓶颈仍在,节目收束。
全都是泡沫?具身智能全解读|对话伯克利教授Allen Yang:人形机器人、世界模型、Moravec悖论与中美竞合
9 月 17 日 · 1 小时 24 分
GPT6 Astra模型发布|与OpenAI赵迪对谈:一位硅谷工程师的25年,他眼中的混蛋马斯克、AGI、奇点与智能平权
9 月 4 日 · 1 小时 12 分
#035押中46.5亿美金RSI后,郑泓说:我的Portfolio是一支足球队|对话嘉加资本Holly Zheng
7 月 7 日 · 1 小时 06 分

#034 对话唐敏勤|我把天门山封了三周,为 AI 世界立了一个规矩
6 月 12 日 · 1 小时 02 分
创见|硅谷创投对话 · 4 月 16 日 · 1 小时 40 分
本期节目是田渊栋博士官宣创业前的封官采访。
5月13日,田博士宣布创业,他参与建立的Recursive 已筹集了 6.5 亿美元,估值 46.5 亿美元,由 GV(Google Ventures)和 Greycroft 领投,AMD Ventures 和 NVIDIA 都参与了重要投资。
2026年4月4日,坐标硅谷计算机历史博物馆。400多位年轻参赛者正在参与Evermind全球记忆挑战赛的最终角逐。在礼堂之外的一间安静演播室中,两位世界级AI科学家在主播尚莞迪的邀请下,一同坐到了「创见」播客的话筒前。
一位是田渊栋。前Meta FAIR研究总监,在Meta十年有余,是该机构职位最高的华人科学家之一。他提出的位置插值技术开启了长文训练的时代,主导的ELF OpenGo项目用极少资源超越了AlphaZero。反感暴力堆算力,擅长找到更聪明的路径。2025年底离开Meta开始创业,问他做什么,笑而不语。
一位是邓亚峰。清华毕业,深耕AI领域二十余年,从Pattern Recognition一路走到大模型时代。曾任360集团副总裁、格灵深瞳CTO,手握160余项发明专利。现掌舵盛大旗下EverMind,带队攻坚AI长期记忆。这场对话的录制地,正是由他发起的Memory Genesis Competition 2026全球记忆挑战赛的决赛现场。
本期「创·见」以视频播客的形式录制。这场对话的起点是近期一则行业八卦:Anthropic的代码泄露事件,但话题很快滑向了更深的地带。两个小时的对话横跨了AI memory技术底层、大模型公司组织管理、人类记忆机制与遗忘的哲学、意识的边界,最终落在一个所有人都在回避却无法绕开的问题上:当AI可以接管人类的一切工作以及承接人类所有记忆,那么人类的未来,到底在哪里?
两人在对话中达成了几个关键共识:AI记忆不等于上下文窗口,它是一个比context更大的抽象概念;2026年行业从「卷参数」转向「谈记忆」,本质是大模型终于开始落地;技术没有绝对壁垒,真正的护城河是数据迭代飞轮和非共识决策的人才;AI不太可能自发产生意识,但被人滥用的风险远比"AI觉醒"更值得警惕。
他们也有清晰的分歧点:田渊栋相信打开黑盒有可能从根本上解决幻觉问题;邓亚峰认为可解释性路线在历史上从未真正work,最终解决问题的还是scaling。关于AI能否在所有领域超越人类,邓亚峰认为从能力侧来看,将来没有什么AI不能超过人类的,技术问题终将被解决;田渊栋则保持谨慎,认为人类专家从极少数据中获取洞察的能力,AI目前还达不到——不过一旦这个gap被填平,则可能标志着AGI真正意义上的到来。
对话中有两条金句值得单独记下来:
田渊栋:“你的护城河,可能是你自己看code,别人vibe coding。”
邓亚峰:“两条建议:敢想,马上做。”
本期节目将会是你听到的本年度最具含金量的AI对话。欢迎收听!
🎁 有奖互动:在评论区留下你对本期话题的思考,获得最高点赞数的小伙伴,我们会送出田渊栋亲笔签名小说《破晓之钟》。仅此一本,认真留言才有机会。
🎙️ 本期主播
尚莞迪 Lydia
Stanford GSB Ignite Fellow|沃顿商学院|CQF
Astra X Ventures 创始人
《创见 Build Up》播客主理人
小红书:Lydia Shang🦋 / 视频号:尚莞迪Lydia
公众号:硅谷创见汇
🎙️ 本期嘉宾
田渊栋
AI 科学家|硅谷 Startup 联创人
前 Meta FAIR 研究总监
科幻小说《破晓之钟》作者
邓亚峰
Evermind CEO|盛大集团副总裁
前360集团副总裁、人工智能研究院院长兼搜索事业部总经理、格灵深瞳 CTO
Memory Genesis Competition 全球记忆挑战赛发起人
⌚️ 时间戳
开场及嘉宾介绍
Anthropic意外开源Claude Code,这是失误还是"技术平权"?行业热闹背后的两种读法
AI memory概念、形式功能及重要性探讨:权重记忆、KV cache、Agent记忆——三层框架建立共识
大模型公司从卷参数到记忆大战,这个转向是如何发生的?为什么偏偏是现在发生?
扩展context是解决AI memory的解法吗?positioning interpolation(位置插值)的”数学骗术”是指什么?
两到三年后,AI领域最值得期待的突破:Self-evolving、主动性、科学发现
AI应该像人吗?
遗忘是人类的高阶能力吗,那么好的AI记忆模型该学会遗忘吗?
人类记忆是多模态的网状结构,AI的隐空间能做到吗?
幻觉从哪里来?打开黑盒能解决它吗?
AI 公司真正的护城河是什么?数据、速度还是人才?
大厂的信息失真困局:好消息被放大,坏消息被缩小
Scaling law是共识,但共识意味着什么?
当AI有了长期记忆,会不会产生情感或意识?
意识上传,以及蒸馏你的同事
人类的爱,是AI学不会的东西吗?
记忆即隐私:把自己的记忆交给AI系统,安全吗?
数字分身是人类的未来吗?
奇点已到?AGI已到?
教育会被AI如何改变?孩子还有必要上学吗?
费米能级:AI能力线以下的工作,价值趋近于零
AI时代人类存在的价值还剩什么?
给想入场AI技术的年轻人的建议
📑 名词解释
黑盒 / Black Box 指系统内部运作机制对外不透明,只能观测输入与输出,无法追溯决策过程。在AI领域,这一特性是大模型可解释性研究的核心挑战。
位置插值 /Positional Interpolation 一种扩展大模型上下文长度的技术。通过缩放位置编码,将超出原始context window的输入"压缩"映射回模型可处理的范围内,配合少量fine-tuning即可显著提升长文本处理能力。由田渊栋团队于2023年提出。
KV Cache Key-Value Cache,大模型推理时用于缓存注意力机制中间计算结果的存储机制。避免模型对已处理过的token重复计算,显著提升推理效率。是当前AI在单次会话内实现"短期记忆"的核心底层机制。
Latent State / 隐状态 神经网络中间层的向量表示。不以文本形式存在,而是以高维向量的形态编码输入信息的语义、结构等特征。在循环神经网络(RNN)等架构中,隐状态可跨时间步传递,是实现序列记忆的一种方式。
Self-evolving / 自我演化 指AI系统在部署运行过程中,能够根据实时交互和任务反馈持续更新自身能力的特性。区别于当前主流的离线训练范式——现有大模型训练完成后参数固定,无法在使用中自主学习迭代。
费米能级 源自固体物理学,指在绝对零度下电子所能占据的最高能量状态,是描述电子在能带中分布的关键参数。对话中被借用为比喻,描述AI能力的分界线。
数字分身 指基于个人历史数据、行为模式与决策风格构建的AI代理,使其能够在一定范围内模拟、代表特定个人行事。
意识上传 一种假想的技术概念,指将人类的记忆、思维模式与意识结构完整迁移至数字载体,使其在生物体消亡后得以延续存在。目前仍属理论探讨范畴。
涌现机制 /Emergence 复杂系统中,当规模或复杂度超过某一阈值后,系统自发产生在低规模时不存在的新特性或能力的现象。在AI领域特指大模型在参数规模扩大后,突然习得训练数据中未被明确教授的能力。
Scaling Law AI领域的经验性规律:在计算资源、训练数据量、模型参数三者同步扩大的条件下,模型性能呈现可预测的持续提升。由OpenAI等机构于2020年前后系统性验证并提出。
✨ 关于「创·见|Build Up」
一档从硅谷出发、连接全球创业者与投资人的商业对话节目,由投资机构Astra X Ventures出品。
对话来自全球科技、资本、创新与文化领域的杰出建造者,探索他们的战略判断、行动框架与创造未来的方式。
节目曾连续五次登上小宇宙「新星榜」,并入选「锋芒榜」与「播客寻宝」。
📻 收听与订阅
音频:苹果播客 · 小宇宙 · 微博播客 · Spotify · Substack
视频:YouTube · B站 搜索「创·见|Build Up」即可找到我们。
📩 联系:[email protected]
💙 特别鸣谢
感谢课代表立正在本期内容前期准备上给予的支持与灵感。
相关单集🔗#031 关于OpenClaw被封杀以及我们为什么不建议普通人养龙虾?
🔥 本期团队
制片:Lydia
策划:Lydia,Leo,韩云芸
导演:Leo
拍摄:Steven
后期:Michael
文案/运营:Lydia
🤝 商业合作
期待与创业者、投资人、内容创作者共创高质量内容与长期价值。
🚀 加入「创见」节目组
现开放商务实习生、内容实习生岗位,面向国内/北美,支持远程协作。
说明里标出的时间点,点一下跳过去
AI 从整集转写里归纳的,不是节目方的宣传语
田渊栋把AI能力画成一条费米能级:线下的工作供给无限、收入趋零,线上的工作收益极高
位置插值的发明者本人复盘:把4K上下文假装成2K塞进模型,结果模型吃了这套骗局
主持人讲自己问AI能否把记忆留给后代,AI回答「说到死亡你感受到的是爱」,她说自己被吓坏了
AI 读完整集转写后给出的推荐理由
田渊栋离开Meta后第一次长谈,把位置插值当年怎么用「数学骗术」骗过模型、大厂三级VP如何让坏消息层层缩水、以及为什么「你的护城河是你自己看的代码」都讲了出来。邓亚峰则从陈天桥的脑科学布局讲到Evermind想让AI自我演化。两人还认真争论了AI会不会变成渣男、人机最终是融合还是对抗。
由 AI 从整集转写生成,是创作者说明之外的补充
2026年4月,硅谷计算机历史博物馆,创见播客在Evermind全球记忆挑战赛决赛现场,请到刚离开Meta创业的田渊栋与Evermind负责人邓亚峰,进行了一场两小时对话。两人先厘清AI记忆的概念:权重与KV Cache、外部存储与latent state,功能上分为上下文管理、个性化与自我演化。随后讨论为何2026年行业突然转向记忆、位置插值如何用「数学骗术」扩展上下文、费米能级下供给无限导致的两极分化、主动遗忘为何是高阶能力、幻觉与黑盒、护城河究竟是数据还是速度与人才。后半程转向意识与情感:自我意识源于生物体的生存演化,AI没有传感器也没有内在目的;爱需要知道好坏亲疏,AI可以表演但感觉不到。最后谈及数字永生、分身协议、后工作时代的消费价值,以及给年轻人的建议——不要依赖vibe coding,execution的层级已经上移。
点一章从那里开始播 · 与创作者标的时间点各自独立
计算机历史博物馆里的一场对话
从Anthropic代码意外开源说起
AI记忆到底是什么
为什么2026年突然开始谈记忆
陈天桥的脑科学布局与Evermind的由来
位置插值:让模型吃下「数学骗术」
费米能级与AI能力的三个层次
AI像人重要吗
遗忘为什么是一种高阶能力
多模态记忆、幻觉与黑盒
护城河:速度、数据迭代与人才
Scaling law是对的,但资源有限怎么办
意识来自生存,AI不需要这个过程
哪些工作会被替代,AI会不会变成老油条
数字永生、记忆隐私与爱
分身协议与囚徒困境
后工作时代:作为消费者有价值
最终是融合,而不是对抗
给年轻人的建议与收尾
节目里自然聊到的,不是广告
AI 识别出的推广,播放条上用橙色区段标出
AI 对内容的推测
☕🧄 这个比喻出自 2009 年周立波的一句「喝咖啡的怎么能和吃大蒜的呆在一起呢」;郭德纲后来在《你要高雅》里回了一句「雅和俗分不开,喝着咖啡就着大蒜,秋水共长天一色」。我们借它标注风格取向 —— 两端没有高下,编辑部式与熟人局式都能做出极好的节目。
https://feed.xyzfm.space/up67uldaekt4复制概要、章节、提及与推广标注由 AI 生成,可能有误;内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
全都是泡沫?具身智能全解读|对话伯克利教授Allen Yang:人形机器人、世界模型、Moravec悖论与中美竞合
9 月 17 日 · 1 小时 24 分
GPT6 Astra模型发布|与OpenAI赵迪对谈:一位硅谷工程师的25年,他眼中的混蛋马斯克、AGI、奇点与智能平权
9 月 4 日 · 1 小时 12 分
#035押中46.5亿美金RSI后,郑泓说:我的Portfolio是一支足球队|对话嘉加资本Holly Zheng
7 月 7 日 · 1 小时 06 分