H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
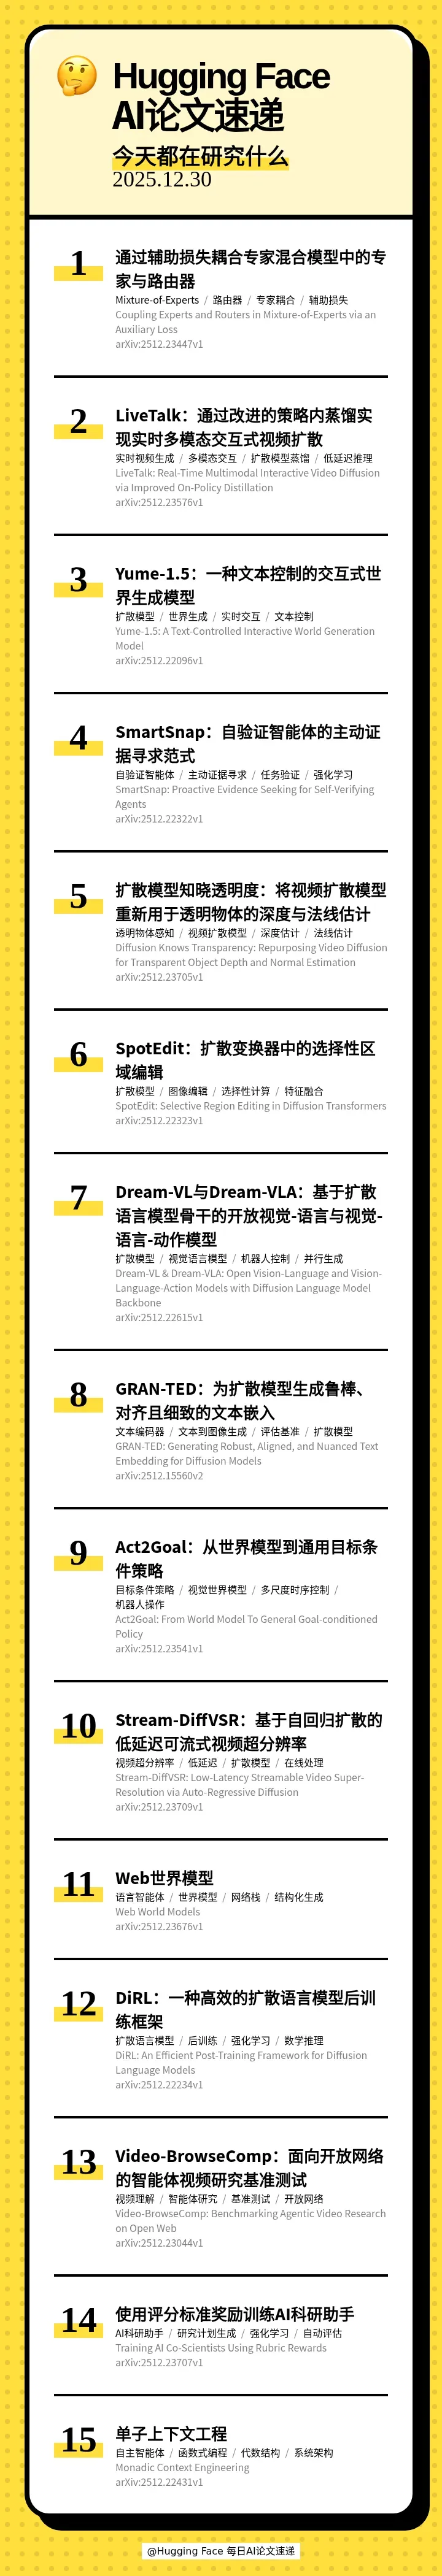
[] 🔗 Coupling Experts and Routers in Mixture-of-Experts via an Auxiliary Loss(通过辅助损失耦合专家混合模型中的专家与路由器)
[] 🎬 LiveTalk: Real-Time Multimodal Interactive Video Diffusion via Improved On-Policy Distillation(LiveTalk:通过改进的策略内蒸馏实现实时多模态交互式视频扩散)
[] 🌍 Yume-1.5: A Text-Controlled Interactive World Generation Model(Yume-1.5:一种文本控制的交互式世界生成模型)
[] 🔍 SmartSnap: Proactive Evidence Seeking for Self-Verifying Agents(SmartSnap:自验证智能体的主动证据寻求范式)
[] 🔮 Diffusion Knows Transparency: Repurposing Video Diffusion for Transparent Object Depth and Normal Estimation(扩散模型知晓透明度:将视频扩散模型重新用于透明物体的深度与法线估计)
[] 🎯 SpotEdit: Selective Region Editing in Diffusion Transformers(SpotEdit:扩散变换器中的选择性区域编辑)
[] 🚀 Dream-VL & Dream-VLA: Open Vision-Language and Vision-Language-Action Models with Diffusion Language Model Backbone(Dream-VL与Dream-VLA:基于扩散语言模型骨干的开放视觉-语言与视觉-语言-动作模型)
[] 🔍 GRAN-TED: Generating Robust, Aligned, and Nuanced Text Embedding for Diffusion Models(GRAN-TED:为扩散模型生成鲁棒、对齐且细致的文本嵌入)
[] 🤖 Act2Goal: From World Model To General Goal-conditioned Policy(Act2Goal:从世界模型到通用目标条件策略)
[] ⚡ Stream-DiffVSR: Low-Latency Streamable Video Super-Resolution via Auto-Regressive Diffusion(Stream-DiffVSR:基于自回归扩散的低延迟可流式视频超分辨率)
[] 🌐 Web World Models(Web世界模型)
[] 🚀 DiRL: An Efficient Post-Training Framework for Diffusion Language Models(DiRL:一种高效的扩散语言模型后训练框架)
[] 🎬 Video-BrowseComp: Benchmarking Agentic Video Research on Open Web(Video-BrowseComp:面向开放网络的智能体视频研究基准测试)
[] 🧠 Training AI Co-Scientists Using Rubric Rewards(使用评分标准奖励训练AI科研助手)
[] 🧩 Monadic Context Engineering(单子上下文工程)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 12 月 31 日 · 11 分钟
本期的 15 篇论文如下:
[] 🔗 Coupling Experts and Routers in Mixture-of-Experts via an Auxiliary Loss(通过辅助损失耦合专家混合模型中的专家与路由器)
[] 🎬 LiveTalk: Real-Time Multimodal Interactive Video Diffusion via Improved On-Policy Distillation(LiveTalk:通过改进的策略内蒸馏实现实时多模态交互式视频扩散)
[] 🌍 Yume-1.5: A Text-Controlled Interactive World Generation Model(Yume-1.5:一种文本控制的交互式世界生成模型)
[] 🔍 SmartSnap: Proactive Evidence Seeking for Self-Verifying Agents(SmartSnap:自验证智能体的主动证据寻求范式)
[] 🔮 Diffusion Knows Transparency: Repurposing Video Diffusion for Transparent Object Depth and Normal Estimation(扩散模型知晓透明度:将视频扩散模型重新用于透明物体的深度与法线估计)
[] 🎯 SpotEdit: Selective Region Editing in Diffusion Transformers(SpotEdit:扩散变换器中的选择性区域编辑)
[] 🚀 Dream-VL & Dream-VLA: Open Vision-Language and Vision-Language-Action Models with Diffusion Language Model Backbone(Dream-VL与Dream-VLA:基于扩散语言模型骨干的开放视觉-语言与视觉-语言-动作模型)
[] 🔍 GRAN-TED: Generating Robust, Aligned, and Nuanced Text Embedding for Diffusion Models(GRAN-TED:为扩散模型生成鲁棒、对齐且细致的文本嵌入)
[] 🤖 Act2Goal: From World Model To General Goal-conditioned Policy(Act2Goal:从世界模型到通用目标条件策略)
[] ⚡ Stream-DiffVSR: Low-Latency Streamable Video Super-Resolution via Auto-Regressive Diffusion(Stream-DiffVSR:基于自回归扩散的低延迟可流式视频超分辨率)
[] 🌐 Web World Models(Web世界模型)
[] 🚀 DiRL: An Efficient Post-Training Framework for Diffusion Language Models(DiRL:一种高效的扩散语言模型后训练框架)
[] 🎬 Video-BrowseComp: Benchmarking Agentic Video Research on Open Web(Video-BrowseComp:面向开放网络的智能体视频研究基准测试)
[] 🧠 Training AI Co-Scientists Using Rubric Rewards(使用评分标准奖励训练AI科研助手)
[] 🧩 Monadic Context Engineering(单子上下文工程)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟