H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 11 篇论文如下:
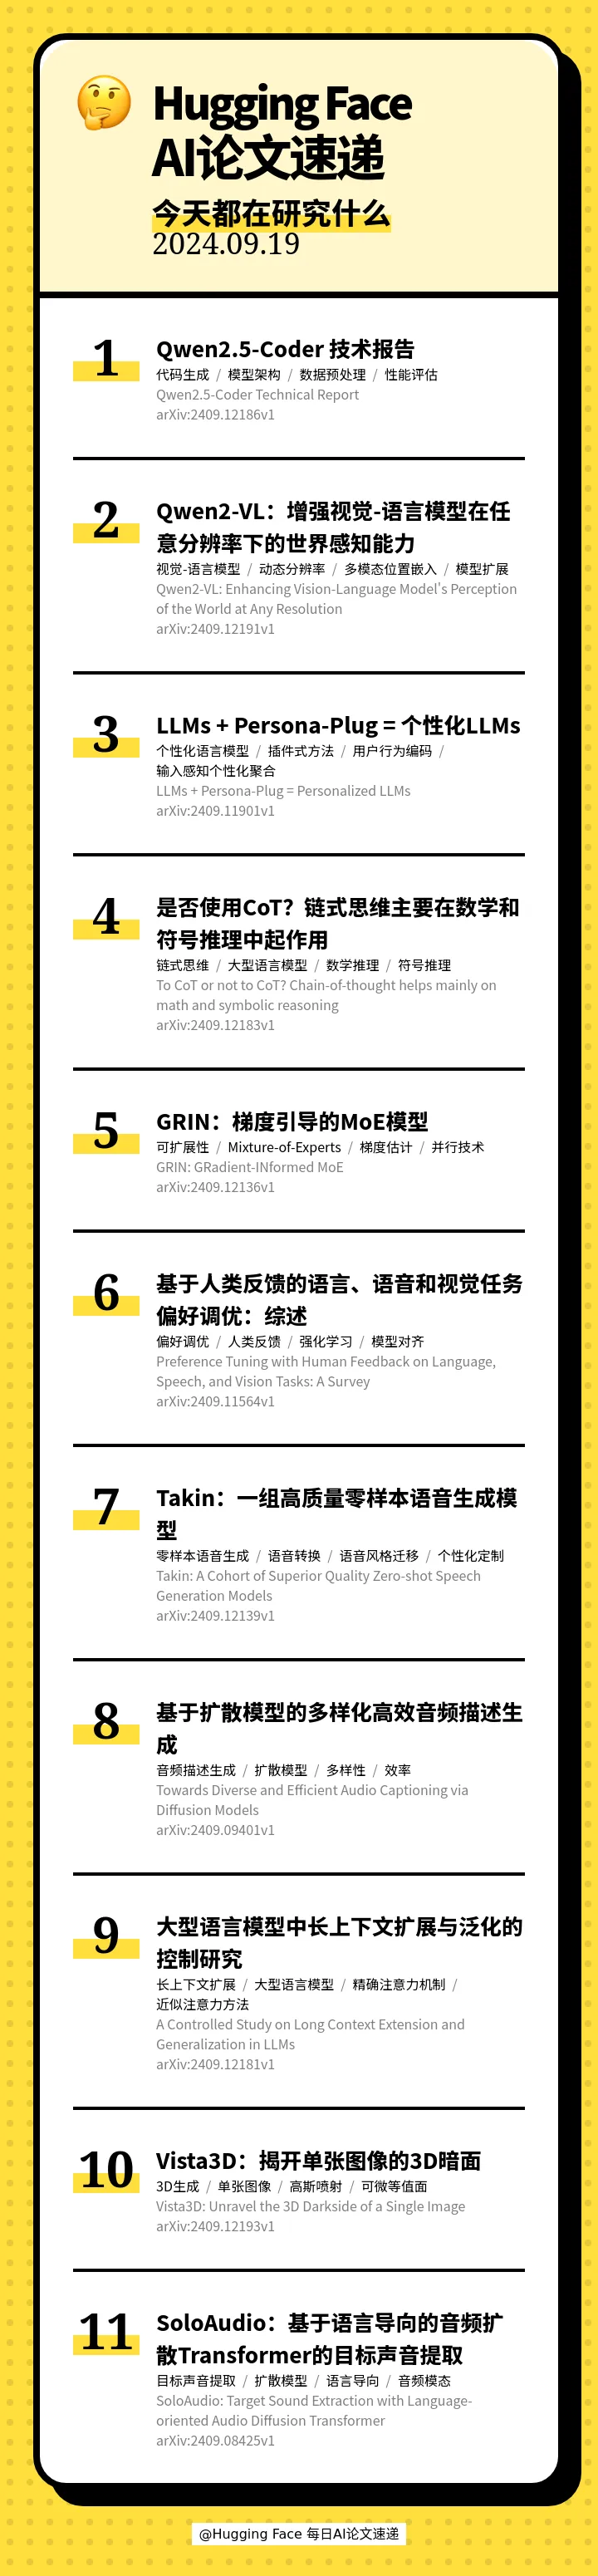
[] 🚀 Qwen2.5-Coder Technical Report(Qwen2.5-Coder 技术报告)
[] 🌍 Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution(Qwen2-VL:增强视觉-语言模型在任意分辨率下的世界感知能力)
[] 🎯 LLMs + Persona-Plug = Personalized LLMs(LLMs + Persona-Plug = 个性化LLMs)
[] 🔍 To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoning(是否使用CoT?链式思维主要在数学和符号推理中起作用)
[] 🌐 GRIN: GRadient-INformed MoE(GRIN:梯度引导的MoE模型)
[] 📚 Preference Tuning with Human Feedback on Language, Speech, and Vision Tasks: A Survey(基于人类反馈的语言、语音和视觉任务偏好调优:综述)
[] 🎙 Takin: A Cohort of Superior Quality Zero-shot Speech Generation Models(Takin:一组高质量零样本语音生成模型)
[] 🎵 Towards Diverse and Efficient Audio Captioning via Diffusion Models(基于扩散模型的多样化高效音频描述生成)
[] 📚 A Controlled Study on Long Context Extension and Generalization in LLMs(大型语言模型中长上下文扩展与泛化的控制研究)
[] 🌌 Vista3D: Unravel the 3D Darkside of a Single Image(Vista3D:揭开单张图像的3D暗面)
[] 🎧 SoloAudio: Target Sound Extraction with Language-oriented Audio Diffusion Transformer(SoloAudio:基于语言导向的音频扩散Transformer的目标声音提取)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2024 年 9 月 20 日 · 8 分钟
本期的 11 篇论文如下:
[] 🚀 Qwen2.5-Coder Technical Report(Qwen2.5-Coder 技术报告)
[] 🌍 Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution(Qwen2-VL:增强视觉-语言模型在任意分辨率下的世界感知能力)
[] 🎯 LLMs + Persona-Plug = Personalized LLMs(LLMs + Persona-Plug = 个性化LLMs)
[] 🔍 To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoning(是否使用CoT?链式思维主要在数学和符号推理中起作用)
[] 🌐 GRIN: GRadient-INformed MoE(GRIN:梯度引导的MoE模型)
[] 📚 Preference Tuning with Human Feedback on Language, Speech, and Vision Tasks: A Survey(基于人类反馈的语言、语音和视觉任务偏好调优:综述)
[] 🎙 Takin: A Cohort of Superior Quality Zero-shot Speech Generation Models(Takin:一组高质量零样本语音生成模型)
[] 🎵 Towards Diverse and Efficient Audio Captioning via Diffusion Models(基于扩散模型的多样化高效音频描述生成)
[] 📚 A Controlled Study on Long Context Extension and Generalization in LLMs(大型语言模型中长上下文扩展与泛化的控制研究)
[] 🌌 Vista3D: Unravel the 3D Darkside of a Single Image(Vista3D:揭开单张图像的3D暗面)
[] 🎧 SoloAudio: Target Sound Extraction with Language-oriented Audio Diffusion Transformer(SoloAudio:基于语言导向的音频扩散Transformer的目标声音提取)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟