H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
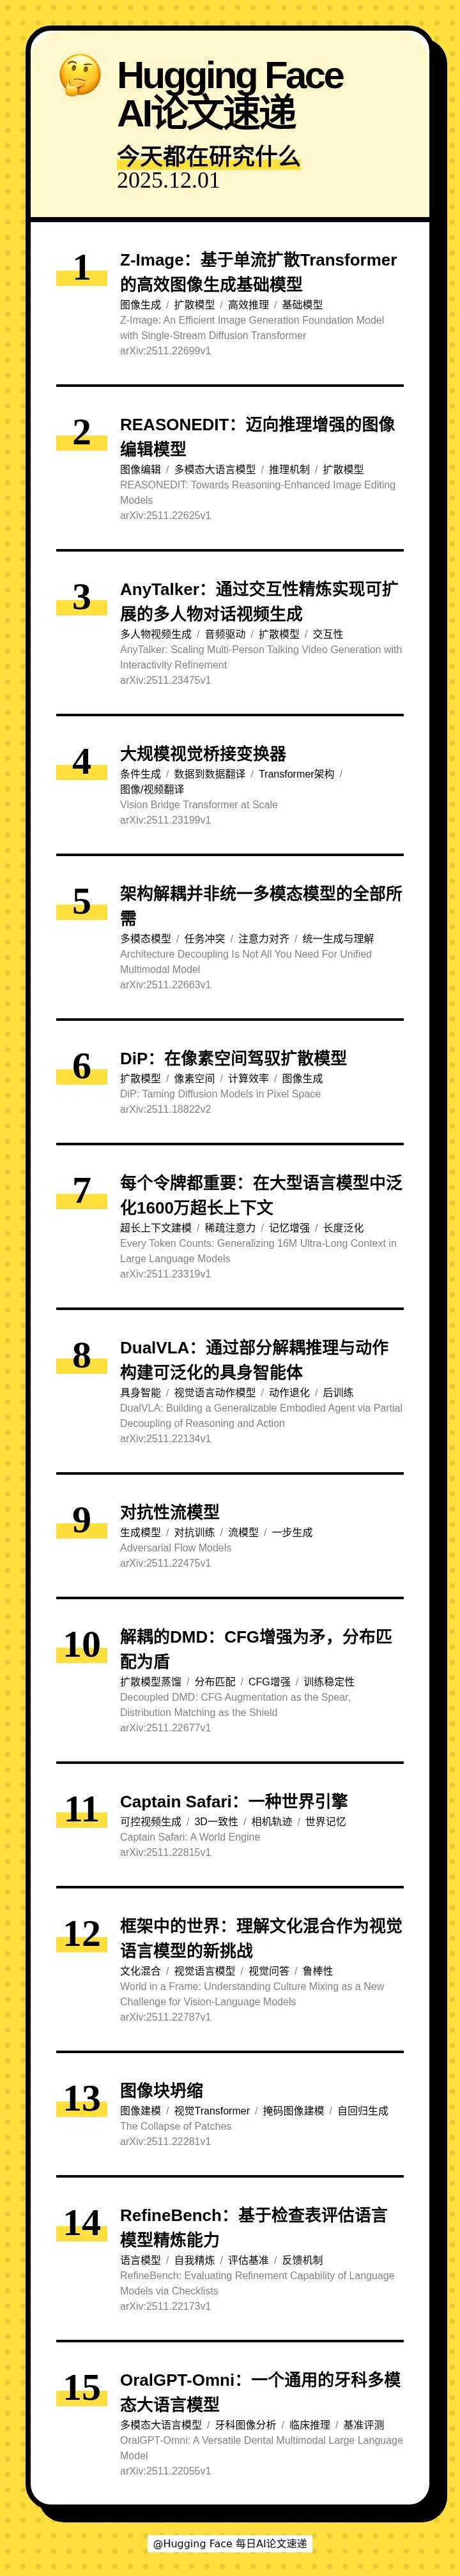
[] 🚀 Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer(Z-Image:基于单流扩散Transformer的高效图像生成基础模型)
[] 🤔 REASONEDIT: Towards Reasoning-Enhanced Image Editing Models(REASONEDIT:迈向推理增强的图像编辑模型)
[] 🎬 AnyTalker: Scaling Multi-Person Talking Video Generation with Interactivity Refinement(AnyTalker:通过交互性精炼实现可扩展的多人物对话视频生成)
[] 🌉 Vision Bridge Transformer at Scale(大规模视觉桥接变换器)
[] 🔍 Architecture Decoupling Is Not All You Need For Unified Multimodal Model(架构解耦并非统一多模态模型的全部所需)
[] ⚡ DiP: Taming Diffusion Models in Pixel Space(DiP:在像素空间驾驭扩散模型)
[] 🧠 Every Token Counts: Generalizing 16M Ultra-Long Context in Large Language Models(每个令牌都重要:在大型语言模型中泛化1600万超长上下文)
[] 🤖 DualVLA: Building a Generalizable Embodied Agent via Partial Decoupling of Reasoning and Action(DualVLA:通过部分解耦推理与动作构建可泛化的具身智能体)
[] ⚡ Adversarial Flow Models(对抗性流模型)
[] 🔬 Decoupled DMD: CFG Augmentation as the Spear, Distribution Matching as the Shield(解耦的DMD:CFG增强为矛,分布匹配为盾)
[] 🎥 Captain Safari: A World Engine(Captain Safari:一种世界引擎)
[] 🌍 World in a Frame: Understanding Culture Mixing as a New Challenge for Vision-Language Models(框架中的世界:理解文化混合作为视觉语言模型的新挑战)
[] 🔍 The Collapse of Patches(图像块坍缩)
[] 🔍 RefineBench: Evaluating Refinement Capability of Language Models via Checklists(RefineBench:基于检查表评估语言模型精炼能力)
[] 🦷 OralGPT-Omni: A Versatile Dental Multimodal Large Language Model(OralGPT-Omni:一个通用的牙科多模态大语言模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 12 月 2 日 · 10 分钟
本期的 15 篇论文如下:
[] 🚀 Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer(Z-Image:基于单流扩散Transformer的高效图像生成基础模型)
[] 🤔 REASONEDIT: Towards Reasoning-Enhanced Image Editing Models(REASONEDIT:迈向推理增强的图像编辑模型)
[] 🎬 AnyTalker: Scaling Multi-Person Talking Video Generation with Interactivity Refinement(AnyTalker:通过交互性精炼实现可扩展的多人物对话视频生成)
[] 🌉 Vision Bridge Transformer at Scale(大规模视觉桥接变换器)
[] 🔍 Architecture Decoupling Is Not All You Need For Unified Multimodal Model(架构解耦并非统一多模态模型的全部所需)
[] ⚡ DiP: Taming Diffusion Models in Pixel Space(DiP:在像素空间驾驭扩散模型)
[] 🧠 Every Token Counts: Generalizing 16M Ultra-Long Context in Large Language Models(每个令牌都重要:在大型语言模型中泛化1600万超长上下文)
[] 🤖 DualVLA: Building a Generalizable Embodied Agent via Partial Decoupling of Reasoning and Action(DualVLA:通过部分解耦推理与动作构建可泛化的具身智能体)
[] ⚡ Adversarial Flow Models(对抗性流模型)
[] 🔬 Decoupled DMD: CFG Augmentation as the Spear, Distribution Matching as the Shield(解耦的DMD:CFG增强为矛,分布匹配为盾)
[] 🎥 Captain Safari: A World Engine(Captain Safari:一种世界引擎)
[] 🌍 World in a Frame: Understanding Culture Mixing as a New Challenge for Vision-Language Models(框架中的世界:理解文化混合作为视觉语言模型的新挑战)
[] 🔍 The Collapse of Patches(图像块坍缩)
[] 🔍 RefineBench: Evaluating Refinement Capability of Language Models via Checklists(RefineBench:基于检查表评估语言模型精炼能力)
[] 🦷 OralGPT-Omni: A Versatile Dental Multimodal Large Language Model(OralGPT-Omni:一个通用的牙科多模态大语言模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟