H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
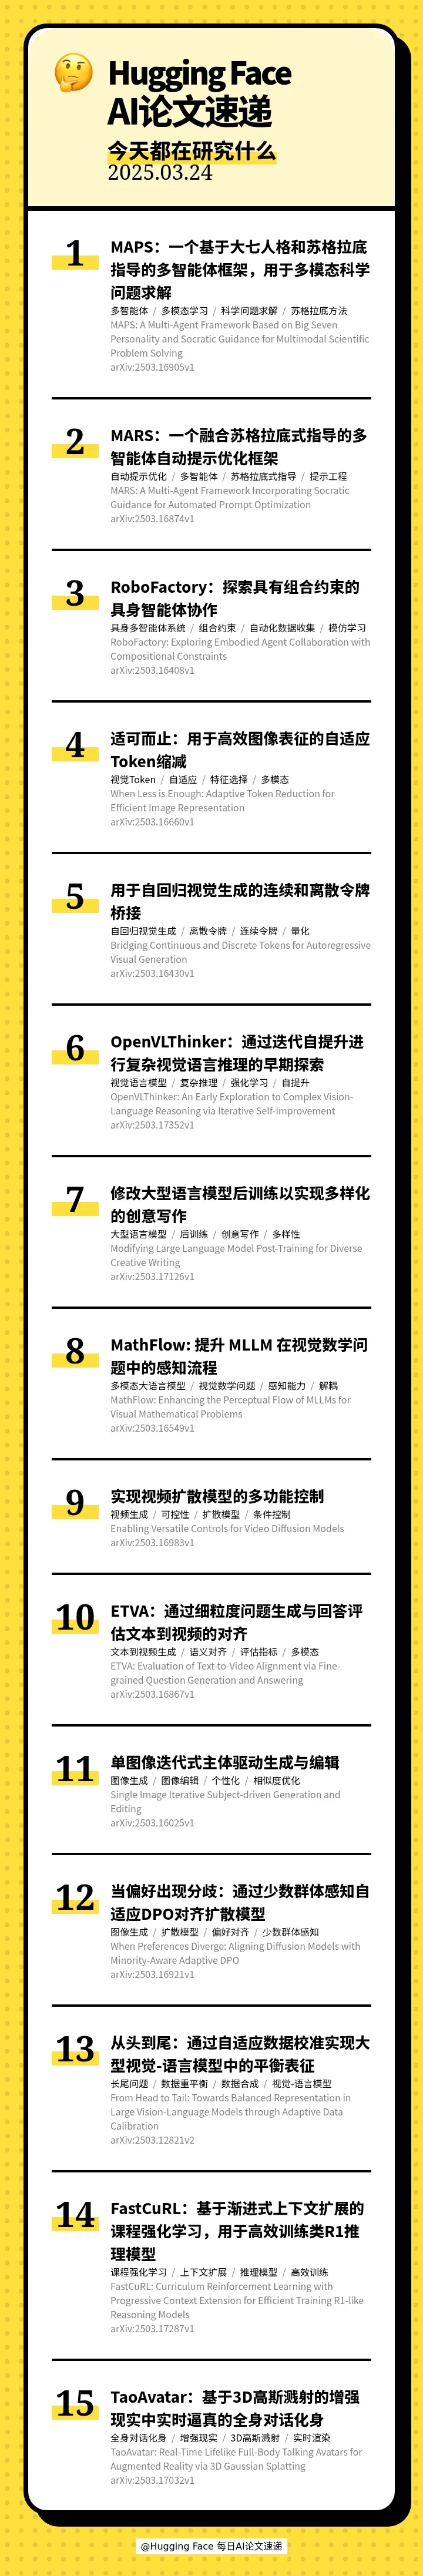
[] 🧠 MAPS: A Multi-Agent Framework Based on Big Seven Personality and Socratic Guidance for Multimodal Scientific Problem Solving(MAPS:一个基于大七人格和苏格拉底指导的多智能体框架,用于多模态科学问题求解)
[] 🤖 MARS: A Multi-Agent Framework Incorporating Socratic Guidance for Automated Prompt Optimization(MARS:一个融合苏格拉底式指导的多智能体自动提示优化框架)
[] 🤖 RoboFactory: Exploring Embodied Agent Collaboration with Compositional Constraints(RoboFactory:探索具有组合约束的具身智能体协作)
[] 🧮 When Less is Enough: Adaptive Token Reduction for Efficient Image Representation(适可而止:用于高效图像表征的自适应Token缩减)
[] 🌉 Bridging Continuous and Discrete Tokens for Autoregressive Visual Generation(用于自回归视觉生成的连续和离散令牌桥接)
[] 🧠 OpenVLThinker: An Early Exploration to Complex Vision-Language Reasoning via Iterative Self-Improvement(OpenVLThinker:通过迭代自提升进行复杂视觉语言推理的早期探索)
[] ✍ Modifying Large Language Model Post-Training for Diverse Creative Writing(修改大型语言模型后训练以实现多样化的创意写作)
[] 🧮 MathFlow: Enhancing the Perceptual Flow of MLLMs for Visual Mathematical Problems(MathFlow: 提升 MLLM 在视觉数学问题中的感知流程)
[] 🎬 Enabling Versatile Controls for Video Diffusion Models(实现视频扩散模型的多功能控制)
[] 🎬 ETVA: Evaluation of Text-to-Video Alignment via Fine-grained Question Generation and Answering(ETVA:通过细粒度问题生成与回答评估文本到视频的对齐)
[] 🖼 Single Image Iterative Subject-driven Generation and Editing(单图像迭代式主体驱动生成与编辑)
[] 🎨 When Preferences Diverge: Aligning Diffusion Models with Minority-Aware Adaptive DPO(当偏好出现分歧:通过少数群体感知自适应DPO对齐扩散模型)
[] ⚖ From Head to Tail: Towards Balanced Representation in Large Vision-Language Models through Adaptive Data Calibration(从头到尾:通过自适应数据校准实现大型视觉-语言模型中的平衡表征)
[] 🚀 FastCuRL: Curriculum Reinforcement Learning with Progressive Context Extension for Efficient Training R1-like Reasoning Models(FastCuRL:基于渐进式上下文扩展的课程强化学习,用于高效训练类R1推理模型)
[] 🗣 TaoAvatar: Real-Time Lifelike Full-Body Talking Avatars for Augmented Reality via 3D Gaussian Splatting(TaoAvatar:基于3D高斯溅射的增强现实中实时逼真的全身对话化身)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 3 月 25 日 · 11 分钟
本期的 15 篇论文如下:
[] 🧠 MAPS: A Multi-Agent Framework Based on Big Seven Personality and Socratic Guidance for Multimodal Scientific Problem Solving(MAPS:一个基于大七人格和苏格拉底指导的多智能体框架,用于多模态科学问题求解)
[] 🤖 MARS: A Multi-Agent Framework Incorporating Socratic Guidance for Automated Prompt Optimization(MARS:一个融合苏格拉底式指导的多智能体自动提示优化框架)
[] 🤖 RoboFactory: Exploring Embodied Agent Collaboration with Compositional Constraints(RoboFactory:探索具有组合约束的具身智能体协作)
[] 🧮 When Less is Enough: Adaptive Token Reduction for Efficient Image Representation(适可而止:用于高效图像表征的自适应Token缩减)
[] 🌉 Bridging Continuous and Discrete Tokens for Autoregressive Visual Generation(用于自回归视觉生成的连续和离散令牌桥接)
[] 🧠 OpenVLThinker: An Early Exploration to Complex Vision-Language Reasoning via Iterative Self-Improvement(OpenVLThinker:通过迭代自提升进行复杂视觉语言推理的早期探索)
[] ✍ Modifying Large Language Model Post-Training for Diverse Creative Writing(修改大型语言模型后训练以实现多样化的创意写作)
[] 🧮 MathFlow: Enhancing the Perceptual Flow of MLLMs for Visual Mathematical Problems(MathFlow: 提升 MLLM 在视觉数学问题中的感知流程)
[] 🎬 Enabling Versatile Controls for Video Diffusion Models(实现视频扩散模型的多功能控制)
[] 🎬 ETVA: Evaluation of Text-to-Video Alignment via Fine-grained Question Generation and Answering(ETVA:通过细粒度问题生成与回答评估文本到视频的对齐)
[] 🖼 Single Image Iterative Subject-driven Generation and Editing(单图像迭代式主体驱动生成与编辑)
[] 🎨 When Preferences Diverge: Aligning Diffusion Models with Minority-Aware Adaptive DPO(当偏好出现分歧:通过少数群体感知自适应DPO对齐扩散模型)
[] ⚖ From Head to Tail: Towards Balanced Representation in Large Vision-Language Models through Adaptive Data Calibration(从头到尾:通过自适应数据校准实现大型视觉-语言模型中的平衡表征)
[] 🚀 FastCuRL: Curriculum Reinforcement Learning with Progressive Context Extension for Efficient Training R1-like Reasoning Models(FastCuRL:基于渐进式上下文扩展的课程强化学习,用于高效训练类R1推理模型)
[] 🗣 TaoAvatar: Real-Time Lifelike Full-Body Talking Avatars for Augmented Reality via 3D Gaussian Splatting(TaoAvatar:基于3D高斯溅射的增强现实中实时逼真的全身对话化身)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟