H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
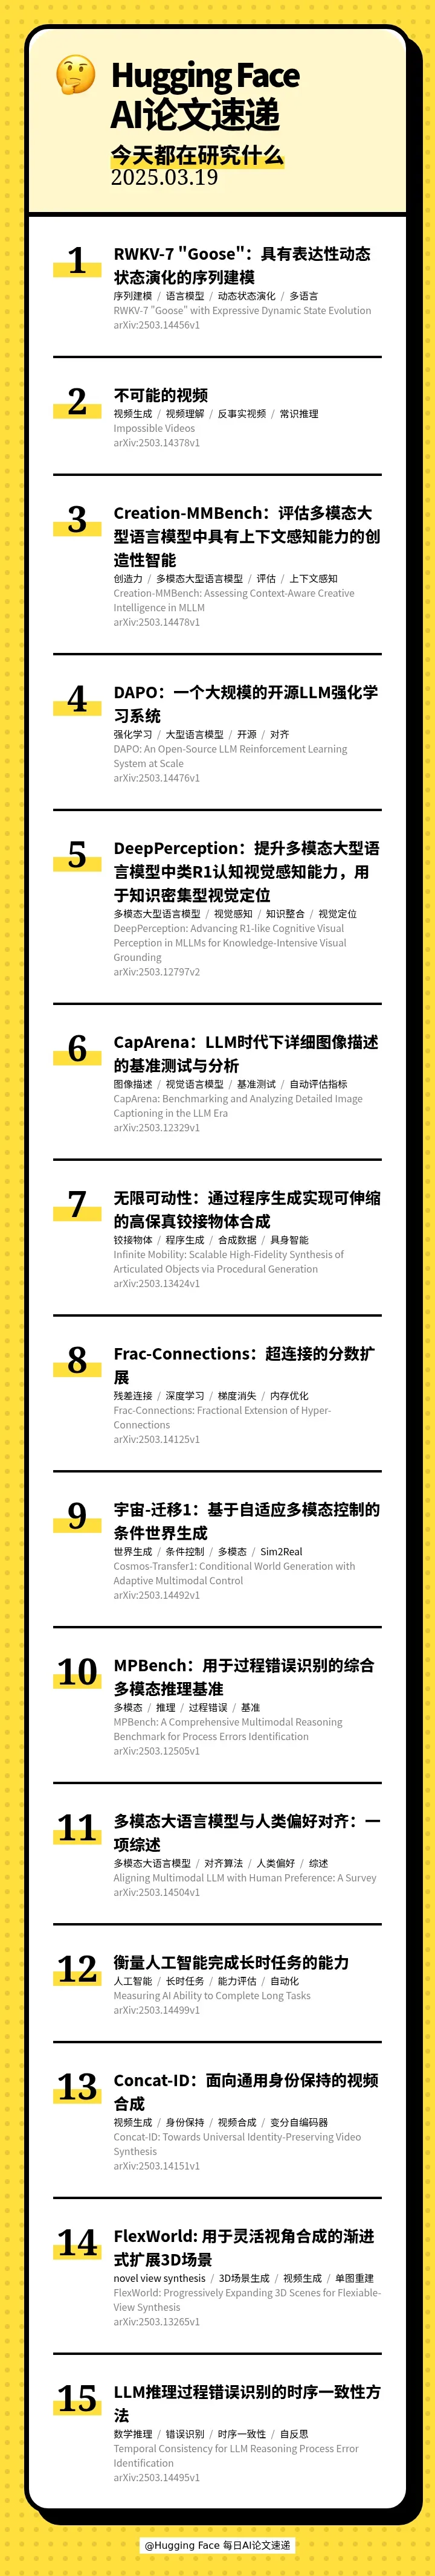
[] 🦢 RWKV-7 "Goose" with Expressive Dynamic State Evolution(RWKV-7 "Goose":具有表达性动态状态演化的序列建模)
[] 🤯 Impossible Videos(不可能的视频)
[] 🎨 Creation-MMBench: Assessing Context-Aware Creative Intelligence in MLLM(Creation-MMBench:评估多模态大型语言模型中具有上下文感知能力的创造性智能)
[] 🤖 DAPO: An Open-Source LLM Reinforcement Learning System at Scale(DAPO:一个大规模的开源LLM强化学习系统)
[] 🧠 DeepPerception: Advancing R1-like Cognitive Visual Perception in MLLMs for Knowledge-Intensive Visual Grounding(DeepPerception:提升多模态大型语言模型中类R1认知视觉感知能力,用于知识密集型视觉定位)
[] 🖼 CapArena: Benchmarking and Analyzing Detailed Image Captioning in the LLM Era(CapArena:LLM时代下详细图像描述的基准测试与分析)
[] 🤖 Infinite Mobility: Scalable High-Fidelity Synthesis of Articulated Objects via Procedural Generation(无限可动性:通过程序生成实现可伸缩的高保真铰接物体合成)
[] 🧠 Frac-Connections: Fractional Extension of Hyper-Connections(Frac-Connections:超连接的分数扩展)
[] 🌍 Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control(宇宙-迁移1:基于自适应多模态控制的条件世界生成)
[] 🧐 MPBench: A Comprehensive Multimodal Reasoning Benchmark for Process Errors Identification(MPBench:用于过程错误识别的综合多模态推理基准)
[] 🤖 Aligning Multimodal LLM with Human Preference: A Survey(多模态大语言模型与人类偏好对齐:一项综述)
[] ⏱ Measuring AI Ability to Complete Long Tasks(衡量人工智能完成长时任务的能力)
[] 🎭 Concat-ID: Towards Universal Identity-Preserving Video Synthesis(Concat-ID:面向通用身份保持的视频合成)
[] 🖼 FlexWorld: Progressively Expanding 3D Scenes for Flexiable-View Synthesis(FlexWorld: 用于灵活视角合成的渐进式扩展3D场景)
[] 🤔 Temporal Consistency for LLM Reasoning Process Error Identification(LLM推理过程错误识别的时序一致性方法)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 3 月 20 日 · 11 分钟
本期的 15 篇论文如下:
[] 🦢 RWKV-7 "Goose" with Expressive Dynamic State Evolution(RWKV-7 "Goose":具有表达性动态状态演化的序列建模)
[] 🤯 Impossible Videos(不可能的视频)
[] 🎨 Creation-MMBench: Assessing Context-Aware Creative Intelligence in MLLM(Creation-MMBench:评估多模态大型语言模型中具有上下文感知能力的创造性智能)
[] 🤖 DAPO: An Open-Source LLM Reinforcement Learning System at Scale(DAPO:一个大规模的开源LLM强化学习系统)
[] 🧠 DeepPerception: Advancing R1-like Cognitive Visual Perception in MLLMs for Knowledge-Intensive Visual Grounding(DeepPerception:提升多模态大型语言模型中类R1认知视觉感知能力,用于知识密集型视觉定位)
[] 🖼 CapArena: Benchmarking and Analyzing Detailed Image Captioning in the LLM Era(CapArena:LLM时代下详细图像描述的基准测试与分析)
[] 🤖 Infinite Mobility: Scalable High-Fidelity Synthesis of Articulated Objects via Procedural Generation(无限可动性:通过程序生成实现可伸缩的高保真铰接物体合成)
[] 🧠 Frac-Connections: Fractional Extension of Hyper-Connections(Frac-Connections:超连接的分数扩展)
[] 🌍 Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control(宇宙-迁移1:基于自适应多模态控制的条件世界生成)
[] 🧐 MPBench: A Comprehensive Multimodal Reasoning Benchmark for Process Errors Identification(MPBench:用于过程错误识别的综合多模态推理基准)
[] 🤖 Aligning Multimodal LLM with Human Preference: A Survey(多模态大语言模型与人类偏好对齐:一项综述)
[] ⏱ Measuring AI Ability to Complete Long Tasks(衡量人工智能完成长时任务的能力)
[] 🎭 Concat-ID: Towards Universal Identity-Preserving Video Synthesis(Concat-ID:面向通用身份保持的视频合成)
[] 🖼 FlexWorld: Progressively Expanding 3D Scenes for Flexiable-View Synthesis(FlexWorld: 用于灵活视角合成的渐进式扩展3D场景)
[] 🤔 Temporal Consistency for LLM Reasoning Process Error Identification(LLM推理过程错误识别的时序一致性方法)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟