H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

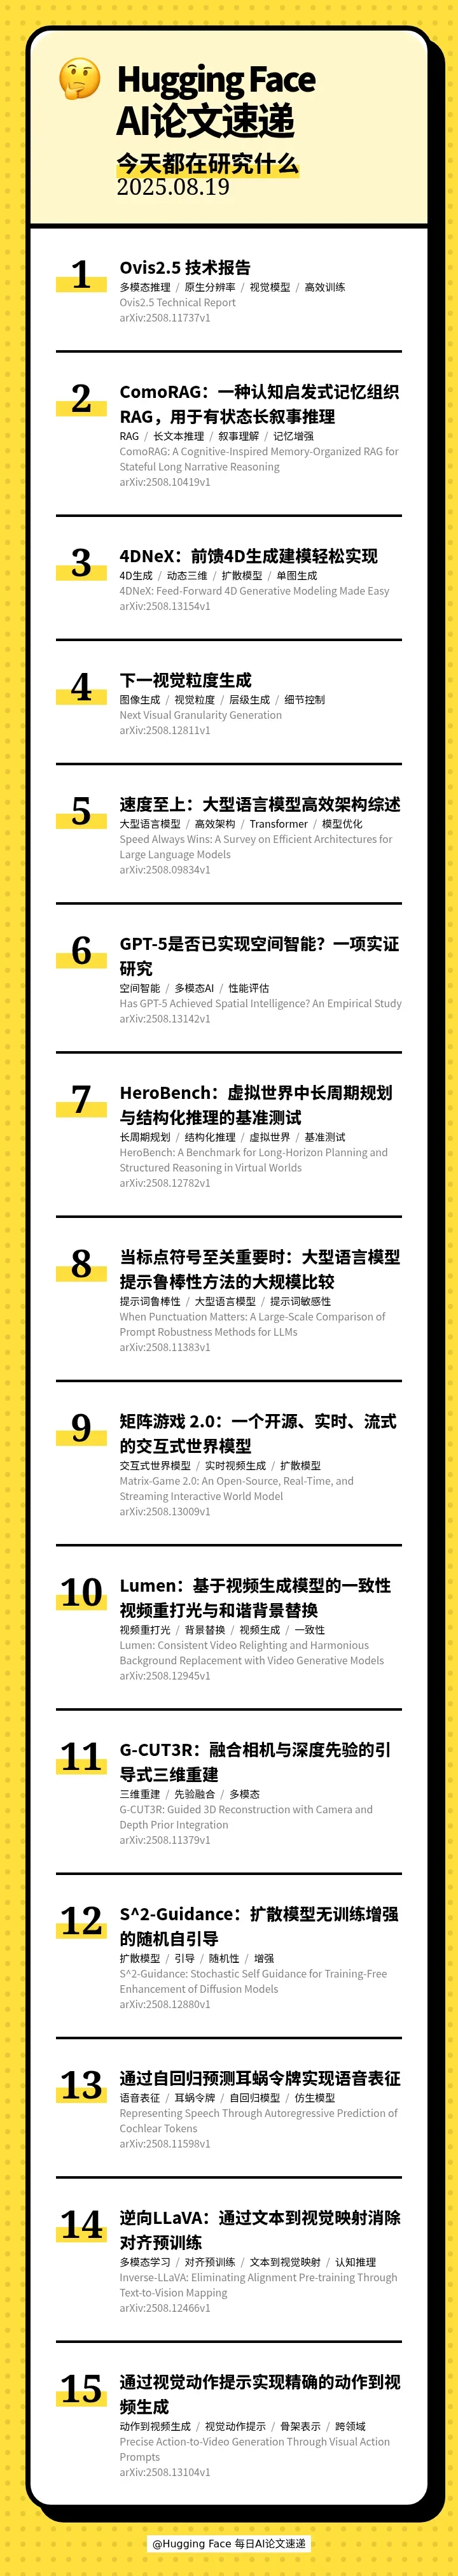
本期的 15 篇论文如下:
[] ✨ Ovis2.5 Technical Report(Ovis2.5 技术报告)
[] 🧠 ComoRAG: A Cognitive-Inspired Memory-Organized RAG for Stateful Long Narrative Reasoning(ComoRAG:一种认知启发式记忆组织RAG,用于有状态长叙事推理)
[] 🎥 4DNeX: Feed-Forward 4D Generative Modeling Made Easy(4DNeX:前馈4D生成建模轻松实现)
[] ✨ Next Visual Granularity Generation(下一视觉粒度生成)
[] ⚡ Speed Always Wins: A Survey on Efficient Architectures for Large Language Models(速度至上:大型语言模型高效架构综述)
[] 🤔 Has GPT-5 Achieved Spatial Intelligence? An Empirical Study(GPT-5是否已实现空间智能?一项实证研究)
[] 🎮 HeroBench: A Benchmark for Long-Horizon Planning and Structured Reasoning in Virtual Worlds(HeroBench:虚拟世界中长周期规划与结构化推理的基准测试)
[] ❗ When Punctuation Matters: A Large-Scale Comparison of Prompt Robustness Methods for LLMs(当标点符号至关重要时:大型语言模型提示鲁棒性方法的大规模比较)
[] 🎮 Matrix-Game 2.0: An Open-Source, Real-Time, and Streaming Interactive World Model(矩阵游戏 2.0:一个开源、实时、流式的交互式世界模型)
[] 💡 Lumen: Consistent Video Relighting and Harmonious Background Replacement with Video Generative Models(Lumen:基于视频生成模型的一致性视频重打光与和谐背景替换)
[] 🌐 G-CUT3R: Guided 3D Reconstruction with Camera and Depth Prior Integration(G-CUT3R:融合相机与深度先验的引导式三维重建)
[] ✨ S^2-Guidance: Stochastic Self Guidance for Training-Free Enhancement of Diffusion Models(S^2-Guidance:扩散模型无训练增强的随机自引导)
[] 👂 Representing Speech Through Autoregressive Prediction of Cochlear Tokens(通过自回归预测耳蜗令牌实现语音表征)
[] 💡 Inverse-LLaVA: Eliminating Alignment Pre-training Through Text-to-Vision Mapping(逆向LLaVA:通过文本到视觉映射消除对齐预训练)
[] 🎬 Precise Action-to-Video Generation Through Visual Action Prompts(通过视觉动作提示实现精确的动作到视频生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 8 月 20 日 · 8 分钟
本期的 15 篇论文如下:
[] ✨ Ovis2.5 Technical Report(Ovis2.5 技术报告)
[] 🧠 ComoRAG: A Cognitive-Inspired Memory-Organized RAG for Stateful Long Narrative Reasoning(ComoRAG:一种认知启发式记忆组织RAG,用于有状态长叙事推理)
[] 🎥 4DNeX: Feed-Forward 4D Generative Modeling Made Easy(4DNeX:前馈4D生成建模轻松实现)
[] ✨ Next Visual Granularity Generation(下一视觉粒度生成)
[] ⚡ Speed Always Wins: A Survey on Efficient Architectures for Large Language Models(速度至上:大型语言模型高效架构综述)
[] 🤔 Has GPT-5 Achieved Spatial Intelligence? An Empirical Study(GPT-5是否已实现空间智能?一项实证研究)
[] 🎮 HeroBench: A Benchmark for Long-Horizon Planning and Structured Reasoning in Virtual Worlds(HeroBench:虚拟世界中长周期规划与结构化推理的基准测试)
[] ❗ When Punctuation Matters: A Large-Scale Comparison of Prompt Robustness Methods for LLMs(当标点符号至关重要时:大型语言模型提示鲁棒性方法的大规模比较)
[] 🎮 Matrix-Game 2.0: An Open-Source, Real-Time, and Streaming Interactive World Model(矩阵游戏 2.0:一个开源、实时、流式的交互式世界模型)
[] 💡 Lumen: Consistent Video Relighting and Harmonious Background Replacement with Video Generative Models(Lumen:基于视频生成模型的一致性视频重打光与和谐背景替换)
[] 🌐 G-CUT3R: Guided 3D Reconstruction with Camera and Depth Prior Integration(G-CUT3R:融合相机与深度先验的引导式三维重建)
[] ✨ S^2-Guidance: Stochastic Self Guidance for Training-Free Enhancement of Diffusion Models(S^2-Guidance:扩散模型无训练增强的随机自引导)
[] 👂 Representing Speech Through Autoregressive Prediction of Cochlear Tokens(通过自回归预测耳蜗令牌实现语音表征)
[] 💡 Inverse-LLaVA: Eliminating Alignment Pre-training Through Text-to-Vision Mapping(逆向LLaVA:通过文本到视觉映射消除对齐预训练)
[] 🎬 Precise Action-to-Video Generation Through Visual Action Prompts(通过视觉动作提示实现精确的动作到视频生成)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟