H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
本期的 10 篇论文如下:
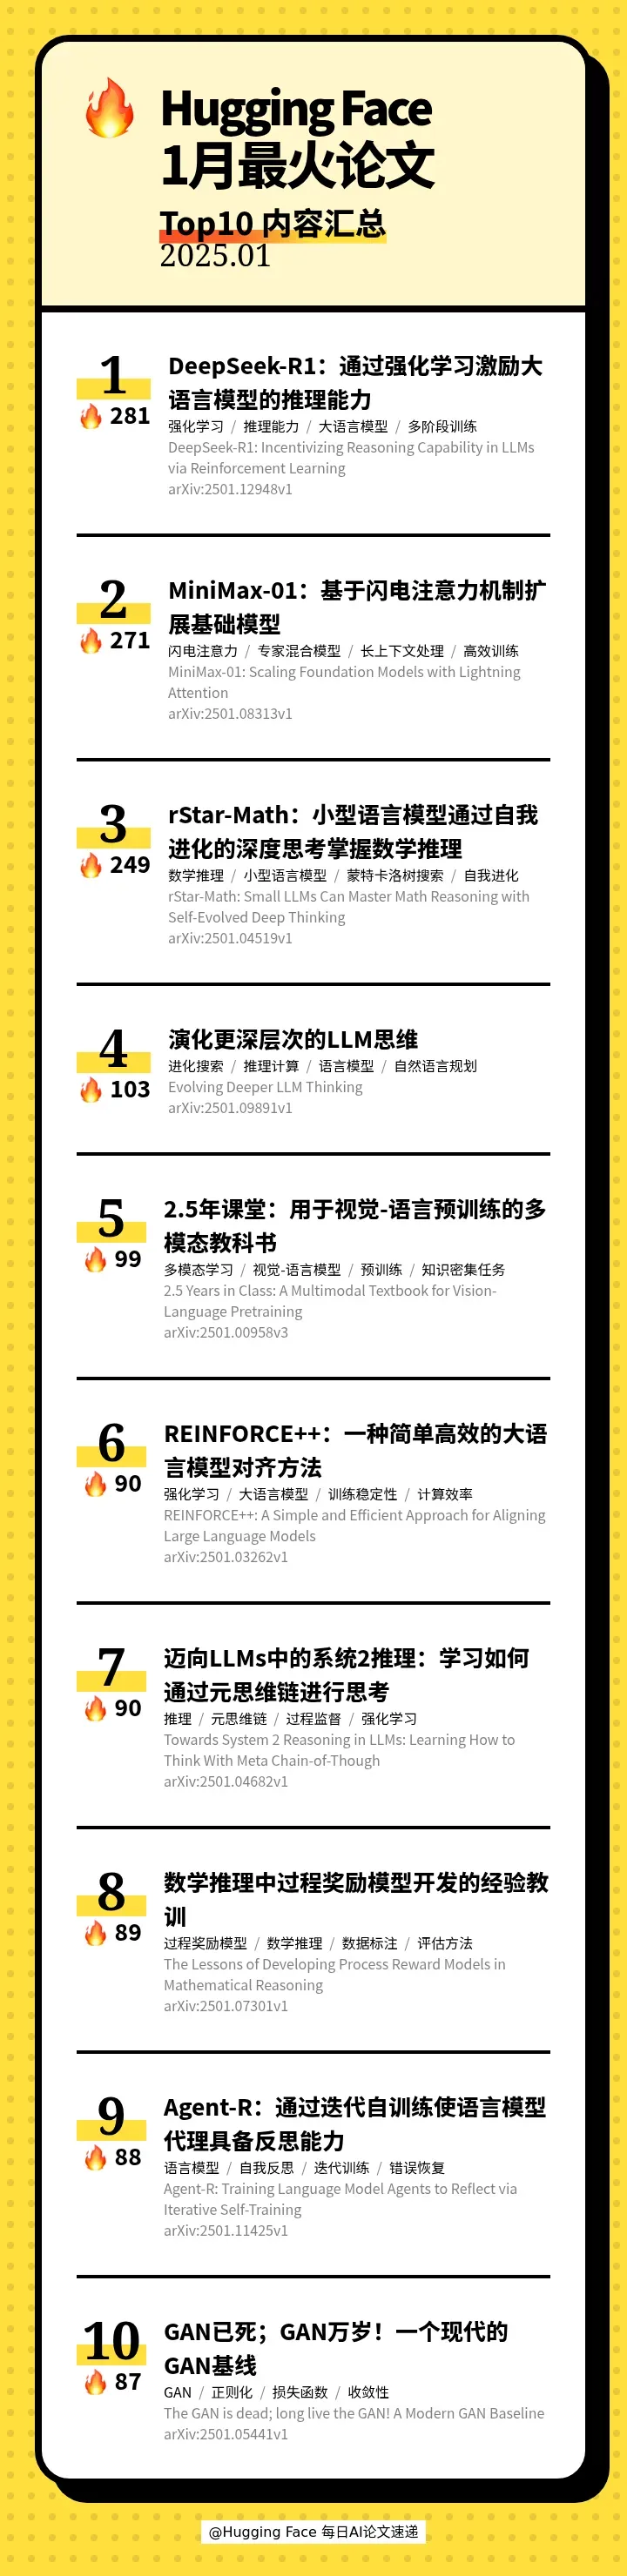
[] TOP1(🔥281) | 🧠 DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(DeepSeek-R1:通过强化学习激励大语言模型的推理能力)
[] TOP2(🔥271) | ⚡ MiniMax-01: Scaling Foundation Models with Lightning Attention(MiniMax-01:基于闪电注意力机制扩展基础模型)
[] TOP3(🔥249) | 🧠 rStar-Math: Small LLMs Can Master Math Reasoning with Self-Evolved Deep Thinking(rStar-Math:小型语言模型通过自我进化的深度思考掌握数学推理)
[] TOP4(🔥103) | 🧠 Evolving Deeper LLM Thinking(演化更深层次的LLM思维)
[] TOP5(🔥99) | 📚 2.5 Years in Class: A Multimodal Textbook for Vision-Language Pretraining(2.5年课堂:用于视觉-语言预训练的多模态教科书)
[] TOP6(🔥90) | 🚀 REINFORCE++: A Simple and Efficient Approach for Aligning Large Language Models(REINFORCE++:一种简单高效的大语言模型对齐方法)
[] TOP7(🔥90) | 🧠 Towards System 2 Reasoning in LLMs: Learning How to Think With Meta Chain-of-Though(迈向LLMs中的系统2推理:学习如何通过元思维链进行思考)
[] TOP8(🔥89) | 📊 The Lessons of Developing Process Reward Models in Mathematical Reasoning(数学推理中过程奖励模型开发的经验教训)
[] TOP9(🔥88) | 🤔 Agent-R: Training Language Model Agents to Reflect via Iterative Self-Training(Agent-R:通过迭代自训练使语言模型代理具备反思能力)
[] TOP10(🔥87) | 🧠 The GAN is dead; long live the GAN! A Modern GAN Baseline(GAN已死;GAN万岁!一个现代的GAN基线)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟
HuggingFace 每日AI论文速递 · 2025 年 2 月 3 日 · 24 分钟
本期的 10 篇论文如下:
[] TOP1(🔥281) | 🧠 DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(DeepSeek-R1:通过强化学习激励大语言模型的推理能力)
[] TOP2(🔥271) | ⚡ MiniMax-01: Scaling Foundation Models with Lightning Attention(MiniMax-01:基于闪电注意力机制扩展基础模型)
[] TOP3(🔥249) | 🧠 rStar-Math: Small LLMs Can Master Math Reasoning with Self-Evolved Deep Thinking(rStar-Math:小型语言模型通过自我进化的深度思考掌握数学推理)
[] TOP4(🔥103) | 🧠 Evolving Deeper LLM Thinking(演化更深层次的LLM思维)
[] TOP5(🔥99) | 📚 2.5 Years in Class: A Multimodal Textbook for Vision-Language Pretraining(2.5年课堂:用于视觉-语言预训练的多模态教科书)
[] TOP6(🔥90) | 🚀 REINFORCE++: A Simple and Efficient Approach for Aligning Large Language Models(REINFORCE++:一种简单高效的大语言模型对齐方法)
[] TOP7(🔥90) | 🧠 Towards System 2 Reasoning in LLMs: Learning How to Think With Meta Chain-of-Though(迈向LLMs中的系统2推理:学习如何通过元思维链进行思考)
[] TOP8(🔥89) | 📊 The Lessons of Developing Process Reward Models in Mathematical Reasoning(数学推理中过程奖励模型开发的经验教训)
[] TOP9(🔥88) | 🤔 Agent-R: Training Language Model Agents to Reflect via Iterative Self-Training(Agent-R:通过迭代自训练使语言模型代理具备反思能力)
[] TOP10(🔥87) | 🧠 The GAN is dead; long live the GAN! A Modern GAN Baseline(GAN已死;GAN万岁!一个现代的GAN基线)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟