H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
[] 🔍 $φ$-Decoding: Adaptive Foresight Sampling for Balanced Inference-Time Exploration and Exploitation($\phi$-解码:用于平衡推理时探索与利用的自适应前瞻采样)
[] 🎨 DeepMesh: Auto-Regressive Artist-mesh Creation with Reinforcement Learning(DeepMesh:基于强化学习的自回归艺术家网格创建)
[] 🌷 TULIP: Towards Unified Language-Image Pretraining(TULIP:迈向统一的语言-图像预训练)
[] 🤖 Cube: A Roblox View of 3D Intelligence(Cube:Roblox 视角下的 3D 智能)
[] 📱 Efficient Personalization of Quantized Diffusion Model without Backpropagation(无需反向传播的量化扩散模型高效个性化)
[] 🎬 Temporal Regularization Makes Your Video Generator Stronger(时间正则化使你的视频生成器更强大)
[] 🤖 STEVE: AStep Verification Pipeline for Computer-use Agent Training(STEVE:用于计算机使用代理训练的步骤验证管道)
[] 🖼 LEGION: Learning to Ground and Explain for Synthetic Image Detection(LEGION:学习定位与解释以用于合成图像检测)
[] 🎶 MusicInfuser: Making Video Diffusion Listen and Dance(MusicInfuser:让视频扩散模型聆听与舞动)
[] 👋 ViSpeak: Visual Instruction Feedback in Streaming Videos(ViSpeak:流视频中的视觉指令反馈)
[] 🧠 GKG-LLM: A Unified Framework for Generalized Knowledge Graph Construction(GKG-LLM:一个用于广义知识图谱构建的统一框架)
[] 👁 Mitigating Visual Forgetting via Take-along Visual Conditioning for Multi-modal Long CoT Reasoning(通过随身携带的视觉条件反射缓解多模态长链思维推理中的视觉遗忘)
[] 🗣 Unlock Pose Diversity: Accurate and Efficient Implicit Keypoint-based Spatiotemporal Diffusion for Audio-driven Talking Portrait(解锁姿态多样性:用于音频驱动的说话人像的精确高效的基于隐式关键点的时空扩散)
[] 🤖 ELTEX: A Framework for Domain-Driven Synthetic Data Generation(ELTEX:一种领域驱动的合成数据生成框架)
[] 🧪 CURIE: Evaluating LLMs On Multitask Scientific Long Context Understanding and Reasoning(CURIE:评估大型语言模型在多任务科学长文本理解与推理方面的能力)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 3 月 21 日 · 11 分钟
本期的 15 篇论文如下:
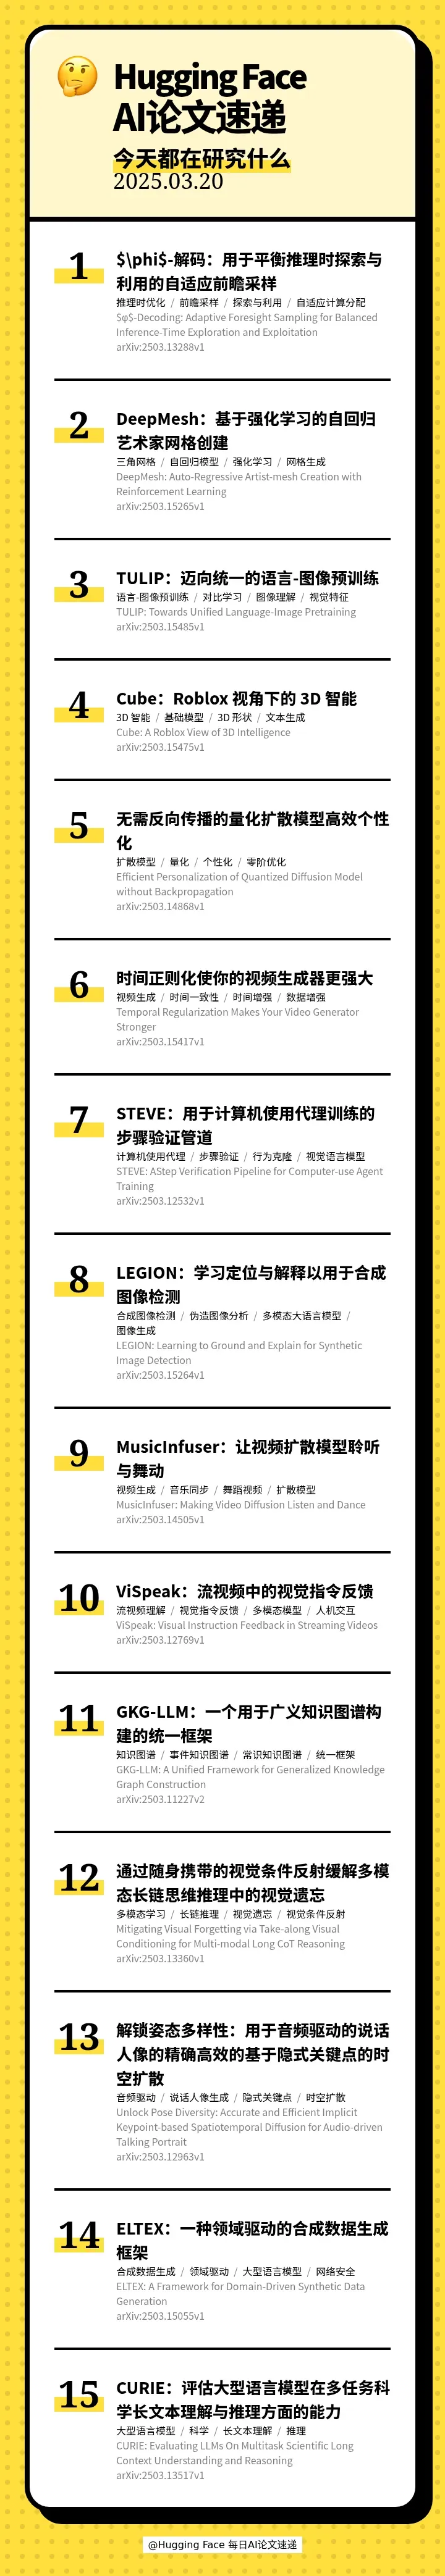
[] 🔍 $φ$-Decoding: Adaptive Foresight Sampling for Balanced Inference-Time Exploration and Exploitation($\phi$-解码:用于平衡推理时探索与利用的自适应前瞻采样)
[] 🎨 DeepMesh: Auto-Regressive Artist-mesh Creation with Reinforcement Learning(DeepMesh:基于强化学习的自回归艺术家网格创建)
[] 🌷 TULIP: Towards Unified Language-Image Pretraining(TULIP:迈向统一的语言-图像预训练)
[] 🤖 Cube: A Roblox View of 3D Intelligence(Cube:Roblox 视角下的 3D 智能)
[] 📱 Efficient Personalization of Quantized Diffusion Model without Backpropagation(无需反向传播的量化扩散模型高效个性化)
[] 🎬 Temporal Regularization Makes Your Video Generator Stronger(时间正则化使你的视频生成器更强大)
[] 🤖 STEVE: AStep Verification Pipeline for Computer-use Agent Training(STEVE:用于计算机使用代理训练的步骤验证管道)
[] 🖼 LEGION: Learning to Ground and Explain for Synthetic Image Detection(LEGION:学习定位与解释以用于合成图像检测)
[] 🎶 MusicInfuser: Making Video Diffusion Listen and Dance(MusicInfuser:让视频扩散模型聆听与舞动)
[] 👋 ViSpeak: Visual Instruction Feedback in Streaming Videos(ViSpeak:流视频中的视觉指令反馈)
[] 🧠 GKG-LLM: A Unified Framework for Generalized Knowledge Graph Construction(GKG-LLM:一个用于广义知识图谱构建的统一框架)
[] 👁 Mitigating Visual Forgetting via Take-along Visual Conditioning for Multi-modal Long CoT Reasoning(通过随身携带的视觉条件反射缓解多模态长链思维推理中的视觉遗忘)
[] 🗣 Unlock Pose Diversity: Accurate and Efficient Implicit Keypoint-based Spatiotemporal Diffusion for Audio-driven Talking Portrait(解锁姿态多样性:用于音频驱动的说话人像的精确高效的基于隐式关键点的时空扩散)
[] 🤖 ELTEX: A Framework for Domain-Driven Synthetic Data Generation(ELTEX:一种领域驱动的合成数据生成框架)
[] 🧪 CURIE: Evaluating LLMs On Multitask Scientific Long Context Understanding and Reasoning(CURIE:评估大型语言模型在多任务科学长文本理解与推理方面的能力)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟