H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
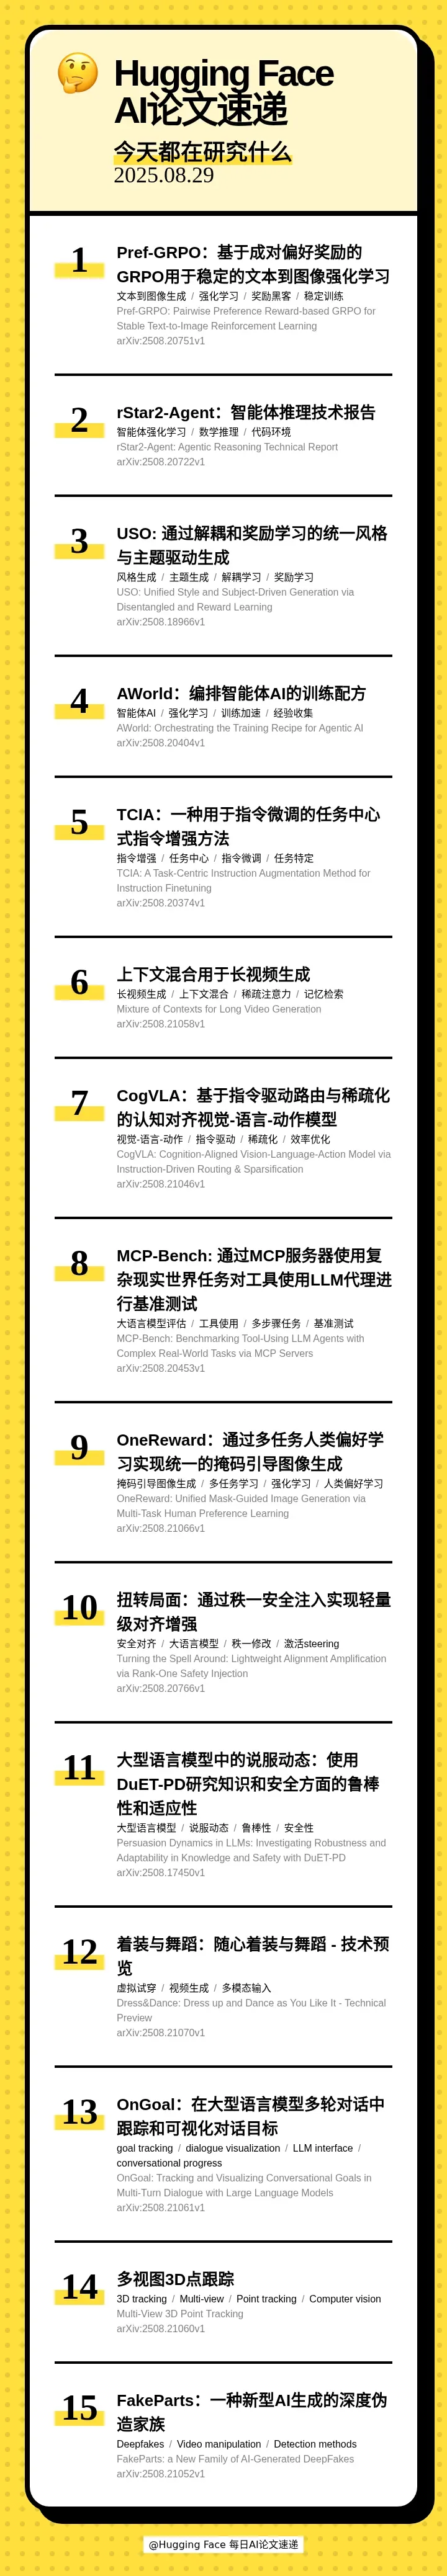
[] ⚖ Pref-GRPO: Pairwise Preference Reward-based GRPO for Stable Text-to-Image Reinforcement Learning(Pref-GRPO:基于成对偏好奖励的GRPO用于稳定的文本到图像强化学习)
[] 🧠 rStar2-Agent: Agentic Reasoning Technical Report(rStar2-Agent:智能体推理技术报告)
[] 🎨 USO: Unified Style and Subject-Driven Generation via Disentangled and Reward Learning(USO: 通过解耦和奖励学习的统一风格与主题驱动生成)
[] 🚀 AWorld: Orchestrating the Training Recipe for Agentic AI(AWorld:编排智能体AI的训练配方)
[] 🎯 TCIA: A Task-Centric Instruction Augmentation Method for Instruction Finetuning(TCIA:一种用于指令微调的任务中心式指令增强方法)
[] 🧠 Mixture of Contexts for Long Video Generation(上下文混合用于长视频生成)
[] 🧠 CogVLA: Cognition-Aligned Vision-Language-Action Model via Instruction-Driven Routing & Sparsification(CogVLA:基于指令驱动路由与稀疏化的认知对齐视觉-语言-动作模型)
[] 🔍 MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers(MCP-Bench: 通过MCP服务器使用复杂现实世界任务对工具使用LLM代理进行基准测试)
[] 🎨 OneReward: Unified Mask-Guided Image Generation via Multi-Task Human Preference Learning(OneReward:通过多任务人类偏好学习实现统一的掩码引导图像生成)
[] 🛡 Turning the Spell Around: Lightweight Alignment Amplification via Rank-One Safety Injection(扭转局面:通过秩一安全注入实现轻量级对齐增强)
[] 🧠 Persuasion Dynamics in LLMs: Investigating Robustness and Adaptability in Knowledge and Safety with DuET-PD(大型语言模型中的说服动态:使用DuET-PD研究知识和安全方面的鲁棒性和适应性)
[] 💃 Dress&Dance: Dress up and Dance as You Like It - Technical Preview(着装与舞蹈:随心着装与舞蹈 - 技术预览)
[] 🎯 OnGoal: Tracking and Visualizing Conversational Goals in Multi-Turn Dialogue with Large Language Models(OnGoal:在大型语言模型多轮对话中跟踪和可视化对话目标)
[] 📷 Multi-View 3D Point Tracking(多视图3D点跟踪)
[] 🎭 FakeParts: a New Family of AI-Generated DeepFakes(FakeParts:一种新型AI生成的深度伪造家族)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 8 月 30 日 · 8 分钟
本期的 15 篇论文如下:
[] ⚖ Pref-GRPO: Pairwise Preference Reward-based GRPO for Stable Text-to-Image Reinforcement Learning(Pref-GRPO:基于成对偏好奖励的GRPO用于稳定的文本到图像强化学习)
[] 🧠 rStar2-Agent: Agentic Reasoning Technical Report(rStar2-Agent:智能体推理技术报告)
[] 🎨 USO: Unified Style and Subject-Driven Generation via Disentangled and Reward Learning(USO: 通过解耦和奖励学习的统一风格与主题驱动生成)
[] 🚀 AWorld: Orchestrating the Training Recipe for Agentic AI(AWorld:编排智能体AI的训练配方)
[] 🎯 TCIA: A Task-Centric Instruction Augmentation Method for Instruction Finetuning(TCIA:一种用于指令微调的任务中心式指令增强方法)
[] 🧠 Mixture of Contexts for Long Video Generation(上下文混合用于长视频生成)
[] 🧠 CogVLA: Cognition-Aligned Vision-Language-Action Model via Instruction-Driven Routing & Sparsification(CogVLA:基于指令驱动路由与稀疏化的认知对齐视觉-语言-动作模型)
[] 🔍 MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers(MCP-Bench: 通过MCP服务器使用复杂现实世界任务对工具使用LLM代理进行基准测试)
[] 🎨 OneReward: Unified Mask-Guided Image Generation via Multi-Task Human Preference Learning(OneReward:通过多任务人类偏好学习实现统一的掩码引导图像生成)
[] 🛡 Turning the Spell Around: Lightweight Alignment Amplification via Rank-One Safety Injection(扭转局面:通过秩一安全注入实现轻量级对齐增强)
[] 🧠 Persuasion Dynamics in LLMs: Investigating Robustness and Adaptability in Knowledge and Safety with DuET-PD(大型语言模型中的说服动态:使用DuET-PD研究知识和安全方面的鲁棒性和适应性)
[] 💃 Dress&Dance: Dress up and Dance as You Like It - Technical Preview(着装与舞蹈:随心着装与舞蹈 - 技术预览)
[] 🎯 OnGoal: Tracking and Visualizing Conversational Goals in Multi-Turn Dialogue with Large Language Models(OnGoal:在大型语言模型多轮对话中跟踪和可视化对话目标)
[] 📷 Multi-View 3D Point Tracking(多视图3D点跟踪)
[] 🎭 FakeParts: a New Family of AI-Generated DeepFakes(FakeParts:一种新型AI生成的深度伪造家族)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟