H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
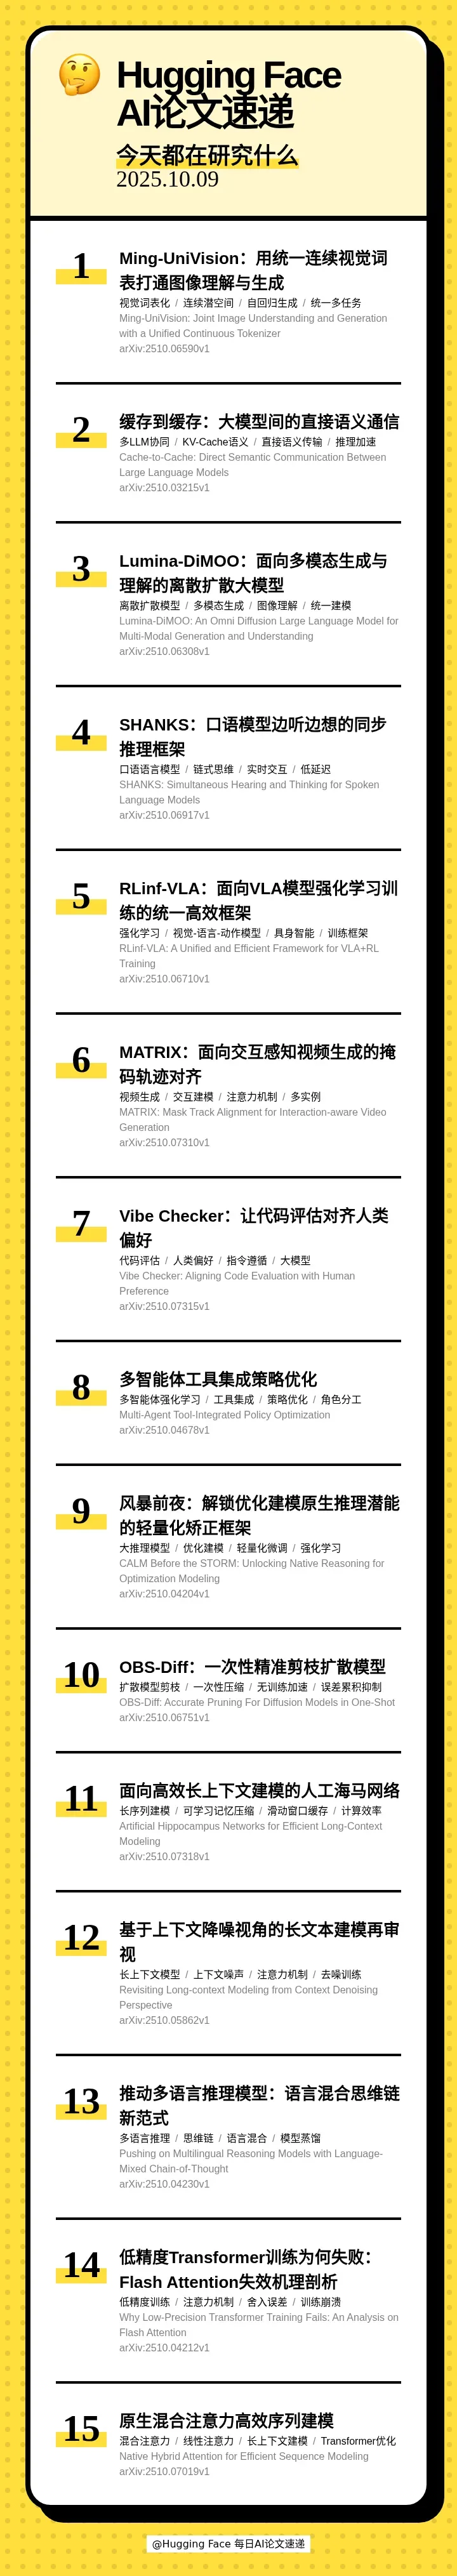
[] 🔄 Ming-UniVision: Joint Image Understanding and Generation with a Unified Continuous Tokenizer(Ming-UniVision:用统一连续视觉词表打通图像理解与生成)
[] 🧠 Cache-to-Cache: Direct Semantic Communication Between Large Language Models(缓存到缓存:大模型间的直接语义通信)
[] 🌀 Lumina-DiMOO: An Omni Diffusion Large Language Model for Multi-Modal Generation and Understanding(Lumina-DiMOO:面向多模态生成与理解的离散扩散大模型)
[] 🧠 SHANKS: Simultaneous Hearing and Thinking for Spoken Language Models(SHANKS:口语模型边听边想的同步推理框架)
[] 🤖 RLinf-VLA: A Unified and Efficient Framework for VLA+RL Training(RLinf-VLA:面向VLA模型强化学习训练的统一高效框架)
[] 🎬 MATRIX: Mask Track Alignment for Interaction-aware Video Generation(MATRIX:面向交互感知视频生成的掩码轨迹对齐)
[] 🎯 Vibe Checker: Aligning Code Evaluation with Human Preference(Vibe Checker:让代码评估对齐人类偏好)
[] 🤖 Multi-Agent Tool-Integrated Policy Optimization(多智能体工具集成策略优化)
[] 🧠 CALM Before the STORM: Unlocking Native Reasoning for Optimization Modeling(风暴前夜:解锁优化建模原生推理潜能的轻量化矫正框架)
[] ✂ OBS-Diff: Accurate Pruning For Diffusion Models in One-Shot(OBS-Diff:一次性精准剪枝扩散模型)
[] 🧠 Artificial Hippocampus Networks for Efficient Long-Context Modeling(面向高效长上下文建模的人工海马网络)
[] 🔍 Revisiting Long-context Modeling from Context Denoising Perspective(基于上下文降噪视角的长文本建模再审视)
[] 🧠 Pushing on Multilingual Reasoning Models with Language-Mixed Chain-of-Thought(推动多语言推理模型:语言混合思维链新范式)
[] 💥 Why Low-Precision Transformer Training Fails: An Analysis on Flash Attention(低精度Transformer训练为何失败:Flash Attention失效机理剖析)
[] ⚡ Native Hybrid Attention for Efficient Sequence Modeling(原生混合注意力高效序列建模)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 10 日 · 12 分钟
本期的 15 篇论文如下:
[] 🔄 Ming-UniVision: Joint Image Understanding and Generation with a Unified Continuous Tokenizer(Ming-UniVision:用统一连续视觉词表打通图像理解与生成)
[] 🧠 Cache-to-Cache: Direct Semantic Communication Between Large Language Models(缓存到缓存:大模型间的直接语义通信)
[] 🌀 Lumina-DiMOO: An Omni Diffusion Large Language Model for Multi-Modal Generation and Understanding(Lumina-DiMOO:面向多模态生成与理解的离散扩散大模型)
[] 🧠 SHANKS: Simultaneous Hearing and Thinking for Spoken Language Models(SHANKS:口语模型边听边想的同步推理框架)
[] 🤖 RLinf-VLA: A Unified and Efficient Framework for VLA+RL Training(RLinf-VLA:面向VLA模型强化学习训练的统一高效框架)
[] 🎬 MATRIX: Mask Track Alignment for Interaction-aware Video Generation(MATRIX:面向交互感知视频生成的掩码轨迹对齐)
[] 🎯 Vibe Checker: Aligning Code Evaluation with Human Preference(Vibe Checker:让代码评估对齐人类偏好)
[] 🤖 Multi-Agent Tool-Integrated Policy Optimization(多智能体工具集成策略优化)
[] 🧠 CALM Before the STORM: Unlocking Native Reasoning for Optimization Modeling(风暴前夜:解锁优化建模原生推理潜能的轻量化矫正框架)
[] ✂ OBS-Diff: Accurate Pruning For Diffusion Models in One-Shot(OBS-Diff:一次性精准剪枝扩散模型)
[] 🧠 Artificial Hippocampus Networks for Efficient Long-Context Modeling(面向高效长上下文建模的人工海马网络)
[] 🔍 Revisiting Long-context Modeling from Context Denoising Perspective(基于上下文降噪视角的长文本建模再审视)
[] 🧠 Pushing on Multilingual Reasoning Models with Language-Mixed Chain-of-Thought(推动多语言推理模型:语言混合思维链新范式)
[] 💥 Why Low-Precision Transformer Training Fails: An Analysis on Flash Attention(低精度Transformer训练为何失败:Flash Attention失效机理剖析)
[] ⚡ Native Hybrid Attention for Efficient Sequence Modeling(原生混合注意力高效序列建模)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟