H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
本期的 10 篇论文如下:
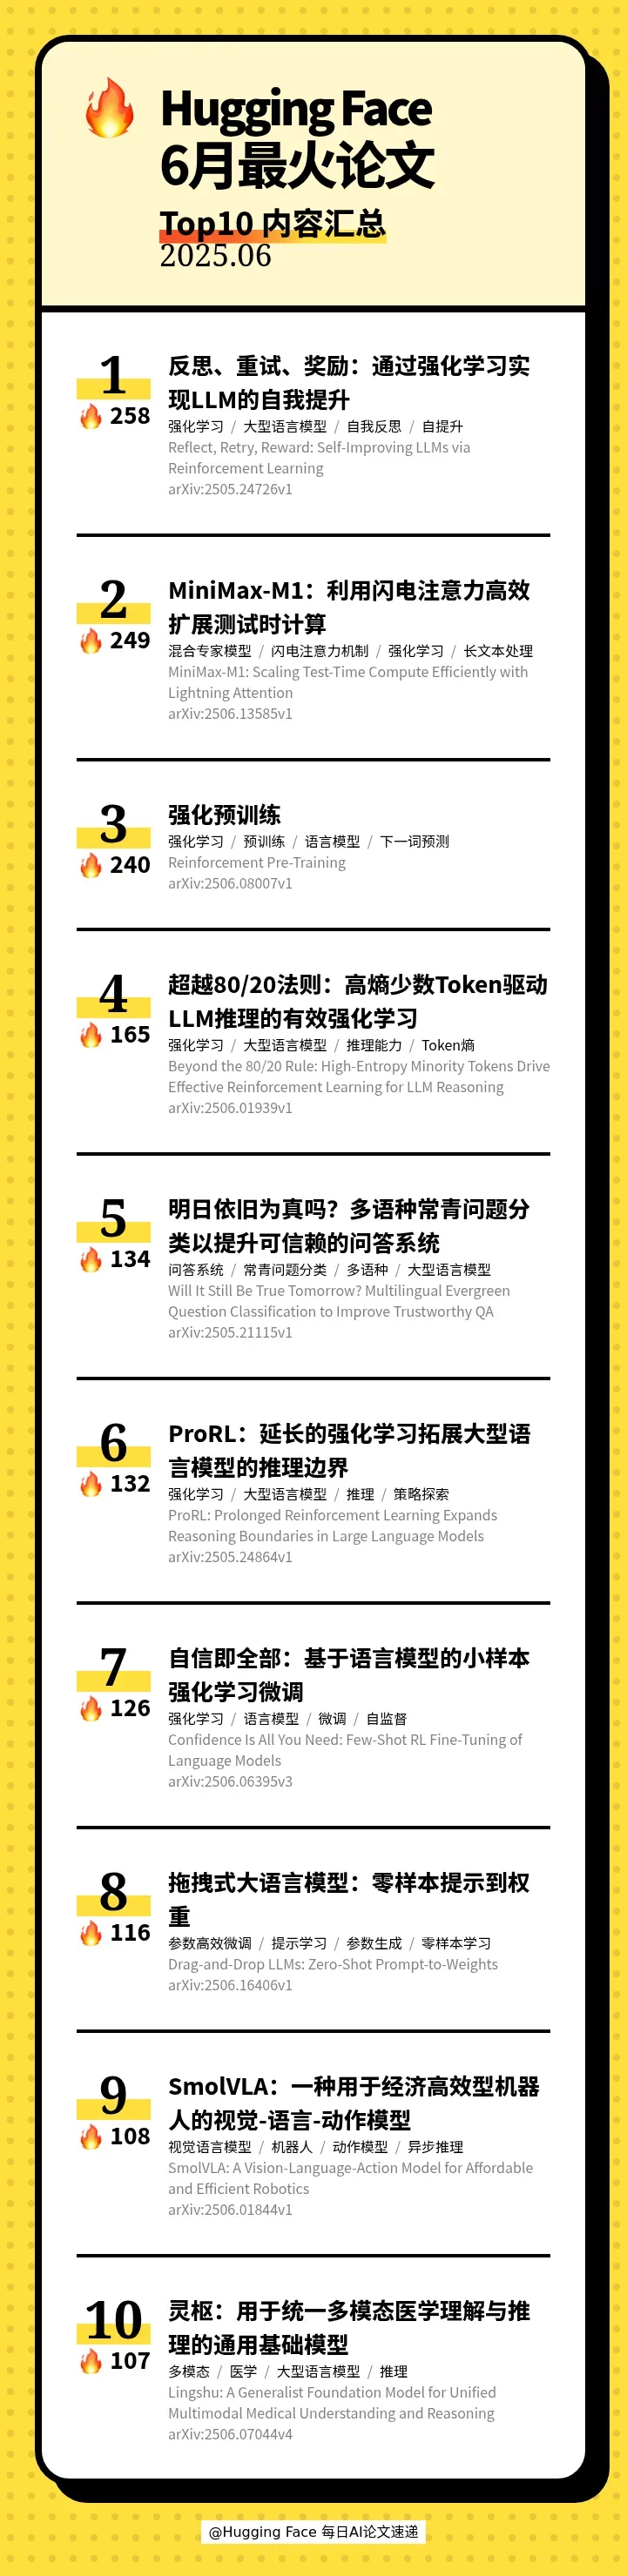
[] TOP1(🔥258) | 💡 Reflect, Retry, Reward: Self-Improving LLMs via Reinforcement Learning(反思、重试、奖励:通过强化学习实现LLM的自我提升)
[] TOP2(🔥249) | 💡 MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning Attention(MiniMax-M1:利用闪电注意力高效扩展测试时计算)
[] TOP3(🔥240) | 🤖 Reinforcement Pre-Training(强化预训练)
[] TOP4(🔥165) | 🧠 Beyond the 80/20 Rule: High-Entropy Minority Tokens Drive Effective Reinforcement Learning for LLM Reasoning(超越80/20法则:高熵少数Token驱动LLM推理的有效强化学习)
[] TOP5(🔥134) | 🕰 Will It Still Be True Tomorrow? Multilingual Evergreen Question Classification to Improve Trustworthy QA(明日依旧为真吗?多语种常青问题分类以提升可信赖的问答系统)
[] TOP6(🔥132) | 🧠 ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models(ProRL:延长的强化学习拓展大型语言模型的推理边界)
[] TOP7(🔥126) | 🧠 Confidence Is All You Need: Few-Shot RL Fine-Tuning of Language Models(自信即全部:基于语言模型的小样本强化学习微调)
[] TOP8(🔥116) | 🧲 Drag-and-Drop LLMs: Zero-Shot Prompt-to-Weights(拖拽式大语言模型:零样本提示到权重)
[] TOP9(🔥108) | 🤖 SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics(SmolVLA:一种用于经济高效型机器人的视觉-语言-动作模型)
[] TOP10(🔥107) | 🩺 Lingshu: A Generalist Foundation Model for Unified Multimodal Medical Understanding and Reasoning(灵枢:用于统一多模态医学理解与推理的通用基础模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟
HuggingFace 每日AI论文速递 · 2025 年 7 月 5 日 · 24 分钟
本期的 10 篇论文如下:
[] TOP1(🔥258) | 💡 Reflect, Retry, Reward: Self-Improving LLMs via Reinforcement Learning(反思、重试、奖励:通过强化学习实现LLM的自我提升)
[] TOP2(🔥249) | 💡 MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning Attention(MiniMax-M1:利用闪电注意力高效扩展测试时计算)
[] TOP3(🔥240) | 🤖 Reinforcement Pre-Training(强化预训练)
[] TOP4(🔥165) | 🧠 Beyond the 80/20 Rule: High-Entropy Minority Tokens Drive Effective Reinforcement Learning for LLM Reasoning(超越80/20法则:高熵少数Token驱动LLM推理的有效强化学习)
[] TOP5(🔥134) | 🕰 Will It Still Be True Tomorrow? Multilingual Evergreen Question Classification to Improve Trustworthy QA(明日依旧为真吗?多语种常青问题分类以提升可信赖的问答系统)
[] TOP6(🔥132) | 🧠 ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models(ProRL:延长的强化学习拓展大型语言模型的推理边界)
[] TOP7(🔥126) | 🧠 Confidence Is All You Need: Few-Shot RL Fine-Tuning of Language Models(自信即全部:基于语言模型的小样本强化学习微调)
[] TOP8(🔥116) | 🧲 Drag-and-Drop LLMs: Zero-Shot Prompt-to-Weights(拖拽式大语言模型:零样本提示到权重)
[] TOP9(🔥108) | 🤖 SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics(SmolVLA:一种用于经济高效型机器人的视觉-语言-动作模型)
[] TOP10(🔥107) | 🩺 Lingshu: A Generalist Foundation Model for Unified Multimodal Medical Understanding and Reasoning(灵枢:用于统一多模态医学理解与推理的通用基础模型)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟