H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 13 篇论文如下:
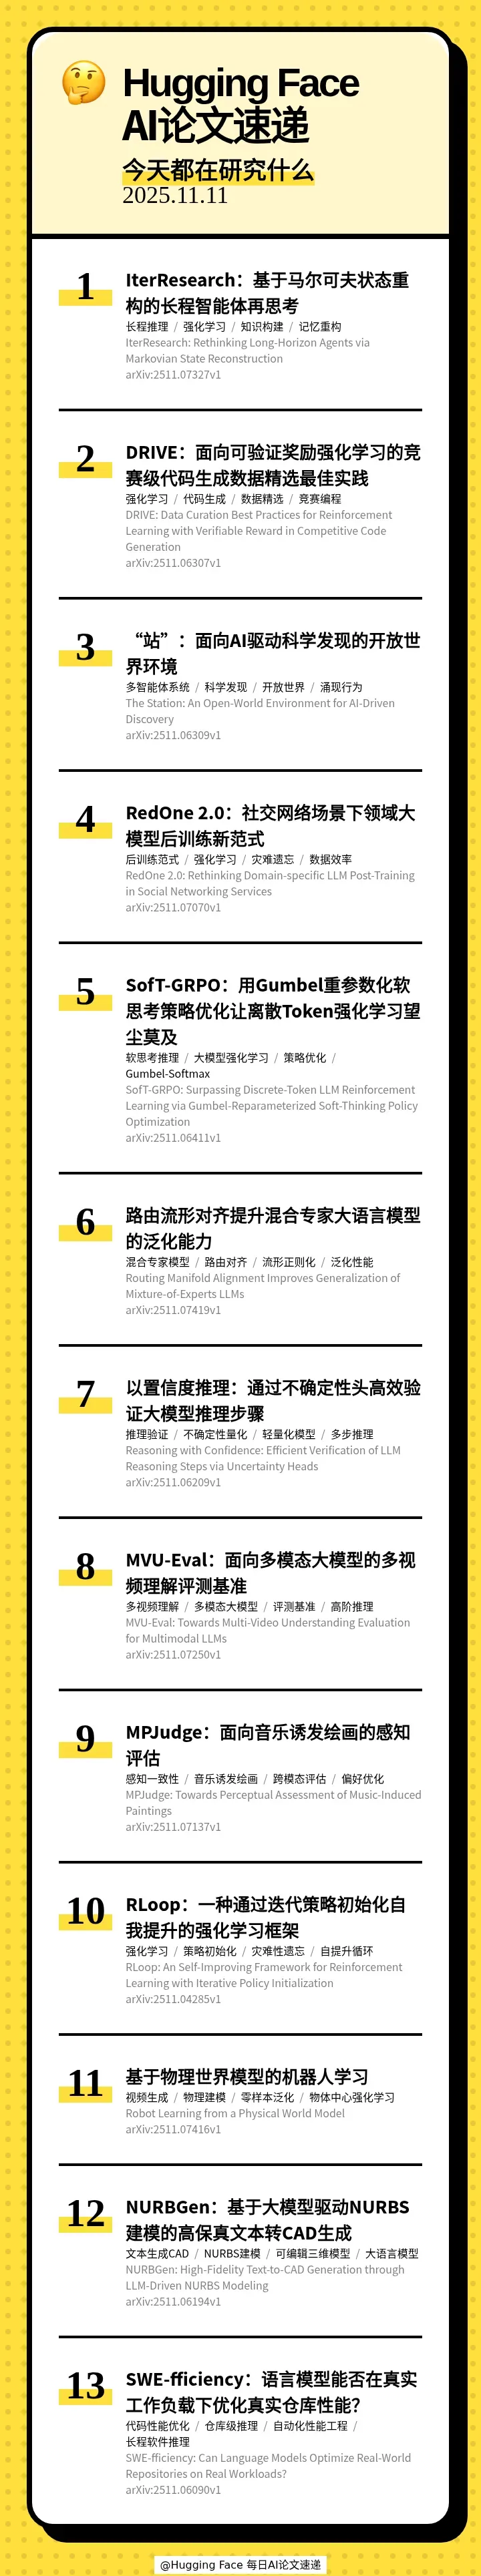
[] 🧩 IterResearch: Rethinking Long-Horizon Agents via Markovian State Reconstruction(IterResearch:基于马尔可夫状态重构的长程智能体再思考)
[] 🏆 DRIVE: Data Curation Best Practices for Reinforcement Learning with Verifiable Reward in Competitive Code Generation(DRIVE:面向可验证奖励强化学习的竞赛级代码生成数据精选最佳实践)
[] 🔬 The Station: An Open-World Environment for AI-Driven Discovery(“站”:面向AI驱动科学发现的开放世界环境)
[] 🚀 RedOne 2.0: Rethinking Domain-specific LLM Post-Training in Social Networking Services(RedOne 2.0:社交网络场景下领域大模型后训练新范式)
[] 🧠 SofT-GRPO: Surpassing Discrete-Token LLM Reinforcement Learning via Gumbel-Reparameterized Soft-Thinking Policy Optimization(SofT-GRPO:用Gumbel重参数化软思考策略优化让离散Token强化学习望尘莫及)
[] 🧭 Routing Manifold Alignment Improves Generalization of Mixture-of-Experts LLMs(路由流形对齐提升混合专家大语言模型的泛化能力)
[] 🔍 Reasoning with Confidence: Efficient Verification of LLM Reasoning Steps via Uncertainty Heads(以置信度推理:通过不确定性头高效验证大模型推理步骤)
[] 🎬 MVU-Eval: Towards Multi-Video Understanding Evaluation for Multimodal LLMs(MVU-Eval:面向多模态大模型的多视频理解评测基准)
[] 🎨 MPJudge: Towards Perceptual Assessment of Music-Induced Paintings(MPJudge:面向音乐诱发绘画的感知评估)
[] 🔄 RLoop: An Self-Improving Framework for Reinforcement Learning with Iterative Policy Initialization(RLoop:一种通过迭代策略初始化自我提升的强化学习框架)
[] 🤖 Robot Learning from a Physical World Model(基于物理世界模型的机器人学习)
[] 🛠 NURBGen: High-Fidelity Text-to-CAD Generation through LLM-Driven NURBS Modeling(NURBGen:基于大模型驱动NURBS建模的高保真文本转CAD生成)
[] 🚀 SWE-fficiency: Can Language Models Optimize Real-World Repositories on Real Workloads?(SWE-fficiency:语言模型能否在真实工作负载下优化真实仓库性能?)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 11 月 12 日 · 10 分钟
本期的 13 篇论文如下:
[] 🧩 IterResearch: Rethinking Long-Horizon Agents via Markovian State Reconstruction(IterResearch:基于马尔可夫状态重构的长程智能体再思考)
[] 🏆 DRIVE: Data Curation Best Practices for Reinforcement Learning with Verifiable Reward in Competitive Code Generation(DRIVE:面向可验证奖励强化学习的竞赛级代码生成数据精选最佳实践)
[] 🔬 The Station: An Open-World Environment for AI-Driven Discovery(“站”:面向AI驱动科学发现的开放世界环境)
[] 🚀 RedOne 2.0: Rethinking Domain-specific LLM Post-Training in Social Networking Services(RedOne 2.0:社交网络场景下领域大模型后训练新范式)
[] 🧠 SofT-GRPO: Surpassing Discrete-Token LLM Reinforcement Learning via Gumbel-Reparameterized Soft-Thinking Policy Optimization(SofT-GRPO:用Gumbel重参数化软思考策略优化让离散Token强化学习望尘莫及)
[] 🧭 Routing Manifold Alignment Improves Generalization of Mixture-of-Experts LLMs(路由流形对齐提升混合专家大语言模型的泛化能力)
[] 🔍 Reasoning with Confidence: Efficient Verification of LLM Reasoning Steps via Uncertainty Heads(以置信度推理:通过不确定性头高效验证大模型推理步骤)
[] 🎬 MVU-Eval: Towards Multi-Video Understanding Evaluation for Multimodal LLMs(MVU-Eval:面向多模态大模型的多视频理解评测基准)
[] 🎨 MPJudge: Towards Perceptual Assessment of Music-Induced Paintings(MPJudge:面向音乐诱发绘画的感知评估)
[] 🔄 RLoop: An Self-Improving Framework for Reinforcement Learning with Iterative Policy Initialization(RLoop:一种通过迭代策略初始化自我提升的强化学习框架)
[] 🤖 Robot Learning from a Physical World Model(基于物理世界模型的机器人学习)
[] 🛠 NURBGen: High-Fidelity Text-to-CAD Generation through LLM-Driven NURBS Modeling(NURBGen:基于大模型驱动NURBS建模的高保真文本转CAD生成)
[] 🚀 SWE-fficiency: Can Language Models Optimize Real-World Repositories on Real Workloads?(SWE-fficiency:语言模型能否在真实工作负载下优化真实仓库性能?)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟