H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
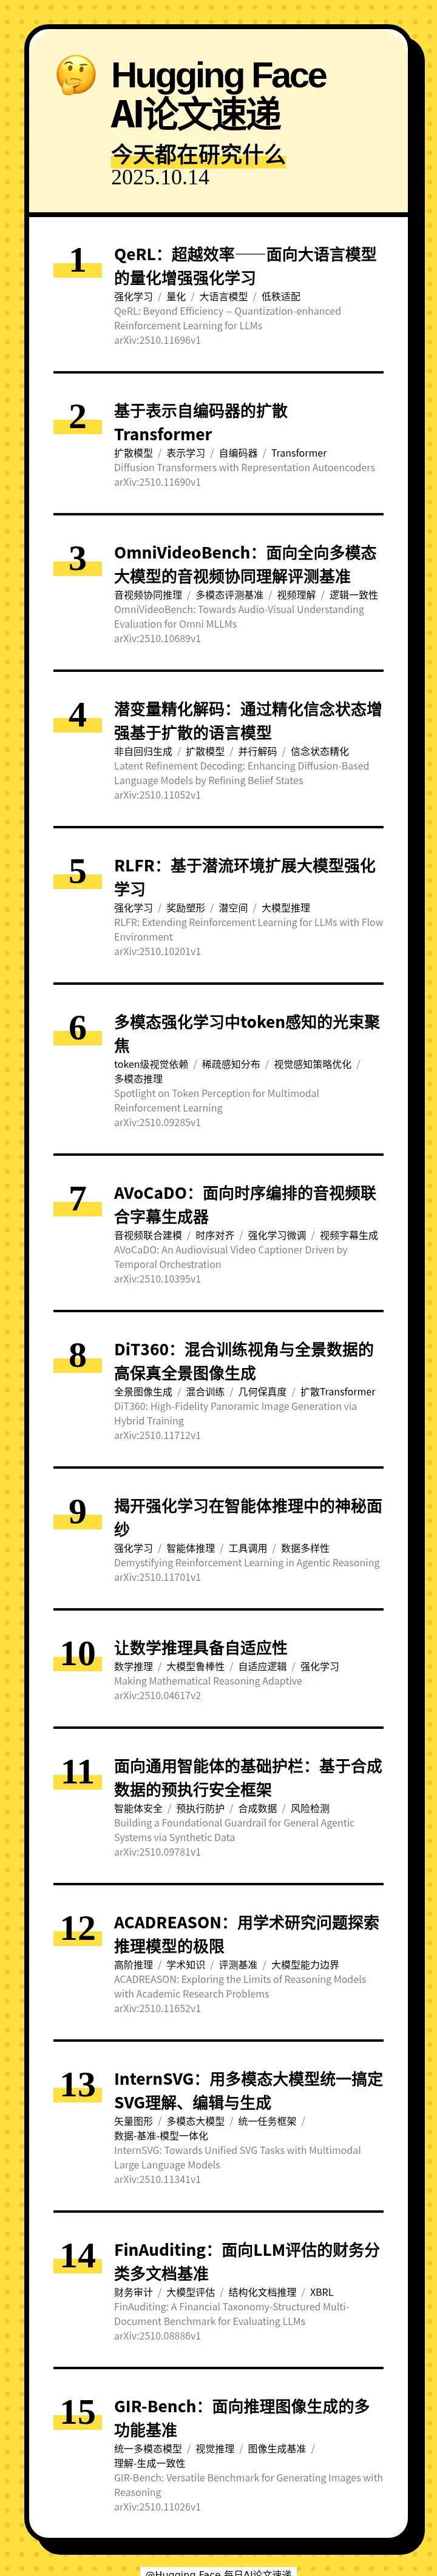
[] 🚀 QeRL: Beyond Efficiency -- Quantization-enhanced Reinforcement Learning for LLMs(QeRL:超越效率——面向大语言模型的量化增强强化学习)
[] 🧠 Diffusion Transformers with Representation Autoencoders(基于表示自编码器的扩散Transformer)
[] 🎬 OmniVideoBench: Towards Audio-Visual Understanding Evaluation for Omni MLLMs(OmniVideoBench:面向全向多模态大模型的音视频协同理解评测基准)
[] 🔄 Latent Refinement Decoding: Enhancing Diffusion-Based Language Models by Refining Belief States(潜变量精化解码:通过精化信念状态增强基于扩散的语言模型)
[] 🌊 RLFR: Extending Reinforcement Learning for LLMs with Flow Environment(RLFR:基于潜流环境扩展大模型强化学习)
[] 🔍 Spotlight on Token Perception for Multimodal Reinforcement Learning(多模态强化学习中token感知的光束聚焦)
[] 🎬 AVoCaDO: An Audiovisual Video Captioner Driven by Temporal Orchestration(AVoCaDO:面向时序编排的音视频联合字幕生成器)
[] 🌐 DiT360: High-Fidelity Panoramic Image Generation via Hybrid Training(DiT360:混合训练视角与全景数据的高保真全景图像生成)
[] 🧠 Demystifying Reinforcement Learning in Agentic Reasoning(揭开强化学习在智能体推理中的神秘面纱)
[] 🧮 Making Mathematical Reasoning Adaptive(让数学推理具备自适应性)
[] 🛡 Building a Foundational Guardrail for General Agentic Systems via Synthetic Data(面向通用智能体的基础护栏:基于合成数据的预执行安全框架)
[] 🧠 ACADREASON: Exploring the Limits of Reasoning Models with Academic Research Problems(ACADREASON:用学术研究问题探索推理模型的极限)
[] 🎨 InternSVG: Towards Unified SVG Tasks with Multimodal Large Language Models(InternSVG:用多模态大模型统一搞定SVG理解、编辑与生成)
[] 🧾 FinAuditing: A Financial Taxonomy-Structured Multi-Document Benchmark for Evaluating LLMs(FinAuditing:面向LLM评估的财务分类多文档基准)
[] 🧠 GIR-Bench: Versatile Benchmark for Generating Images with Reasoning(GIR-Bench:面向推理图像生成的多功能基准)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 15 日 · 11 分钟
本期的 15 篇论文如下:
[] 🚀 QeRL: Beyond Efficiency -- Quantization-enhanced Reinforcement Learning for LLMs(QeRL:超越效率——面向大语言模型的量化增强强化学习)
[] 🧠 Diffusion Transformers with Representation Autoencoders(基于表示自编码器的扩散Transformer)
[] 🎬 OmniVideoBench: Towards Audio-Visual Understanding Evaluation for Omni MLLMs(OmniVideoBench:面向全向多模态大模型的音视频协同理解评测基准)
[] 🔄 Latent Refinement Decoding: Enhancing Diffusion-Based Language Models by Refining Belief States(潜变量精化解码:通过精化信念状态增强基于扩散的语言模型)
[] 🌊 RLFR: Extending Reinforcement Learning for LLMs with Flow Environment(RLFR:基于潜流环境扩展大模型强化学习)
[] 🔍 Spotlight on Token Perception for Multimodal Reinforcement Learning(多模态强化学习中token感知的光束聚焦)
[] 🎬 AVoCaDO: An Audiovisual Video Captioner Driven by Temporal Orchestration(AVoCaDO:面向时序编排的音视频联合字幕生成器)
[] 🌐 DiT360: High-Fidelity Panoramic Image Generation via Hybrid Training(DiT360:混合训练视角与全景数据的高保真全景图像生成)
[] 🧠 Demystifying Reinforcement Learning in Agentic Reasoning(揭开强化学习在智能体推理中的神秘面纱)
[] 🧮 Making Mathematical Reasoning Adaptive(让数学推理具备自适应性)
[] 🛡 Building a Foundational Guardrail for General Agentic Systems via Synthetic Data(面向通用智能体的基础护栏:基于合成数据的预执行安全框架)
[] 🧠 ACADREASON: Exploring the Limits of Reasoning Models with Academic Research Problems(ACADREASON:用学术研究问题探索推理模型的极限)
[] 🎨 InternSVG: Towards Unified SVG Tasks with Multimodal Large Language Models(InternSVG:用多模态大模型统一搞定SVG理解、编辑与生成)
[] 🧾 FinAuditing: A Financial Taxonomy-Structured Multi-Document Benchmark for Evaluating LLMs(FinAuditing:面向LLM评估的财务分类多文档基准)
[] 🧠 GIR-Bench: Versatile Benchmark for Generating Images with Reasoning(GIR-Bench:面向推理图像生成的多功能基准)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟