H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 15 篇论文如下:
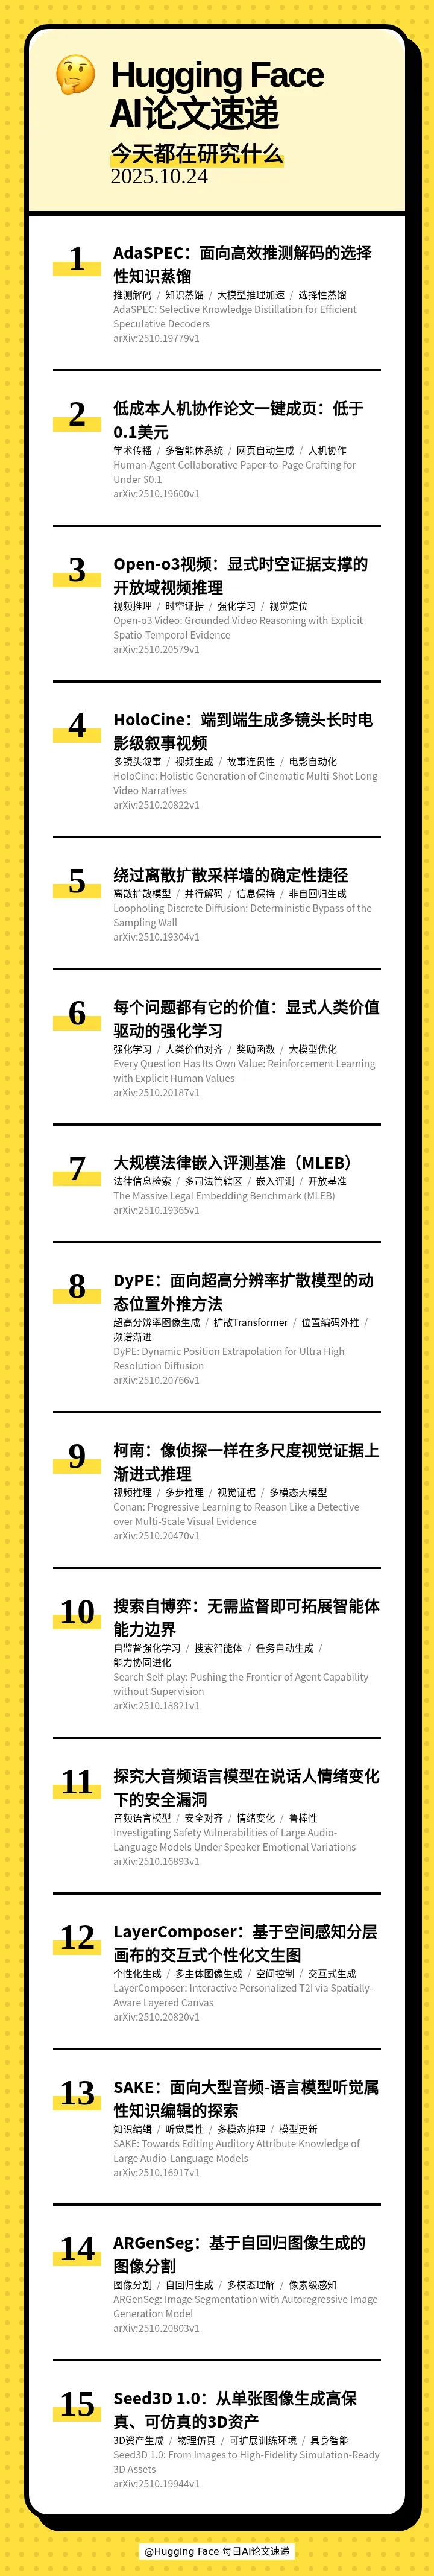
[] 🎯 AdaSPEC: Selective Knowledge Distillation for Efficient Speculative Decoders(AdaSPEC:面向高效推测解码的选择性知识蒸馏)
[] 🤖 Human-Agent Collaborative Paper-to-Page Crafting for Under $0.1(低成本人机协作论文一键成页:低于0.1美元)
[] 🔍 Open-o3 Video: Grounded Video Reasoning with Explicit Spatio-Temporal Evidence(Open-o3视频:显式时空证据支撑的开放域视频推理)
[] 🎬 HoloCine: Holistic Generation of Cinematic Multi-Shot Long Video Narratives(HoloCine:端到端生成多镜头长时电影级叙事视频)
[] 🌀 Loopholing Discrete Diffusion: Deterministic Bypass of the Sampling Wall(绕过离散扩散采样墙的确定性捷径)
[] 💎 Every Question Has Its Own Value: Reinforcement Learning with Explicit Human Values(每个问题都有它的价值:显式人类价值驱动的强化学习)
[] ⚖ The Massive Legal Embedding Benchmark (MLEB)(大规模法律嵌入评测基准(MLEB))
[] 🔍 DyPE: Dynamic Position Extrapolation for Ultra High Resolution Diffusion(DyPE:面向超高分辨率扩散模型的动态位置外推方法)
[] 🕵 Conan: Progressive Learning to Reason Like a Detective over Multi-Scale Visual Evidence(柯南:像侦探一样在多尺度视觉证据上渐进式推理)
[] 🤖 Search Self-play: Pushing the Frontier of Agent Capability without Supervision(搜索自博弈:无需监督即可拓展智能体能力边界)
[] 🎭 Investigating Safety Vulnerabilities of Large Audio-Language Models Under Speaker Emotional Variations(探究大音频语言模型在说话人情绪变化下的安全漏洞)
[] 🖼 LayerComposer: Interactive Personalized T2I via Spatially-Aware Layered Canvas(LayerComposer:基于空间感知分层画布的交互式个性化文生图)
[] 🎧 SAKE: Towards Editing Auditory Attribute Knowledge of Large Audio-Language Models(SAKE:面向大型音频-语言模型听觉属性知识编辑的探索)
[] 🖼 ARGenSeg: Image Segmentation with Autoregressive Image Generation Model(ARGenSeg:基于自回归图像生成的图像分割)
[] 🧩 Seed3D 1.0: From Images to High-Fidelity Simulation-Ready 3D Assets(Seed3D 1.0:从单张图像生成高保真、可仿真的3D资产)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 25 日 · 11 分钟
本期的 15 篇论文如下:
[] 🎯 AdaSPEC: Selective Knowledge Distillation for Efficient Speculative Decoders(AdaSPEC:面向高效推测解码的选择性知识蒸馏)
[] 🤖 Human-Agent Collaborative Paper-to-Page Crafting for Under $0.1(低成本人机协作论文一键成页:低于0.1美元)
[] 🔍 Open-o3 Video: Grounded Video Reasoning with Explicit Spatio-Temporal Evidence(Open-o3视频:显式时空证据支撑的开放域视频推理)
[] 🎬 HoloCine: Holistic Generation of Cinematic Multi-Shot Long Video Narratives(HoloCine:端到端生成多镜头长时电影级叙事视频)
[] 🌀 Loopholing Discrete Diffusion: Deterministic Bypass of the Sampling Wall(绕过离散扩散采样墙的确定性捷径)
[] 💎 Every Question Has Its Own Value: Reinforcement Learning with Explicit Human Values(每个问题都有它的价值:显式人类价值驱动的强化学习)
[] ⚖ The Massive Legal Embedding Benchmark (MLEB)(大规模法律嵌入评测基准(MLEB))
[] 🔍 DyPE: Dynamic Position Extrapolation for Ultra High Resolution Diffusion(DyPE:面向超高分辨率扩散模型的动态位置外推方法)
[] 🕵 Conan: Progressive Learning to Reason Like a Detective over Multi-Scale Visual Evidence(柯南:像侦探一样在多尺度视觉证据上渐进式推理)
[] 🤖 Search Self-play: Pushing the Frontier of Agent Capability without Supervision(搜索自博弈:无需监督即可拓展智能体能力边界)
[] 🎭 Investigating Safety Vulnerabilities of Large Audio-Language Models Under Speaker Emotional Variations(探究大音频语言模型在说话人情绪变化下的安全漏洞)
[] 🖼 LayerComposer: Interactive Personalized T2I via Spatially-Aware Layered Canvas(LayerComposer:基于空间感知分层画布的交互式个性化文生图)
[] 🎧 SAKE: Towards Editing Auditory Attribute Knowledge of Large Audio-Language Models(SAKE:面向大型音频-语言模型听觉属性知识编辑的探索)
[] 🖼 ARGenSeg: Image Segmentation with Autoregressive Image Generation Model(ARGenSeg:基于自回归图像生成的图像分割)
[] 🧩 Seed3D 1.0: From Images to High-Fidelity Simulation-Ready 3D Assets(Seed3D 1.0:从单张图像生成高保真、可仿真的3D资产)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟