H
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟

本期的 14 篇论文如下:
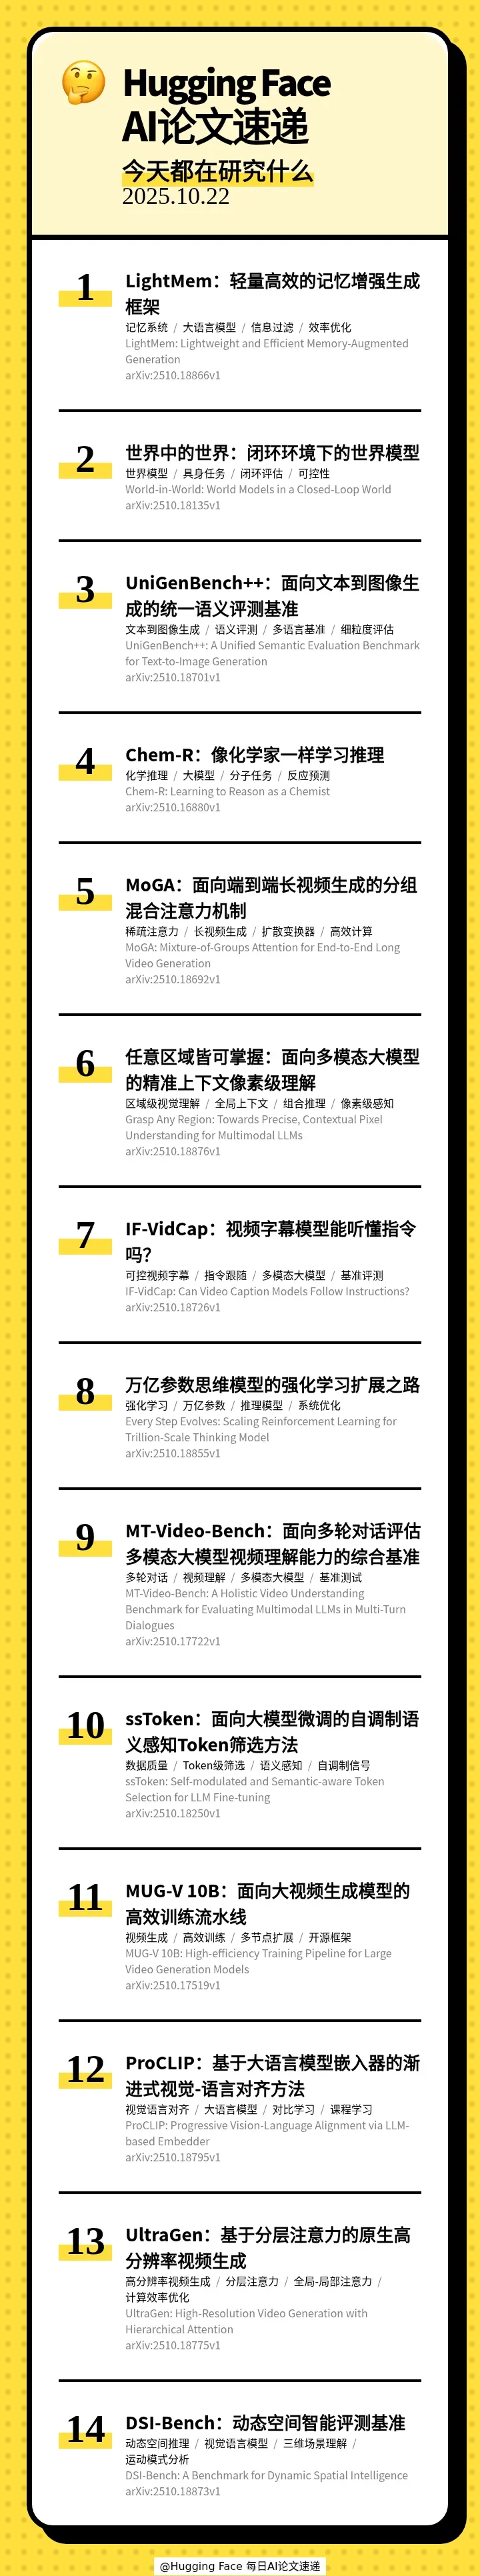
[] 🧠 LightMem: Lightweight and Efficient Memory-Augmented Generation(LightMem:轻量高效的记忆增强生成框架)
[] 🌀 World-in-World: World Models in a Closed-Loop World(世界中的世界:闭环环境下的世界模型)
[] 🖼 UniGenBench++: A Unified Semantic Evaluation Benchmark for Text-to-Image Generation(UniGenBench++:面向文本到图像生成的统一语义评测基准)
[] 🧪 Chem-R: Learning to Reason as a Chemist(Chem-R:像化学家一样学习推理)
[] 🎬 MoGA: Mixture-of-Groups Attention for End-to-End Long Video Generation(MoGA:面向端到端长视频生成的分组混合注意力机制)
[] 🔍 Grasp Any Region: Towards Precise, Contextual Pixel Understanding for Multimodal LLMs(任意区域皆可掌握:面向多模态大模型的精准上下文像素级理解)
[] 🎬 IF-VidCap: Can Video Caption Models Follow Instructions?(IF-VidCap:视频字幕模型能听懂指令吗?)
[] 🚀 Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model(万亿参数思维模型的强化学习扩展之路)
[] 🎬 MT-Video-Bench: A Holistic Video Understanding Benchmark for Evaluating Multimodal LLMs in Multi-Turn Dialogues(MT-Video-Bench:面向多轮对话评估多模态大模型视频理解能力的综合基准)
[] 🧠 ssToken: Self-modulated and Semantic-aware Token Selection for LLM Fine-tuning(ssToken:面向大模型微调的自调制语义感知Token筛选方法)
[] 🎬 MUG-V 10B: High-efficiency Training Pipeline for Large Video Generation Models(MUG-V 10B:面向大视频生成模型的高效训练流水线)
[] 🎯 ProCLIP: Progressive Vision-Language Alignment via LLM-based Embedder(ProCLIP:基于大语言模型嵌入器的渐进式视觉-语言对齐方法)
[] 🎬 UltraGen: High-Resolution Video Generation with Hierarchical Attention(UltraGen:基于分层注意力的原生高分辨率视频生成)
[] 🔄 DSI-Bench: A Benchmark for Dynamic Spatial Intelligence(DSI-Bench:动态空间智能评测基准)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟
【月末特辑】10月最火AI论文 | 把经验变成预见;让音画同步生成
11 月 7 日 · 13 分钟

HuggingFace 每日AI论文速递 · 2025 年 10 月 23 日 · 11 分钟
本期的 14 篇论文如下:
[] 🧠 LightMem: Lightweight and Efficient Memory-Augmented Generation(LightMem:轻量高效的记忆增强生成框架)
[] 🌀 World-in-World: World Models in a Closed-Loop World(世界中的世界:闭环环境下的世界模型)
[] 🖼 UniGenBench++: A Unified Semantic Evaluation Benchmark for Text-to-Image Generation(UniGenBench++:面向文本到图像生成的统一语义评测基准)
[] 🧪 Chem-R: Learning to Reason as a Chemist(Chem-R:像化学家一样学习推理)
[] 🎬 MoGA: Mixture-of-Groups Attention for End-to-End Long Video Generation(MoGA:面向端到端长视频生成的分组混合注意力机制)
[] 🔍 Grasp Any Region: Towards Precise, Contextual Pixel Understanding for Multimodal LLMs(任意区域皆可掌握:面向多模态大模型的精准上下文像素级理解)
[] 🎬 IF-VidCap: Can Video Caption Models Follow Instructions?(IF-VidCap:视频字幕模型能听懂指令吗?)
[] 🚀 Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model(万亿参数思维模型的强化学习扩展之路)
[] 🎬 MT-Video-Bench: A Holistic Video Understanding Benchmark for Evaluating Multimodal LLMs in Multi-Turn Dialogues(MT-Video-Bench:面向多轮对话评估多模态大模型视频理解能力的综合基准)
[] 🧠 ssToken: Self-modulated and Semantic-aware Token Selection for LLM Fine-tuning(ssToken:面向大模型微调的自调制语义感知Token筛选方法)
[] 🎬 MUG-V 10B: High-efficiency Training Pipeline for Large Video Generation Models(MUG-V 10B:面向大视频生成模型的高效训练流水线)
[] 🎯 ProCLIP: Progressive Vision-Language Alignment via LLM-based Embedder(ProCLIP:基于大语言模型嵌入器的渐进式视觉-语言对齐方法)
[] 🎬 UltraGen: High-Resolution Video Generation with Hierarchical Attention(UltraGen:基于分层注意力的原生高分辨率视频生成)
[] 🔄 DSI-Bench: A Benchmark for Dynamic Spatial Intelligence(DSI-Bench:动态空间智能评测基准)
【关注我们】
您还可以在以下平台找到我们,获得播客内容以外更多信息
小红书: AI速递
说明里标出的时间点,点一下跳过去

面向中文AI从业者与爱好者的每日AI论文速递,工作日高密度速览前沿论文,月末以月度热门论文特辑补充,形成每日速递加月末特…
已收录 739 期 · 最近更新 11 月 10 日
https://feed.xyzfm.space/7jtt3j3lbbra复制内容版权归创作者,声湃按创作者开放的 RSS 收录。了解收录与 RSS →
2026.11.09 | 高斯间距校准跨场景重建;参数先验加速多教师蒸馏
11 月 10 日 · 11 分钟
【周末特辑】11月第2周最火AI论文 | 图形智能体的设计空间;错峰去噪生成视频
11 月 8 日 · 11 分钟
2026.11.06 | 视觉规划整块解码;借兄弟框架练智能体
11 月 7 日 · 9 分钟